5.3 端侧大模型部署复盘
5.3 端侧大模型部署复盘
本节摘要:一次完整的项目复盘:在一台无独显的边缘盒子上部署对话模型,目标离线问答、首字两秒内、持续生成不低于每秒十个词。本节按「约束、选型、压缩、实测、踩坑」还原全过程,所有数字与判断依据均可复现。
前面两节给了零件与原理,这一节把它们装配成一次真实交付。选择端侧对话这个场景,是因为它把本书几乎所有决策点都逼了出来:设备怎么选、模型怎么压、延迟怎么拆、精度怎么验——完整走一遍,方法就内化了。
项目背景与硬约束
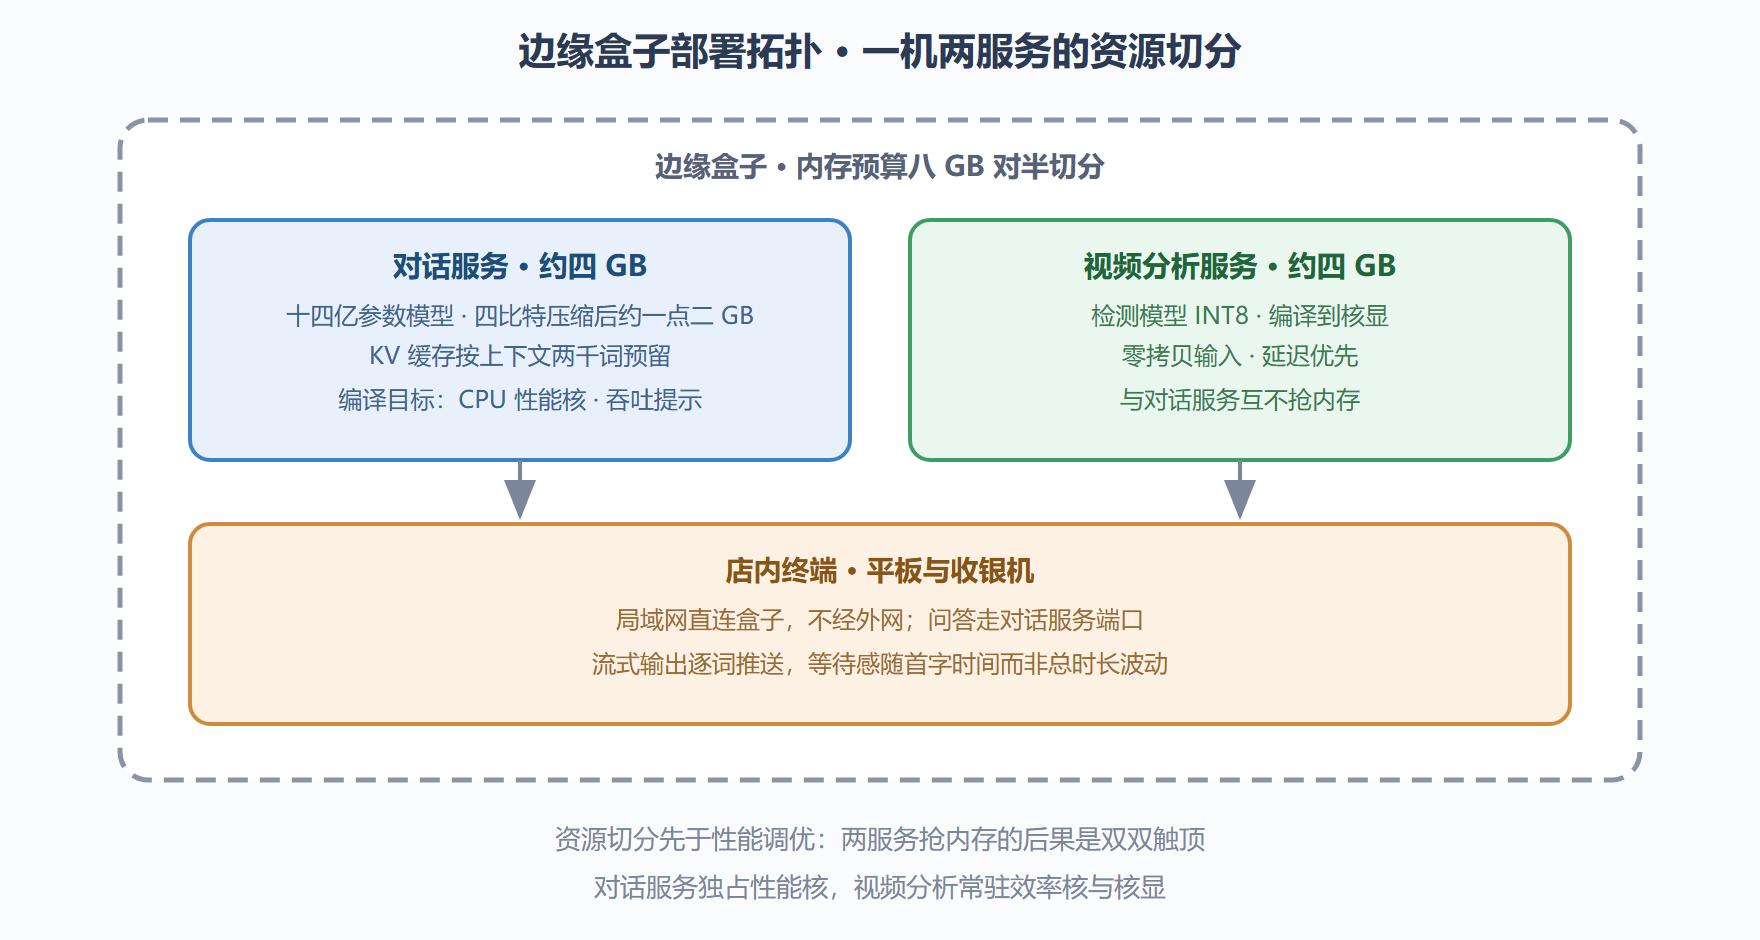
需求来自一套离线知识助手:部署在门店的边缘盒子(无独显,中档酷睿加核显),断网可用,服务店员的产品咨询问答。三条硬约束由业务方与现场共同敲定:首字延迟两秒以内(等待感阈值);持续生成不低于每秒十个词(低于此速率阅读会卡顿);内存预算八 GB(盒子还要跑视频分析服务,内存要对半分)。
约束先行是本书的一贯立场:先定验收数字,再倒推技术路线——顺序反了,项目就会在「差不多了」的幻觉里漂着。
图 5-3 端侧部署拓扑与数据流向
选型:三步收敛到目标模型
模型选型按「能力、体积、许可」三步过滤。能力上,问答任务不需要旗舰模型的创造力,但需要稳定的事实性与中文理解——候选取社区主流的小尺寸对话模型,参数量从十八亿到七十亿一档;体积上,八 GB 预算减去系统与视频服务占用,留给对话服务的上限约四 GB,直接排除七十亿 FP16(十四 GB 起步);许可上,确认所选模型允许商用部署。
收敛到十四亿与二十四亿两个候选,各准备一份 INT8 与一份 INT4 权重压缩版本,用 5.2 节的接口生成。候选矩阵四个组合,全部实测再拍板——模型选型不做纸面推演。
压缩与实测:数字定案
在同一台盒子上跑完整测试集(三百条业务问答,人工评级「可用、勉强、不可用」三档),关键数字如下:
| 配置 | 常驻内存 | 首字延迟 | 生成速率 | 可用率 |
|---|---|---|---|---|
| 十四亿 · INT8 | 约 2.1 GB | 0.9 秒 | 19.6 词每秒 | 88% |
| 十四亿 · INT4 | 约 1.3 GB | 0.7 秒 | 24.1 词每秒 | 84% |
| 二十四亿 · INT8 | 约 3.2 GB | 1.6 秒 | 11.8 词每秒 | 93% |
| 二十四亿 · INT4 | 约 2.0 GB | 1.2 秒 | 15.2 词每秒 | 89% |
四行数字与两条约束交叉,决策一眼可见:十四亿 INT4 全指标达标但可用率偏低;二十四亿 INT4 首字 1.2 秒、速率 15.2,两条硬约束全过,可用率 89% 也可接受。最终选二十四亿 INT4——内存余量还给了后续上下文加长留了空间。速度最慢的一格(二十四亿 INT8)恰好贴着速率红线,再次验证了 5.2 节的判断:解码速率是带宽问题,压权重是最直接的解法。
踩坑记录与两条教训
坑一出在多服务资源竞争:初版部署后首字延迟飘到三秒开外,排查半天发现是视频分析服务的核显编译把共享内存带宽吃紧,对话服务的预填充被拖慢。解法不是调参而是资源切分——对话服务绑定性能核、视频服务绑定效率核与核显,内存配额写入服务启动配置,互抢变各管。
坑二出在长对话内存泄漏感:运行一天后响应变慢。根因是会话对象没有及时释放,KV 缓存积压。给会话加上限长与空闲回收后恢复稳定。教训写成两条守则:端侧部署必须按「共存服务」设计资源,按「长时间运行」设计生命周期——demo 里不存在的两个变量,生产里全是事。
评测集怎么建:三百条问答的来历
复盘里的「三百条业务问答」值得展开来历,因为评测集质量直接决定选型可信度。构成上分三块:一百八十条来自客服记录的真实问题脱敏改写(保真),六十条由业务专家按「店员真实会怎么问」补写(补盲),六十条故意设置的对抗样本——错别字、口语化、指代不明(压力测试)。标注采用双人独立评级,分歧样本第三方仲裁。这套建法的成本约三个人日,换来的是「可选率 89%」这个数字的业务含金量——换一份随手拼的五十条评测集,同样的模型可能评出完全不同的排序。选型阶段的评测集投入,是全项目杠杆率最高的人力开销。
首字延迟的逐段拆解
「首字两秒」达标后,我们做了一次逐段拆解,把 1.2 秒花在哪晒出来:提示词分词与组装约五十毫秒,预填充前向约八百毫秒,缓存装载与首个采样约两百毫秒,流式链路与前端渲染约一百五十毫秒。拆解的价值在指导后续优化方向:预填充占六成七,下一步优化空间在提示瘦身(5.2 节的杠杆);前端渲染占一成三,比预想的重,原因是逐词刷新触发了整页重绘——前端同学改成增量追加后砍到三十毫秒。这个拆解还有一个团队沟通作用:每个环节的负责人拿到自己的数字,优化从「后端的事」变成全链路的事。任何延迟验收,都建议在达标后再做一次这样的拆解归档,它是下一轮优化的地图。
变式推演:如果约束再苛刻一档
复盘的价值随变式推演放大。假如业务的内存预算从八 GB 压到四 GB,路线怎么变?候选矩阵直接重算:二十四亿 INT4 的一点二 GB 权重加运行余量仍可容纳,但 KV 缓存配额腰斩,上下文上限从四千词收到两千——用能力换容量,需要业务方签字。假如速率要求提到每秒二十词?二十四亿 INT4 的十五点二不再达标,要么降级到十四亿 INT4(二十四点一,但可用率掉五个点),要么换算力更好的盒子(重新走设备选型)。两条变式的推演都指向同一件事:约束参数是联动的,改一条要全盘重算。把候选矩阵当活文档维护,业务方提出新约束时,一小时内就能给出量化的方案对比——这就是复盘产物在下一个项目里的复用形态。
风险登记表:上线前的最后清单
复盘的最后补一份上线前风险登记,它把这些坑提炼成检查项。一,共存服务内存复核:所有服务的峰值内存之和乘以一点二的安全系数,必须小于物理内存——分子算峰值不算均值,分母留余量不留侥幸。二,断电恢复演练:边缘设备断电重启后,对话服务与视频服务是否自动拉起、模型缓存是否自动重建,演练一遍再上。三,会话上限压测:模拟最长对话加最多并发会话,观察内存曲线是否平稳有界。四,温度与季节余量:夏季高温下的持续负载测试,频率回落后的速率是否仍过验收线。五,回滚预案:模型或配置更新出问题时的退回路径,手工演练一次。五项全部打勾的部署才算「生产就绪」——这份清单与 6.2 节的八项服务化清单合流,就是端侧大模型项目的完整上线门禁。
从这单复盘看端侧大模型的成本结构
把复盘再往上抽一层,看钱花在哪。开发侧的大头不是模型而是验证:候选矩阵实测、三百条评测集、两周灰度,人力投入约占项目六成——端侧大模型项目的「贵」贵在验证而非算力。运行侧的大头不是电力而是运维:会话回收、内存水位、模型更新的灰度推送,日常巡检项比传统视觉服务多出一倍。这两笔账对立项的意义直接:评估「要不要上端侧大模型」时,把验证人力与运维增项计入总成本,再与云端按量费用对比——不少场景算完总账后,「边缘盒子加小模型」与「云端加中模型」的差距会小到值得重新权衡。成本结构清楚了,拓扑选型(第 6 章)才有可靠的输入。
本节要点回顾
- 约束先行:首字、速率、内存三条数字验收线定了,选型路线自动收窄。
- 候选矩阵实测拍板:两个模型乘两种压缩,四个组合全部真机跑完再决策,不纸面推演。
- 资源切分先于调优:共存服务各管各的核与内存配额,抢资源的问题调参救不了。
- 生命周期按天设计:会话回收、缓存上限、长时间运行的内存账,demo 与生产隔着这些细节。
大模型这条支线走完,下一章回到工程落地的主干道:多语言绑定、服务化、边缘与云端拓扑,以及一条完整的视频结构化流水线——把模型送进真实业务系统的最后一程。