2.3 梯形图与ST对照实验
2.3 梯形图与ST对照实验
本节摘要:青线没有让语言之争停在立场上:选一段真实的输送互锁逻辑,梯形图与结构化文本各实现一遍,再做一次"新增联锁条件"的变更实验,从实现耗时、评审通过率、变更影响面、版本比对可读性四个维度量化对比。实验结论支撑了全项目的语言策略。
本章支柱页里那场不欢而散的会后,电气主管与新同事各让一步:同意用一段真实逻辑做实验,用数据说话。这一节就是那场实验的完整复盘——它的价值不在结论本身,而在实验设计:任何团队遇到类似争论,都可以照这个框架自己跑一遍。
实验设计:一支笔写两遍
选材讲究代表性。我们选了青线一号新增输送段的互锁链:本段启动需要上游段运行、下游无堵料、急停回路健康、就地选择开关在自动位,四个条件串联;停车则任一条件不满足即停,并带一段停止延时让瓶走空。逻辑规模适中——纯布尔加一个定时器,两种语言都无短板,胜负完全取决于表达与维护方式而非语言能力差异。
两名工程师分别实现,要求相同:变量命名遵循同一规范、带注释、通过仿真验证。计时从拿到需求到仿真通过为止。实现阶段的结果:梯形图四十七分钟,ST三十九分钟——差距不大,都在误差范围。真正拉开差距的是后面的变更环节。
图 2-3:同一段互锁逻辑的两种表达
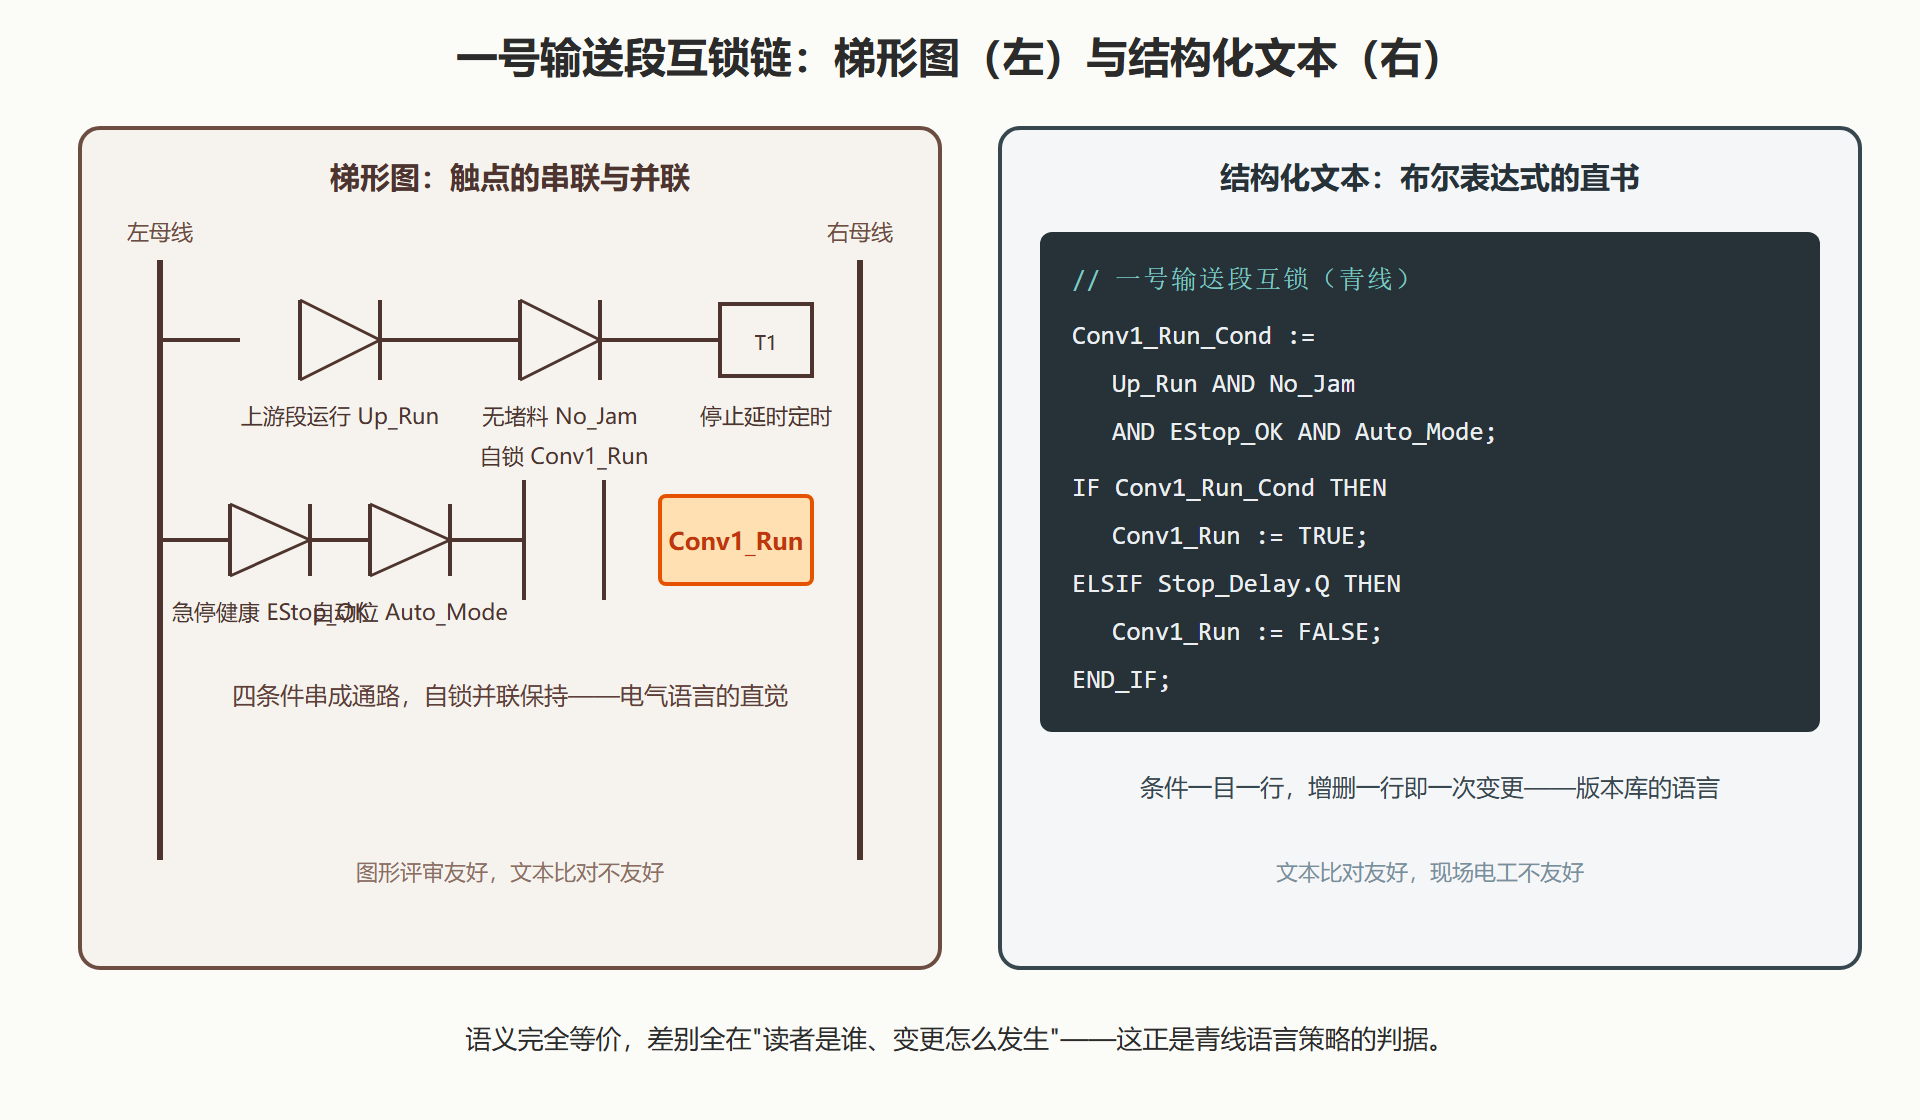
变更实验:加一条联锁条件
实现打平之后,我们模拟真实运维:工艺提出变更——输送段启动前必须确认下游暂存仓未满(新增一个条件),并且要求变更在一周内走完评审、修改、仿真验证全流程。
ST侧的变更量:布尔表达式里插入一行AND Bin_Not_Full,加上注释与仿真用例更新,合计十八分钟。版本比对工具里,变更显示为清晰的一行增删,评审人三十秒定位改动点。
梯形图侧的变更量:在已经四层触点堆叠的支路里插入一副触点,重新排布支路布局避免连线交叉,同时更新图纸注释,合计五十五分钟。更麻烦的是比对:图形程序的差异在文本工具里几乎不可读,评审人只能在图形编辑器里打开新旧两版肉眼对照,评审时间比ST版多出近一倍。
| 维度 | 梯形图 | 结构化文本 | 备注 |
|---|---|---|---|
| 首次实现 | 47分钟 | 39分钟 | 简单布尔逻辑,差距不大 |
| 加一条联锁 | 55分钟 | 18分钟 | 图形重排是主要开销 |
| 版本差异可读性 | 差,需图形工具对照 | 好,文本逐行比对 | 对变更评审影响最大 |
| 现场人员可读性 | 好 | 需培训 | 电工团队反馈 |
| 复用到相似设备 | 复制后改触点 | 复制后改表达式 | 均不如功能块,见第4章 |
解读:争论为什么不该二选一
实验数据一出,会议室的气氛反而松了——因为答案变成了分工:现场要读的联锁用梯形图,版本库里频繁演进的条件逻辑用ST。一号线最终把互锁链写成ST布尔表达式、把启停按钮回路保留梯形图,两种语言在同一程序里各司其职,双方都觉得自己赢了一半。更重要的是,双方共同签认了实验报告——从此项目的语言评审有了先例可引,类似争论再没开过第二次会。
实验也有边界,如实记录:其一,样本是一段中型布尔逻辑,若换成配方折算这类运算,梯形图的开销会大得多,ST优势会进一步放大;其二,评审时间的差异依赖团队工具习惯,若图形差异工具用得熟,差距会收窄;其三,可读性的"受众"因素被有意计入——青线的电工团队梯形图熟练度极高,这个前提换个团队就要重估。把边界写清楚,实验结论才可迁移。
两次复测:把结论放到别的题型上
一次实验说明不了语言差异的全貌,我们随后做了两组复测,把结论的适用边界摸清。
复测一换题型:把"配方折算"——按瓶型查表取单瓶灌装量、乘以温度补偿系数、四舍五入到阀门脉冲数——分别用两种语言实现。这次没有悬念:梯形图实现耗时两小时四十分钟,中间因查表逻辑绕晕重画两次;ST实现四十分钟,循环查表加四则运算一气呵成。数值运算题上,梯形图的书写模型全面吃力,比互锁题的差距大了一个量级。这组复测把 2.2 节矩阵里"算法选ST"从经验判断坐实为实测结论。
复测二换受众:把两版互锁程序分别拿给三名电工与三名新入职工程师阅读,五分钟后请其口述逻辑。电工组对梯形图版全部复述正确,对ST版两人读错;新工程师组正好相反。受众差异实锤——同一份逻辑的"可读性"不是代码的属性,是代码与读者匹配度的属性。这直接支持了青线按受众分语言的做法:联锁逻辑的读者是电工,就用电工的语言写。
实验数据怎么带进你的项目
青线这套实验的成本很低——两个半天、两段真实逻辑、四张数据表——任何团队都能复刻,而且复刻本身就有收益:争论从立场问题变成测量问题,输的人输给数据而不是输给资历,执行时没有怨气。如果你所在团队正在经历类似争论,建议照抄框架,只换实验材料:选你们代码库里最常被修改的那段逻辑当考题,那才是变更成本真实发生的地方。
补一句实验没测但实践里反复验证的判断:无论选哪种语言,命名与注释规范对可维护性的影响都不小于语言本身。青线实验里两版代码都强制同一命名规范,才使对比公平——假如ST版变量名是随意的缩写,复测二的受众成绩会反转。语言决定表达的下限,规范决定表达的上限。
三个高频疑问
问:实验样本只有一个逻辑、两个团队,结论可信吗? 单次结论当然不能外推为普适定律,但"变更耗时差三倍"这个量级与业界普遍经验一致。青线的用法是取其方向而非数值:方向是"频繁变更的条件逻辑偏向文本语言、现场受众主导的逻辑偏向图形语言"。你的团队如果有疑虑,恰好说明该自己跑一遍实验。
问:混合语言会不会让工程更乱? 混而不乱的前提是场景边界清晰、规范统一。青线把"什么场景用什么语言"写进编码规范第二章,变量命名、注释格式全项目一致;乱的不是多语言,是多语言加无规范。
问:让电工学ST、让程序员学梯形图,不值得吗? 值得但顺序有讲究。先按受众把语言放对位置,保证当下交付质量;再在维护与改造的真实需求里互相渗透。青线两年下来,电工能读懂ST布尔表达式,程序员也画得一手规整梯形图——渗透是交付的副产品,不是前置条件。
复盘实验本身的方法论
把这场实验当模板复用时,有几处设计细节决定成败,值得单独交代。选材上,考题必须来自你们自己的代码库且变更频率真实——用教科书例题跑实验,得到的只是"语言的一般性质",不是"我们项目的成本结构"。计时上,首次实现与变更实验要分开计时,混在一起会互相污染——首次实现反映书写效率,变更实验反映维护成本,两者的结论经常相反。受众测试上,读者群体要抽样真实维护者而非项目成员——项目成员对代码的熟悉度会掩盖可读性差异。
还有一条常被忽略的:实验结果要有"无效条件"预设。假如两种语言的差距小于两成,结论应当是"此场景语言不敏感,按团队习惯选"——不是每次实验都会产出戏剧性差异,承认语言不敏感的场景,比强行宣布胜负更有工程价值。青线那次实验里,首次实现的九分钟差距就属于此类,我们在报告里如实标注"不显著"。
本节要点回顾
- 实验框架可复用:选代表性逻辑、双语言各写一遍、真实变更演练,四个维度量化;
- 实现差距小、变更差距大:简单逻辑两者打平,变更时梯形图的图形重排成本显著;
- 版本比对是隐形战场:文本差异清晰、图形差异模糊,评审效率由此拉开;
- 结论是分工不是胜负:按"读者是谁、变更频率如何"分配语言,而不是全押一种。
语言选型齐了,还差最后一层组织术:这么多程序块、任务和语言,怎么装进一个不乱的工程?下一节讲软件模型。