1.3 第一个话题收发排错实录
1.3 第一个话题收发排错实录
本节摘要:这是全册第一份完整排错实录,场景是每个初学者几乎必遇的局面:talker 明明在发布,listener 却一条也收不到。本节按背景、操作、结果、解读、变式五段完整展开,示范一套可复用的排查顺序,并把 ROS_DOMAIN_ID、RMW 实现差异、QoS 匹配这三个高频病灶第一次摆上台面——它们会在第 2 章得到机理解释。
这个案例为什么值得逐帧回放
学完 1.2 的验证流程,你手里的环境是健康的。但真实项目里,"环境健康"与"我的两个节点能通信"之间还隔着一层配置:域、中间件、QoS。这一节故意把通信弄坏一次,让你在受控环境里看清故障的样子。等你以后在真实机器人上遇到同样症状,肌肉记忆会替你省下大量时间。
一、背景:一个再普通不过的下午
事情发生在给实验室新同学做环境培训的时候。同学 A 在自己的笔记本上跑 demo talker,同学 B 在同一间屋子的台式机上跑 listener,两人打算演示跨机器通信。talker 终端每秒打印一行 Publishing,情绪稳定;listener 终端安静得像断线了。两人重跑、重装、重启路由器,均无效。我接手时,他们的第一反应已经是"是不是这个版本的 ROS2 有 bug"。
先说结论:与环境质量无关,与版本无关,是两台机器的网络配置差异导致发现协议没有完成握手。下面按我当时实际的排查顺序复盘。
二、操作:五步排查顺序
第一步,先确认话题在发布方自己的视角里存在。 在跑 talker 的机器上执行:
ros2 topic list # 输出 # /chatter # /parameter_events # /rosout ros2 topic info /chatter -v # 关键字段摘录 # Type: std_msgs/msg/String # Publisher count: 1 # Subscription count: 0
topic info -v 是这次排查的核心工具,它直接问 DDS:这个话题现在有几个发布者、几个订阅者、各自什么 QoS。发布端显示 Subscription count: 0,说明问题出在"发现"或"匹配"环节,而不是数据传输环节——这个信息一下子把排查范围砍掉一半。
第二步,确认两台机器在同一域。 ROS2 用 ROS_DOMAIN_ID 隔离网络里的不同集群,只有同域的节点互相可见:
# 两台机器分别执行 echo $ROS_DOMAIN_ID # A 机输出空(默认域 0) # B 机输出 42 ← 病灶之一浮出水面
B 机的 bashrc 里残留着之前调试多机编队时设的域 ID 42,而 A 机在默认域 0。域不同,发现协议的组播包互相听不见,自然"互为幽灵"。
第三步,统一域之后再查中间件实现是否一致。 域对齐后 listener 依然沉默,于是查第二个嫌疑点:
ros2 doctor --report | grep -i rmw # A 机:RMW_IMPLEMENTATION=rmw_fastrtps_cpp # B 机:RMW_IMPLEMENTATION=rmw_cyclonedds_cpp
不同 RMW 实现走同一套 DDS 标准但默认的发现协议细节与 RTPS 行为有差异,混用时跨机器发现经常失败——同一台机器上混用反而常常没事,因为回环路径宽容度高。这是新手最想不到的一层。
第四步,用组播测试验证网络路径。 两项配置统一后跨机器发现仍偶发失败,这时候该怀疑物理网络:
# B 机监听组播 ros2 multicast receive # A 机发送 ros2 multicast send # B 机长时间无输出 → 组播被路由器丢弃
实验室的无线 AP 默认开了"组播转单播"优化,DDS 的发现组播包被它过滤。给两台机器接入有线或把 AP 调成组播透传后,listener 的终端终于开始打印 I heard。
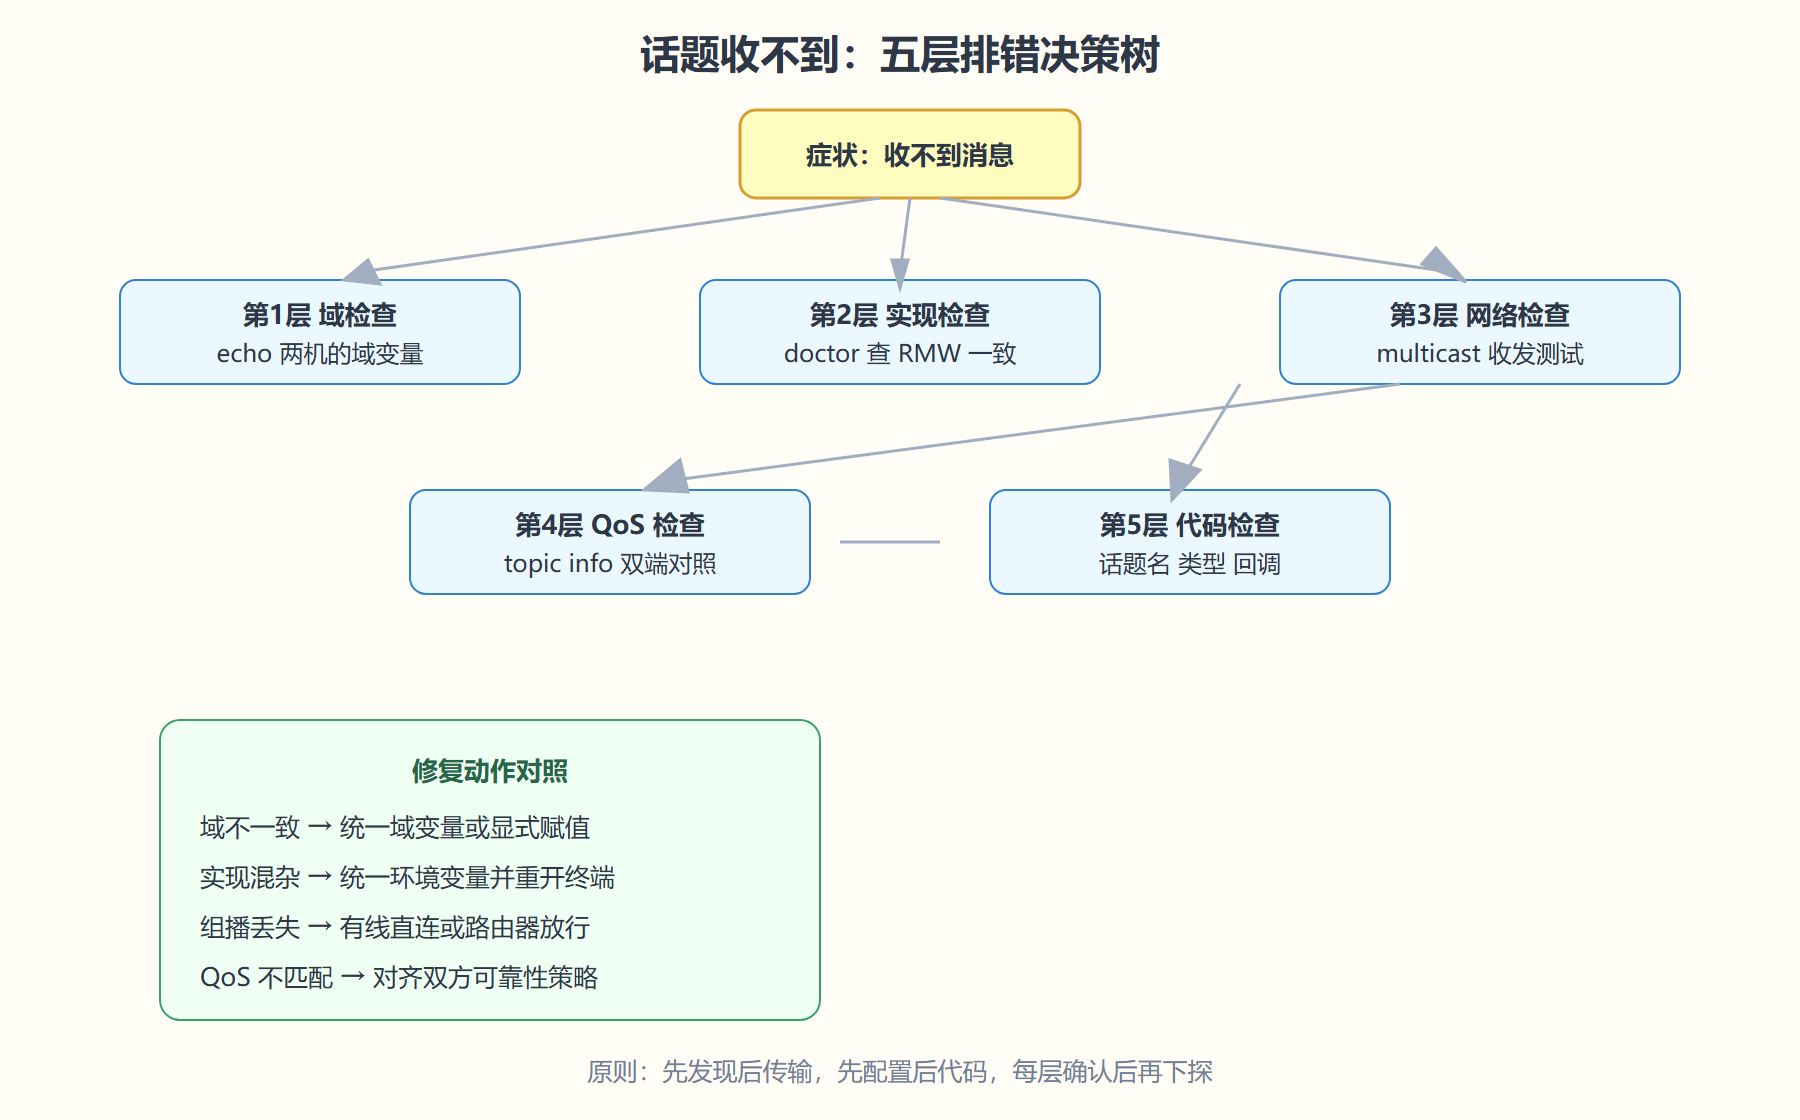
第五步,把排查顺序沉淀成检查单,下一节开头的那张图就是它的图形版:域一致 → 实现一致 → 组播可达 → QoS 匹配 → 再谈代码。
三、结果与解读
修复动作最终只有两处:清掉 B 机的 ROS_DOMAIN_ID 残留(或两机统一设 42),以及统一两机的 RMW 实现。耗时三小时,其中两小时浪费在"重装试试"的歧路上。
解读这件事,比修好它更重要。这次故障暴露了去中心化架构的调试特征:没有中央日志,故障是静默的。ROS1 时代查这类问题可以看 roscore 的登记表,ROS2 里"谁在线"这件事分散在每个节点的 DDS 参与者里,所以排查必须借助工具从外部视角看网络——topic info -v、multicast、doctor report 就是这样的外部视角工具。另一个教训是排查顺序的价值:先查发现再查传输、先查配置再查代码,每一步都在缩小怀疑范围;反过来先怀疑代码,就会掉进"重装依赖"的时间黑洞。
四、变式:同样的症状,不同的病灶
同是"收不到消息",病灶可以在五层中的任何一层。下面三个变式各有代表症状,本节先给现象级描述,机理留到第 2 章。
变式一:同一台机器上收不到。两终端同域同实现仍不通——查 QoS。发布端 reliability 设为 best_effort、订阅端设为 reliable 时,双方拒绝匹配,症状就是完全静默。这是第 2.3 节的主角。
变式二:时通时断。多网卡机器上,发现流量走了对外网卡而数据流量走内网,或反之。ros2 doctor 会给 WARN,解法是固定网卡或设置 ROS_INTERFACE。嵌入式板子上还有一类是防火墙默认丢组播。
变式三:收到几条后断流。发现成功、传输开始后断,多半与 QoS 的 depth 或 durability 有关:订阅端历史深度浅、处理慢,新消息把旧消息挤掉,看起来像"偶发丢包"。
图 1-2:话题收不到的排错决策树
本节要点回顾
- 排查顺序即方法论:域 → 实现 → 网络 → QoS → 代码,先配置后代码,每层确认再下探;
- topic info -v 是第一现场工具:发布端订阅者计数为零,即可把问题锁定在发现与匹配环节;
- ROS_DOMAIN_ID 残留是最常见的人为病灶,排查网络问题先 echo 它;
- 跨机器混用 RMW 实现是隐性雷,同机器不炸、跨机器炸,极具迷惑性;
- 组播被网络设备过滤在企业与实验室网络里都常见,multicast 工具可一锤定音;
- 相同症状可能有五层病灶,第 2 章会把其中 QoS 与发现协议两层解剖到机理。
下一章我们钻进这套通信系统的底层,看看分层架构如何让"收不到"这类问题变得可定位。