3.4 定步长与变步长对照实验
3.4 定步长与变步长对照实验
本节摘要:本节把前三节的机理知识变成一场亲手实验:同一个电机起动模型,分别用变步长 ode45、变步长隐式 ode23t、定步长 ode4 与粗步长定步长四种配置求解,对比耗时、输出点数与峰值误差,再做一次减半步长的收敛性检查。实验目的不是背结论,而是建立"任何结果先做收敛检查"的职业习惯——本节给出的方法在第 4 章复盘和第 7 章验证里都会反复使用。
实验设计与预期
模型沿用主线里的连续电机(电时间常数毫秒级、机械时间常数百毫秒级,轻度刚性),激励为阶跃电压,仿真 0.5 秒,记录转速与电流。四组配置:
| 组别 | 求解器 | 步长或容差 | 预期角色 |
|---|---|---|---|
| A | 变步长 ode45 | 相对容差千分之一 | 通用基准 |
| B | 变步长隐式 ode23t | 相对容差千分之一 | 刚性对照 |
| C | 定步长 ode4 | 步长 0.1 毫秒 | 实时友好组 |
| D | 定步长 ode4 | 步长 2 毫秒 | 偷懒减负组 |
预期:A 与 B 结果接近,B 用时更短(隐式法吃刚性红利);C 接近基准,耗时中等;D 明显更快但峰值误差可见——如果 D 与 A 几乎重合,那反而值得怀疑(误差去哪了)。
% 对照实验驱动脚本:一次配置,循环跑四组 load_system('motor_experiment'); configs = struct( ... 'name', {'A_ode45', 'B_ode23t', 'C_fix_1e4', 'D_fix_2e3'}, ... 'solver', {'ode45', 'ode23t', 'ode4', 'ode4'}, ... 'step', {'auto', 'auto', '1e-4', '2e-3'}); for k = 1:numel(configs) set_param('motor_experiment', 'Solver', configs(k).solver); if strcmp(configs(k).step, 'auto') set_param('motor_experiment', 'SolverType', 'Variable-step'); else set_param('motor_experiment', 'SolverType', 'Fixed-step'); set_param('motor_experiment', 'FixedStep', configs(k).step); end tic; out(k) = sim('motor_experiment', 'StopTime', '0.5'); t(k) = toc; fprintf('%s 耗时 %.2f 秒 输出点 %d 个\n', configs(k).name, t(k), numel(out(k).tout)); end % 收敛性检查:A 组容差收紧一个量级复跑 set_param('motor_experiment', 'Solver', 'ode45'); set_param('motor_experiment', 'RelTol', '1e-5'); outA2 = sim('motor_experiment', 'StopTime', '0.5'); % 对比 out(1) 与 outA2 的转速峰值:相对差小于千分之一才可继续分析
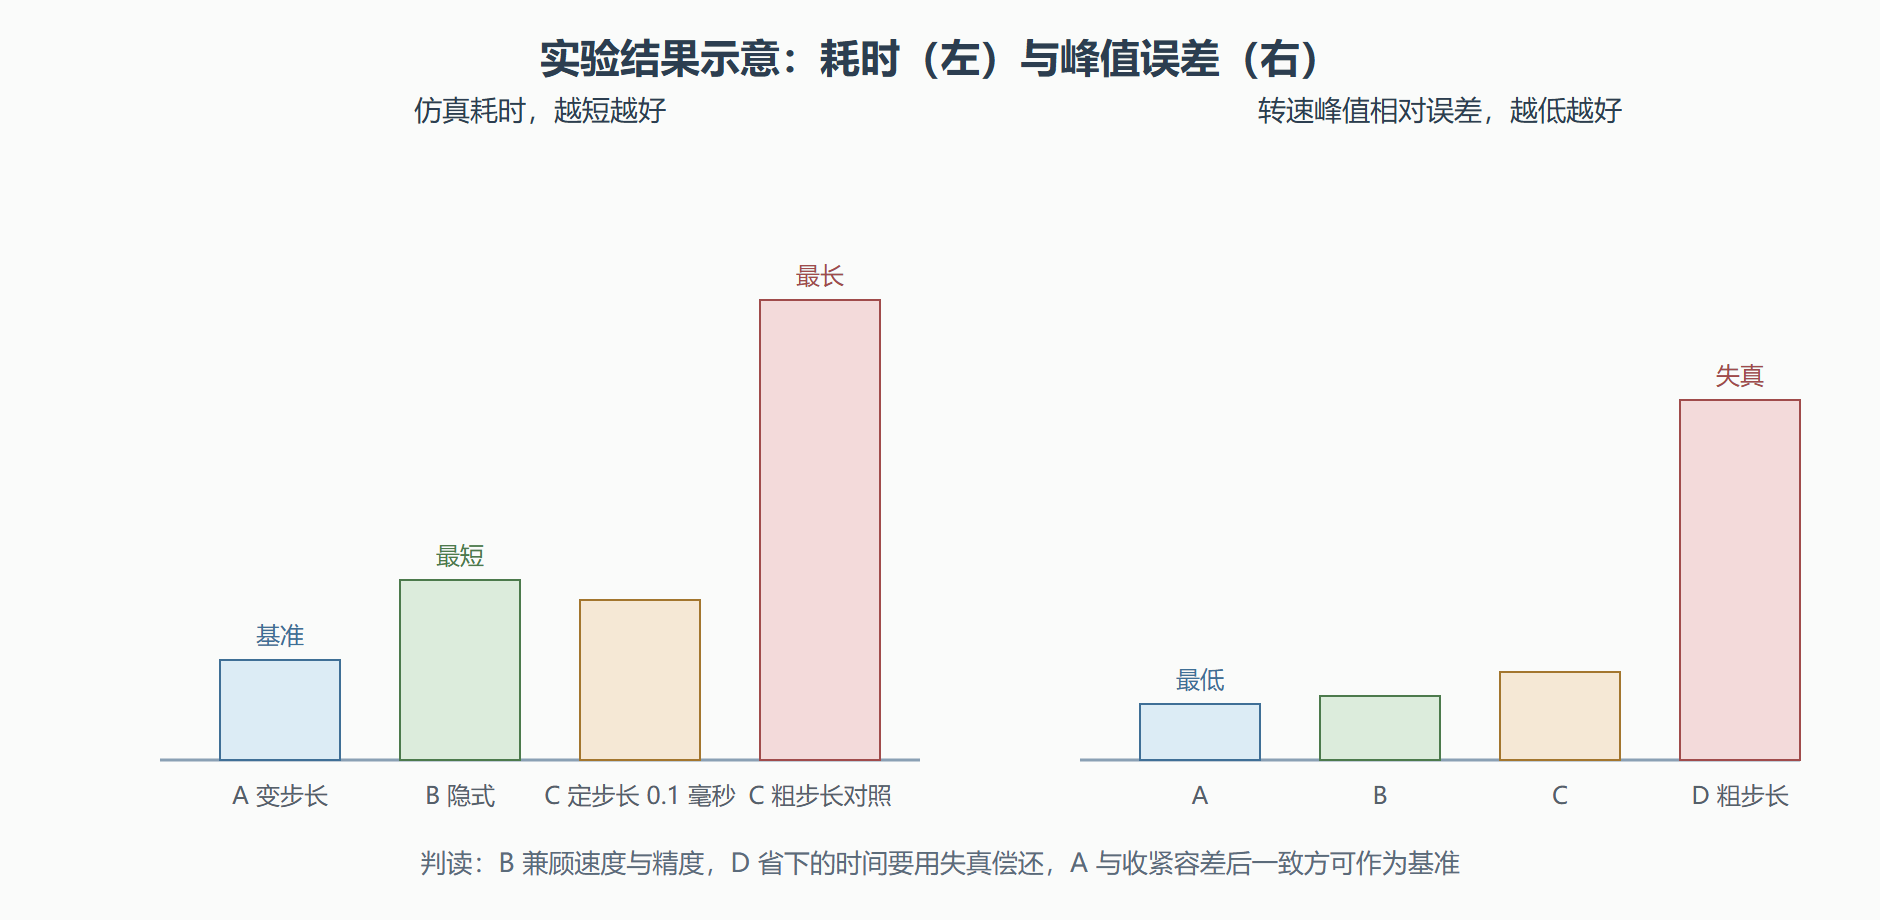
图:四组配置的耗时与误差对比
结果解读:三个反直觉
反直觉一:变步长不总比定步长慢。 组 A 精度最高但耗时不是最长;它把算力花在状态剧变的起动段,平缓段大步长掠过。粗定步长组 D 每步都便宜,但步数被死死钉在两百五十步,"便宜"乘不出优势,反而搭上误差。
反直觉二:隐式求解器在轻刚性模型上就赢了。 组 B 的隐式多步法在电瞬态段允许大步长而不失稳,总耗时反而最短。这推翻了"隐式一定更贵"的想当然——每步更贵、步数更少,天平朝哪边倾取决于刚性程度,实验让它可见。
反直觉三:最便宜的结果恰是最危险的。 组 D 的误差曲线在起动段明显偏离基准,但整体趋势"看起来像那么回事"。如果直接拿 D 的结果去评估起动电流冲击,结论会系统性偏低。"跑得通"与"算得对"之间隔着一次收敛性检查——这是本实验真正要刻进习惯的一句话。
变式:把实验搬进你的项目
第一步,找出你项目的"关键量"——误差最伤不起的那个指标(起动电流峰值、超调量、稳态纹波)。第二步,跑两次基准:默认配置一次、容差收紧一个量级一次,关键量相对差低于你的工程精度需求,基准才成立。第三步,再跑一个定步长版本,为将来代码生成探路——若定步长要小到不可接受才能保精度,说明模型刚性偏重,实时落地前要做模型简化(平均模型、降阶)。这三步在任何项目里都花不了一小时,却能挡住整类"仿真很好、上机变味"的事故。
💡 关键直觉:步长与容差不是"设置",而是你在精度、耗时、可落地性三者之间的契约条款。契约要写在实验记录里,而不是只存在模型配置里。
常见问题
问:实验里为什么不拿"真值"作基准,而拿变步长收紧容差的结果作基准?
因为多数工程模型没有解析真值——能写出 closed form 解的系统不需要仿真。数值仿真的"基准"只能是收敛意义下的自洽:把容差收紧到再收紧一档、结果不再明显移动,即认为已逼近该离散格式的极限解。这是数值分析的收敛性思想在工程上的日常化:我们不证明收敛,我们演示收敛。
问:定步长组怎么选步长才不是拍脑袋?
按"最速动态加节拍约束"双条件框定:步长必须显著小于你关心的最快动态的时间常数(经验上十分之一以下),又必须兼容未来代码生成的任务节拍(或其整数分频)。两个条件夹出来的可行区间就是候选范围,再进实验看误差——这就是为什么 C 组选 0.1 毫秒:它对毫秒级电时间常数是十比一,又刚好是 1 千赫兹控制节拍的十分频,两头都交代得过去。
问:模型以后要做实时仿真,现在直接全用定步长开发不是省事吗?
省的是后来的"切换验证",失去的是开发期的精度与效率:变步长在调试期给得起精度、跑得起速度,定步长在开发期两者都不占优。两段式的真正成本只在切换验证那一步,而它本来就是 8.3 节实时化前的必经检查——与其说是额外成本,不如说是提前暴露问题。
本节要点回顾
- 实验四组设计:变步长基准、隐式对照、定步长实时组、粗步长警示组,一次搭建反复可用;
- 反直觉三连:变步长未必慢、隐式未必贵、最省时的结果最危险;
- 收敛性检查是底线动作:容差收紧一个量级复跑,关键量不动才可信;
- 关键量思维:精度契约围绕伤不起的指标签订,不追求全信号等精度;
- 探路定步长:代码生成前先验证定步长可行性,刚性偏重则提前规划模型简化;
- 契约留痕:步长容差决策写进实验记录,与模型一起归档。
机理、地图、悬崖、实验,引擎舱的课到此上完。下一章主角登场:把这些知识放进一个真实的电机调速项目,从空画布走到收敛,途中每一处报错都不跳过。