6.4 大规模主机清单性能调优实验
6.4 大规模主机清单性能调优实验
本节摘要:一场完整记录的性能实验:一百二十台主机的清单、一份中等密度的基线剧本,从基线测量起步,按单变量原则依次验证管道加速、并发提升、事实缓存、任务合并、策略调整五个杠杆的效果。所有数字来自同一环境的对照运行,方法比结论更值得带走。
实验环境与方法
先交代环境,因为脱离环境的数字没有意义。控制机:八核虚拟机,与目标机同机房内网。目标机:一百二十台同规格虚拟机,系统一致,SSH 配置一致。实验剧本:一个标准基线剧本,二十四个任务(两个模板渲染、五个包操作、八个文件操作、九个服务与命令类动作),全部幂等且处于已收敛状态——这一点很关键,收敛状态意味着每个任务都走"检查后发现已满足"的快路径,测的是引擎开销而非模块工作量,正适合做性能归因。
方法上的三条纪律来自 6.2 节的工作流:每次实验前重置环境到收敛状态;每轮只动一个变量;每轮跑三遍取中位数(单次运行受网络抖动影响,三遍取中位是成本与可信度的平衡)。
基线:默认参数下的表现
第一轮,一切默认(forks 为 5,管道关闭,无事实缓存,线性策略):
第 1 轮 · 基线配置 运行 1: 17 分 52 秒 运行 2: 18 分 06 秒 运行 3: 17 分 48 秒 中位数: 17 分 52 秒 RECAP 汇总: ok=2880 changed=0 failed=0
接近十八分钟。计时回调的分组统计显示:单个任务的平均主机耗时约三点五秒,其中纯连接往返约两秒八,模块检查约零点七秒——连接开销占八成,印证了 6.2 节"任务密集剧本的主要矛盾在连接段"的判断。
第二轮:打开 SSH 管道
只改一处:pipelining 设为 True。
第 2 轮 · pipelining = True 中位数: 11 分 21 秒 (较基线 -36%)
效果显著且无副作用——现代发行版默认不强制 requiretty,一次通过。这一轮的启示是杠杆的性价比排序:管道是所有杠杆里"一行配置换三分之一时长"的最划算项,任何规模的环境都该首先检查它有没有开。
第三轮:并发拉高
管道保持开启,forks 从 5 逐级调到 20、50、80:
第 3 轮 · forks 对比(管道开启) forks=20 : 6 分 44 秒 (较上轮 -41%) forks=50 : 4 分 58 秒 (较 20 再 -26%) forks=80 : 4 分 51 秒 (几乎无增益)
拐点出现在 50 到 80 之间:控制机 CPU 在 forks 为 80 时接近饱和,连接建立期的加密握手成为瓶颈。结论:本环境下 forks 定在 50。注意这个数字不可直接外推——控制机规格不同,拐点位置不同,"逐级试出拐点"这个动作本身才是可复用的。
第四轮:事实缓存
基线剧本 gather_facts 开启,启用 jsonfile 缓存(超时窗口一天):
第 4 轮 · jsonfile 事实缓存(forks=50) 中位数: 4 分 41 秒 (较上轮 -6%)
只有六个百分点的改善——正如 6.2 节预判,任务密集剧本里采集占比小。这项杠杆在短剧本场景才显著:实验组加测了一个只有三个任务的修补剧本,缓存开关让时长从 41 秒降到 19 秒,降幅过半。结论固化:长剧本缓存收益小、短剧本收益大;开着没有坏处,按场景预期效果。
第五轮:任务合并
把八个连续的文件类动作合并为两个模板渲染加一个循环文件操作,往返次数从八次降到三次:
第 5 轮 · 任务合并(forks=50,缓存开) 中位数: 3 分 49 秒 (较上轮 -19%)
写法层面杠杆的威力:没有动任何参数,纯靠减少往返。这也是五个杠杆里唯一"免费"的——它同时让剧本更短更清晰。合并的边界仍然要守:合并的前提是动作确实操作同一类资源,为合并而把不相关动作塞进 shell 是倒退(违反幂等纪律)。
第六轮:策略与批次
最后验证 free 策略与 serial 批次的组合。基线剧本的机器间性能差异不大(同规格虚拟机),free 相对线性只快了约四个百分点——快慢等待在这批机器上本就不严重。serial 批次实验则显示清晰的风险换速度关系:serial 为 40 时总时长 3 分 40 秒,serial 为 10 时 4 分 55 秒,但后者单批爆炸半径只有前者的四分之一。结论:该剧本保持线性加业务可接受的批次,不为四个百分点扩大爆炸半径。
实验结果总览
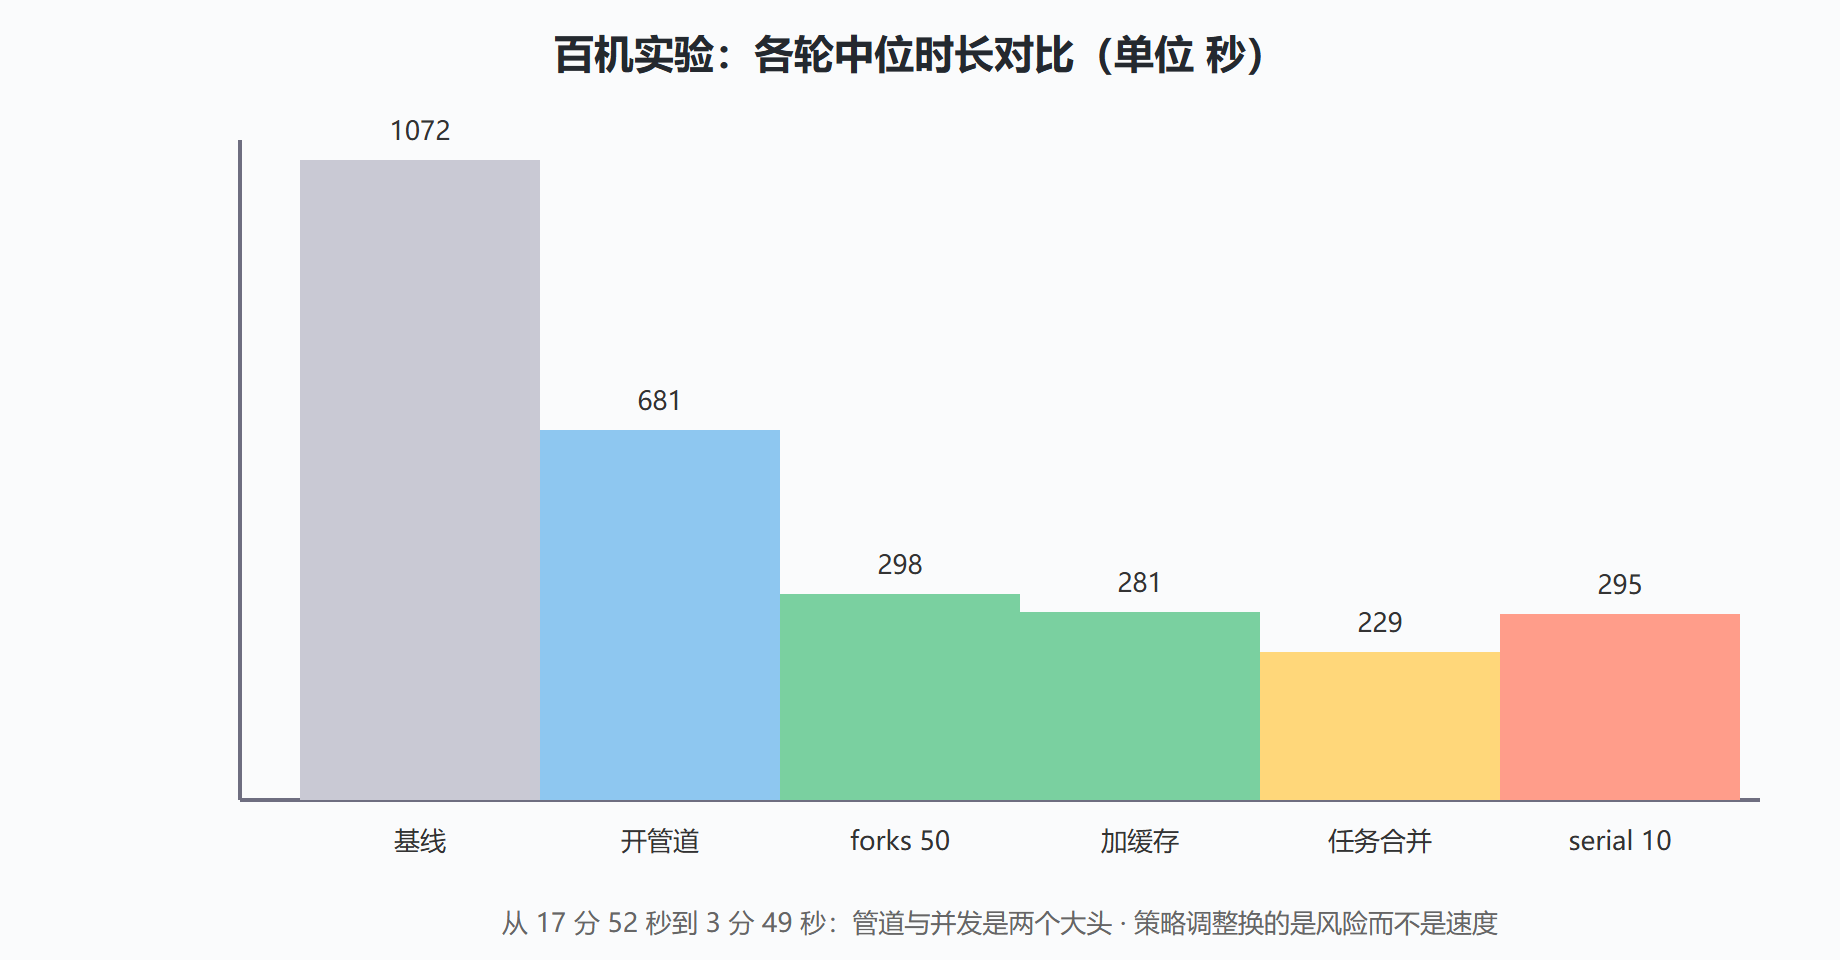
| 轮次 | 变更项 | 中位时长 | 相对上一轮 |
|---|---|---|---|
| 1 | 基线(全默认) | 17 分 52 秒 | — |
| 2 | 管道开启 | 11 分 21 秒 | -36% |
| 3 | forks 50 | 4 分 58 秒 | -56% |
| 4 | 事实缓存 | 4 分 41 秒 | -6% |
| 5 | 任务合并 | 3 分 49 秒 | -19% |
| 6 | 批次与策略评估 | 4 分 55 秒(serial 10) | 风险换速度 |
图 6-4:六轮实验的时长对比
实验带走的方法论
数字不能搬走,方法可以。第一,收敛态测量:性能实验要把"引擎开销"与"模块工作量"分离,收敛态(全部 ok)测的是前者。第二,单变量原则:六个杠杆如果一轮全上,你永远不会知道哪三个有效、哪两个无效、哪一个有害。第三,警惕外推:forks 的拐点、缓存的收益、free 的增益全部依赖环境,别人家的结论只能当假设来自己的环境验证。第四,有些"慢"不该修:serial 缩小批次换来的那五分钟,买的是爆炸半径,值。
实验设计的三个对照组
六轮主实验之外,三组补充对照能堵住结论的漏洞,实验报告里应当出现它们的身影。对照一,收敛态与变更态:主实验全部在收敛态(全 ok)测量引擎开销,补一组强制变更态(比如把一处配置回退再跑),看模块真实工作量下的各杠杆增益是否依然成立——结论是管道与并发的增益比例基本不变,因为两者的优化对象(往返次数与并发度)与模块工作量无关,这正是它们稳居前两位的原因。对照二,冷缓存与热缓存:事实缓存的六个百分点是热缓存数字,首次运行(冷缓存)必然无收益,把两个数字都写进结论,防止读者拿着热缓存数据期待冷启动收益。对照三,网络抖动日重跑:主实验集中在一天完成存在偏差风险,关键档位(基线与最终配置)隔日在不同时段重跑,中位数偏差在百分之三以内才算结论稳定。三组对照的共同精神是给结论标注适用域——实验的价值不在数字本身,在数字后面的边界说明,这一点与 7.2 节选型矩阵"先定权重再读分数"是同一种严谨。