6.5 一次多机部署全程复盘:编写、灰度与回滚
6.5 一次多机部署全程复盘:编写、灰度与回滚
本节摘要:本章第二场复盘,也是全书的主线收束。"星尘在线"的一次十二机版本发布,从周一编写剧本到周五完成复盘的完整时间线:每个阶段做了什么、为什么这样做、哪些设计在关键时刻起了作用、哪里靠了运气。发布是顺利的,回滚也没用上——但复盘的价值恰恰在"为什么没用上"。
背景与约束
本次发布内容:应用 4.2 版本,包含配置格式变更(一个配置键改名)与一个依赖库升级。十二台应用机分两组:金丝雀组两台、主力组十台。约束条件:发布窗口周四 21:00 到 23:00;配置格式变更导致本次发布不可原地回退(旧版本读不懂新配置),回滚方案必须是"恢复旧配置文件加旧版本包";发布期间服务不可全停。
约束直接决定了剧本的三个设计。设计一,配置变更用"双写"过渡:新配置文件与旧配置文件并存,应用版本升上去读新文件,回滚时把新文件改名让路即可——不可原地回退的变更要为回滚预先铺路。设计二,serial 分两批:先两台(金丝雀)后十台(主力),批间隔挂暂停等人确认。设计三,健康验证进剧本:每批结束时跑接口探活与错误率检查,失败自动停批。
周一至周三:编写与验证
周一拆解需求时发现一个隐蔽问题:依赖库升级要求先升级一个系统包,而系统包升级会重启一个公共组件——这个动作如果在十二台机器上同时发生,会造成短暂的连接抖动。于是把它挪进 block 结构并配合 delegate_to 串行化:公共组件的升级逐台进行而不是整批进行。这个决策后来被证明是本次发布最关键的一处——它在编写期就消解了发布日最大的风险,成本只是多写十个任务。
周二的编写按 6.1 节规范走:意图化命名、幂等审问三问、配置双写逻辑单独成任务文件。周三的验证链:lint 绿、molecule 场景绿、staging 环境干跑加实跑各一遍、把干跑 diff 输出贴进发布评审单。评审会上有人问了一个后来很重要的问题:"回滚剧本跑过吗?"——没有。于是周三下午补了一场 staging 回滚演练,暴露出两个问题:回滚剧本里旧版本包的文件名是写死的(应从变量取),改名让路的动作没有容错(新文件不存在时会失败)。两个问题当天修完,回滚剧本二刷通过。
周四 21:00–22:40:发布执行
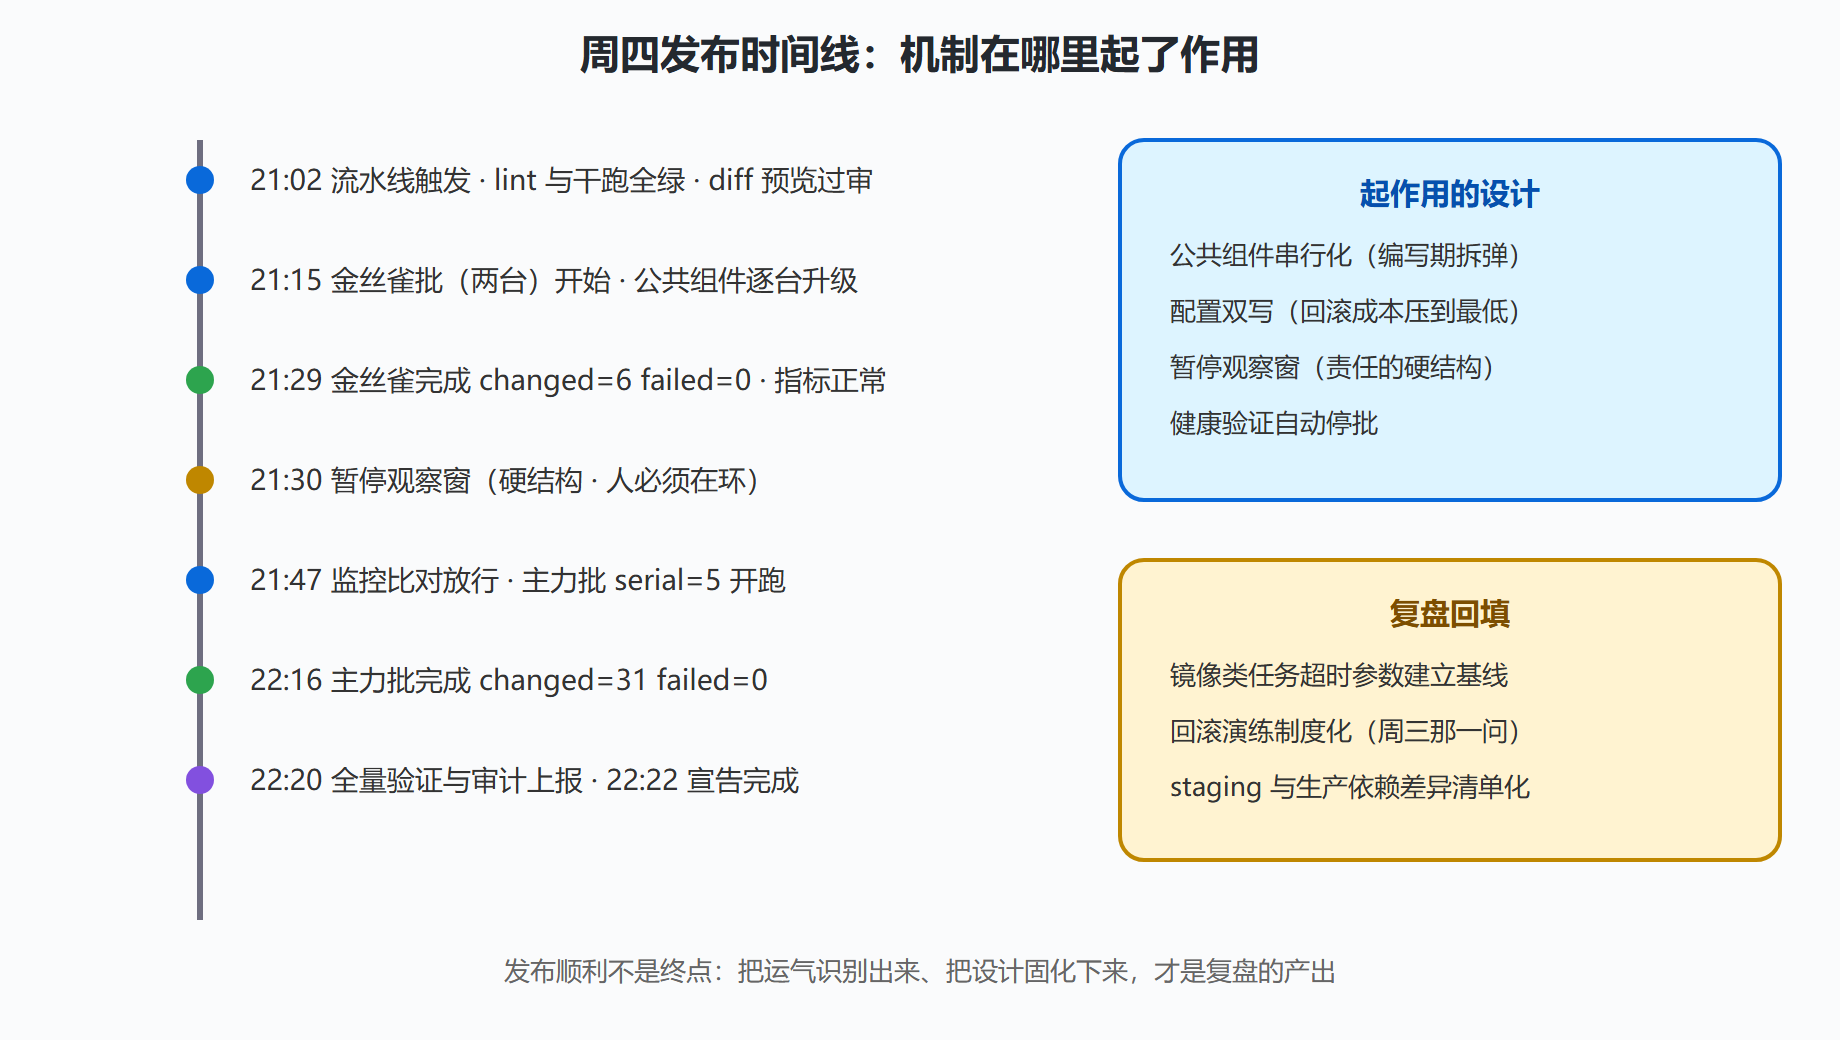
时间线如下,描述里标注了每个环节依赖的机制。
21:02 流水线触发,lint 与干跑阶段全绿,diff 预览评审通过 21:15 金丝雀批次(serial 首批两台)开始 — block 结构逐台升级公共组件(周一的设计) — 应用升级、新配置落位、重启、接口探活 21:29 金丝雀批完成:changed=6 failed=0,健康指标正常 21:30 暂停等待人工确认(pause 模块,十五分钟观察窗) 21:47 监控确认金丝雀两机错误率与基线一致 → 放行主力批 21:48 主力批次(十台)开始,serial=5 分两个子批 22:16 主力批完成:changed=31 failed=0 22:20 全量验证:探活、错误率、发布审计上报(5.2 节出向集成) 22:22 发布宣告完成,窗口比计划提前三十八分钟
两个"设计兑现"的时刻值得单独说。第一处,21:30 的观察窗:暂停模块把"人必须在环"变成了流程的硬结构而不是口头约定——如果那个时间点有人发现金丝雀异常,剧本停在暂停上,主力批根本不会开始。第二处,配置双写在 21:48 主力批的价值:十台机器的配置切换是"改名让路"一个动作,回滚成本被压到了最低。另外一处运气成分也要如实记录:22:16 主力批完成时发现有一台机器的镜像拉取比平时慢了约四十秒,导致该子批完成时间被拉长——幸好验证超时给了足量余量。若余量不足,这里会是一次误报失败。发布次日,该任务的 timeout 参数被调整并落库。
周五:复盘会
复盘会按"三问"走。一问,哪些设计起了作用:公共组件串行化(消解最大风险)、配置双写(压低回滚成本)、观察窗(责任硬结构)。二问,哪里靠了运气:验证超时的余量、当晚网络无抖动、依赖库升级未触发隐藏兼容问题(staging 与生产的库版本差异比预想小)。三问,回填什么规范:镜像类任务的超时参数按类型建立基线值;回滚演练制度化——本次若非评审会上那一问,回滚剧本将带着两个缺陷进入待命状态,真出事时就是二次事故。
图 6-5:发布时间线与关键机制
复盘的元结论
整场发布没有用到 4.4 节的 rescue 结构,但它的存在改变了编写期的心态:知道有救援结构,编写者才敢于把变更拆得足够细。回滚剧本同样没上场,但周三的演练修掉的两个缺陷,相当于让这次发布提前失败了一次。## 把复盘模板留给读者
本场复盘的方法结构可以抽成模板供任何发布复用,五段:约束先行——发布窗口、不可回退点、服务连续性要求,先列约束再做设计,三个约束决定了三个设计;设计回指——每个关键设计写明它针对哪条约束(双写针对不可回退、串行化针对公共组件、观察窗针对责任),设计与约束对不上号的,要么设计多余要么约束漏列;演练必做——回滚路径必须真跑过,没跑过的回滚方案等于没有;时间线留痕——执行时的关键时间点与决策当场记录,事后回忆的时间线会自动美化;三问收尾——什么起了作用、哪里靠运气、回填什么规范。模板的用法甚至不限于发布:任何"高风险、多环节、有回滚"的变更(数据迁移、网络割接、证书轮换)都套得上。复盘能力的本质,是把一次成功里的运气与设计分离干净——成功归因错了,比失败更危险。
与性能实验的呼应
细心的读者会发现 6.4 与 6.5 两场复盘的隐含呼应:发布用的正是实验调好的参数——forks 与管道来自实验结论,serial 的批次划分来自"风险换速度"的那轮评估。两条线的分工值得点破:性能实验回答"能不能更快",发布复盘回答"应该多快"——前者是工程问题,后者是业务问题。性能工作的终点不是最快数字,而是给业务一个"快与稳"的可选菜单:这份菜单由实验提供(各参数档位的时长与风险数据),由发布现场点菜(按业务容忍度选档位)。工具人的价值坐标,也正在这两条线的交点上。
发布前检查单的可执行版
把本场发布用到的检查固化为一页可执行的检查单,供直接取用。设计类:不可回退点已识别且有对应预案;配置变更的回滚路径已演练;公共组件的影响面已评估并做了串行或分批。数据类:金丝雀与主力组的分组已确认;批间观察窗的时长与责任人已指定;验证任务的超时余量按基线参数设置。流程类:流水线各阶段全绿且干跑产物已归档;回滚剧本当周演练通过;审批链路的名单与联系方式有效;监控面板的发布视图已就绪。收尾类:审计上报的接口可达;复盘会已排期;本次回填规范的责任人已指定。检查单的使用方式是"逐项打勾、不打折"——十四项里有任何一项无法打勾,发布要么整改要么延期,没有"先上再说"的例外条款。检查单的价值从来不是纸面功夫,而是把 6.5 这类复盘的经验强制带进下一次发布。