3.4 窗口语义实验:八条数据看清触发时序
3.4 窗口语义实验:八条数据看清触发时序
本节摘要:本节把前三站的理论放进烧杯:构造一小批故意乱序的事件,分别在三种水位线参数下跑同一个分钟级窗口作业,逐条记录窗口的触发时刻、补记修正与侧输出分流。实验的目标是让"窗口为什么少算了一条"从此不再需要猜。
把理论放进烧杯
值班室里最常见的时间类工单长这样:"大屏 10:05 的成交额比数据库少一笔。"要解释它,靠背概念不如亲手复现一次。本节设计一个极简实验:八个支付事件、两分钟的窗口、三种水位线配置,所有参数都摆在你眼前——跑完这一节,你会拥有一个可以随意修改重跑的"窗口沙盒",以后任何口径疑问都可以在沙盒里先演一遍。
实验设计
八个事件的业务时间是 10:00:10 到 10:01:50,其中两条故意迟到:业务时间 10:00:30 的那条偏偏最后一个到达。我们用集合源(直接把数据写死在代码里,无外部依赖,本地就能跑),按到达顺序逐条发出,窗口用一分钟的滚动事件时间窗口。
public class WindowLab { public static void main(String[] args) throws Exception { StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment(); // 数据按"到达顺序"排列;括号内是业务时间戳(秒) List<Payment> arrivalOrder = List.of( new Payment("p1", 60010), // 10:00:10 new Payment("p2", 60040), // 10:00:40 new Payment("p3", 60085), // 10:01:25 new Payment("p4", 60110), // 10:01:50 new Payment("p5", 60070), // 10:01:10 乱序:比上一条还早 new Payment("p6", 60130), // 10:02:10 第二分钟 new Payment("p7", 60160), // 10:02:40 new Payment("p8", 60030) // 10:00:30 彻底迟到:最后一个才到 ); // 实验变量:乱序容忍度,三组实验分别取 0、30、60 秒 Duration tolerance = Duration.ofSeconds(30); OutputTag<Payment> lateTag = new OutputTag<Payment>("late"){}; WatermarkStrategy<Payment> strategy = WatermarkStrategy .<Payment>forBoundedOutOfOrderness(tolerance) .withTimestampAssigner((p, ts) -> p.getTsMillis()); SingleOutputStreamOperator<String> stats = env .fromCollection(arrivalOrder) .assignTimestampsAndWatermarks(strategy) .keyBy(p -> "all") .window(TumblingEventTimeWindows.of(Time.minutes(1))) .allowedLateness(Time.seconds(45)) .sideOutputLateData(lateTag) .aggregate(new CountAgg()) .map(c -> "窗口结果: 共 " + c + " 笔"); stats.print(); stats.getSideOutput(lateTag).map(p -> "侧输出兜底: " + p).print(); env.execute("window-lab"); } }
三组实验的结果
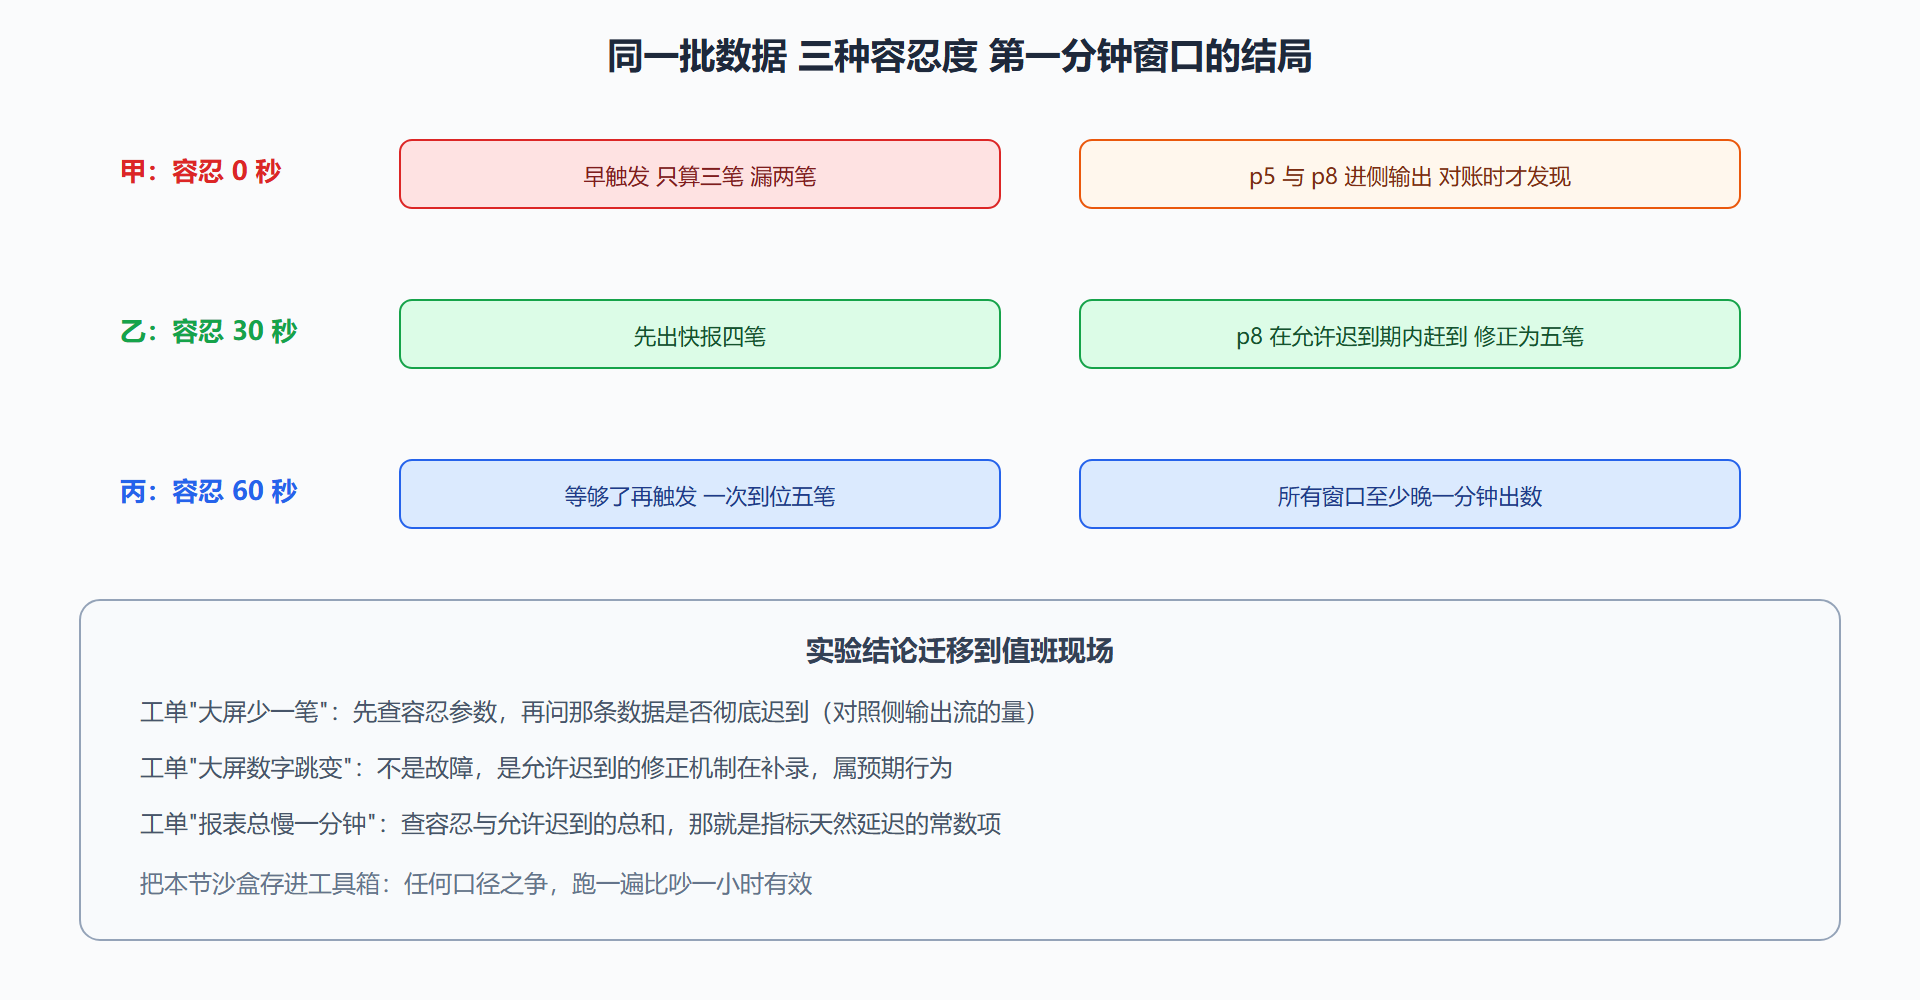
实验甲:容忍零秒。 最严格的承诺。数据 p4(10:01:50)到达时水位线到达 10:01:50,第一分钟窗口立即触发——但此刻 p5(10:01:10)与 p8(10:00:30)还没到达,第一分钟窗口只算出三笔,两笔进了侧输出流(允许迟到的时限也早过了)。结论:零容忍换来最快出数,代价是漏算。
实验乙:容忍三十秒。 水位线跟着每条数据推进"业务时间减三十秒"。p5 到达时水位线走到 10:00:40,第一分钟窗口触发,算出四笔(p1、p2、p5 在此之前已到、p3、p4 中的属第一分钟者)——p8 仍迟到,落进允许迟到通道:触发后四十五秒内 p8 赶到,窗口输出修正结果"五笔",大屏数字跳一下变准。这就是修正机制的全过程。
实验丙:容忍六十秒。 水位线推进更谨慎。p8 到达时它本身已把水位线推到 9:59:30 加六十秒,恰好还在第一分钟窗口触发之前——p8 被正常收进格子,一次触发即五笔,无需修正。代价:所有窗口至少晚一分钟出数。
图 3-4 实验时序:三种容忍度下第一分钟窗口的结算过程
实验之外的两个注意点
第一,集合源的水位线是逐条即时推进的,真实 Kafka 源则是周期性生成——沙盒结论的定性规律完全适用,定量的触发时刻会因生成方式略有差别,别拿沙盒秒数去硬套生产日志。
第二,实验里"all"这个 key 让所有数据共享一个窗口实例,方便观察;换成按用户 keyBy 后,每个键独立记账,修正发生在对应键的窗口里。理解这一点,你就能解释"为什么只有某个用户的数字变了一下"这类更细的工单。
把沙盒扩展成团队资产
这个八条数据的沙盒真正的价值在于"可生长"。建议按三条路把它养大。养方向一:加迟到烈度。把 p8 的时间戳改得更早、加进更多彻底迟到的事件,观察允许迟到窗口从"触发中收件"到"超时拒收"的边界行为,体会修正与兜底的交接点。养方向二:换成多键。把 keyBy 从常量改成按用户,构造两个键不同的乱序节奏,验证窗口按键独立记账、修正只影响对应键的结论。养方向三:换水位线策略。把有界乱序换成单调策略重跑,观察乱序事件被大量判迟到的惨状——这一跑比十页文档更能让人记住"策略选择要匹配乱序现实"。
沙盒养大的终点是变成团队的"口径公证处":产品与工程对某个统计口径有分歧时,不吵,把分歧参数填进沙盒跑给对方看。技术争论一旦有了可复现的裁判,沟通成本断崖式下降——这是把本节知识兑换成团队生产力的方式。
本节要点
- 沙盒三组实验的定性结论:容忍越小出数越快但漏算多,容忍够大可一次算准但整体延迟,允许迟到制造"快报加修正"的两段式输出。
- 大屏数字跳变是修正机制在工作,属预期行为;彻底迟到的数据去侧输出流对账,不进主流。
- 指标的天然延迟常数 = 窗口长度 + 乱序容忍 + 允许迟到,口径评审时把它写在需求里。
- 窗口按键独立记账,修正只影响对应键;工单里"个别用户数字变化"要往键维度想。
时间与窗口的实验到此收束。窗口在算子里留下的那些格子,就是流计算要守护的状态——下一章,我们认真谈谈状态本身。