4.4 Checkpoint 失败排错实录:三小时告警的解剖报告
4.4 Checkpoint 失败排错实录:三小时告警的解剖报告
本节摘要:本节用一起真实的"checkpoint 连续失败三小时"事件做标本,完整走一遍急诊流程:从告警现象出发,按"看大小、看耗时、看对齐、看后端"的诊断顺序层层下钻,最终定位到"状态膨胀 + 对齐超时 + RocksDB 写放大"的复合病因。读完你应能把这套路子搬去解剖任何一次心跳失灵。
那晚的告警长什么样
时间回到某天夜里。值班群先收到的是普通告警:"作业 A checkpoint 连续两次失败。"按预案观察一轮,十分钟后升级:"连续失败第五次,即将超过容忍阈值。"打开监控大盘,症状有三条:快照耗时从常态的四秒一路涨到逼近间隔上限的九分钟;恢复后的快照大小环比上周涨了四成;几个子任务的 UI 状态在"运行中"与"等待对齐"之间反复横跳。业务侧暂无感知——但谁都知道,心跳停稳之前,作业处于"裸奔"状态:此刻宕机将丢失全部进度。
按第 4.2 节的四项体检指标,这不是单点故障,是一场复合病。下面按当时的处置顺序,把诊断链一步步铺开。
第一步:看大小——状态在肿胀吗
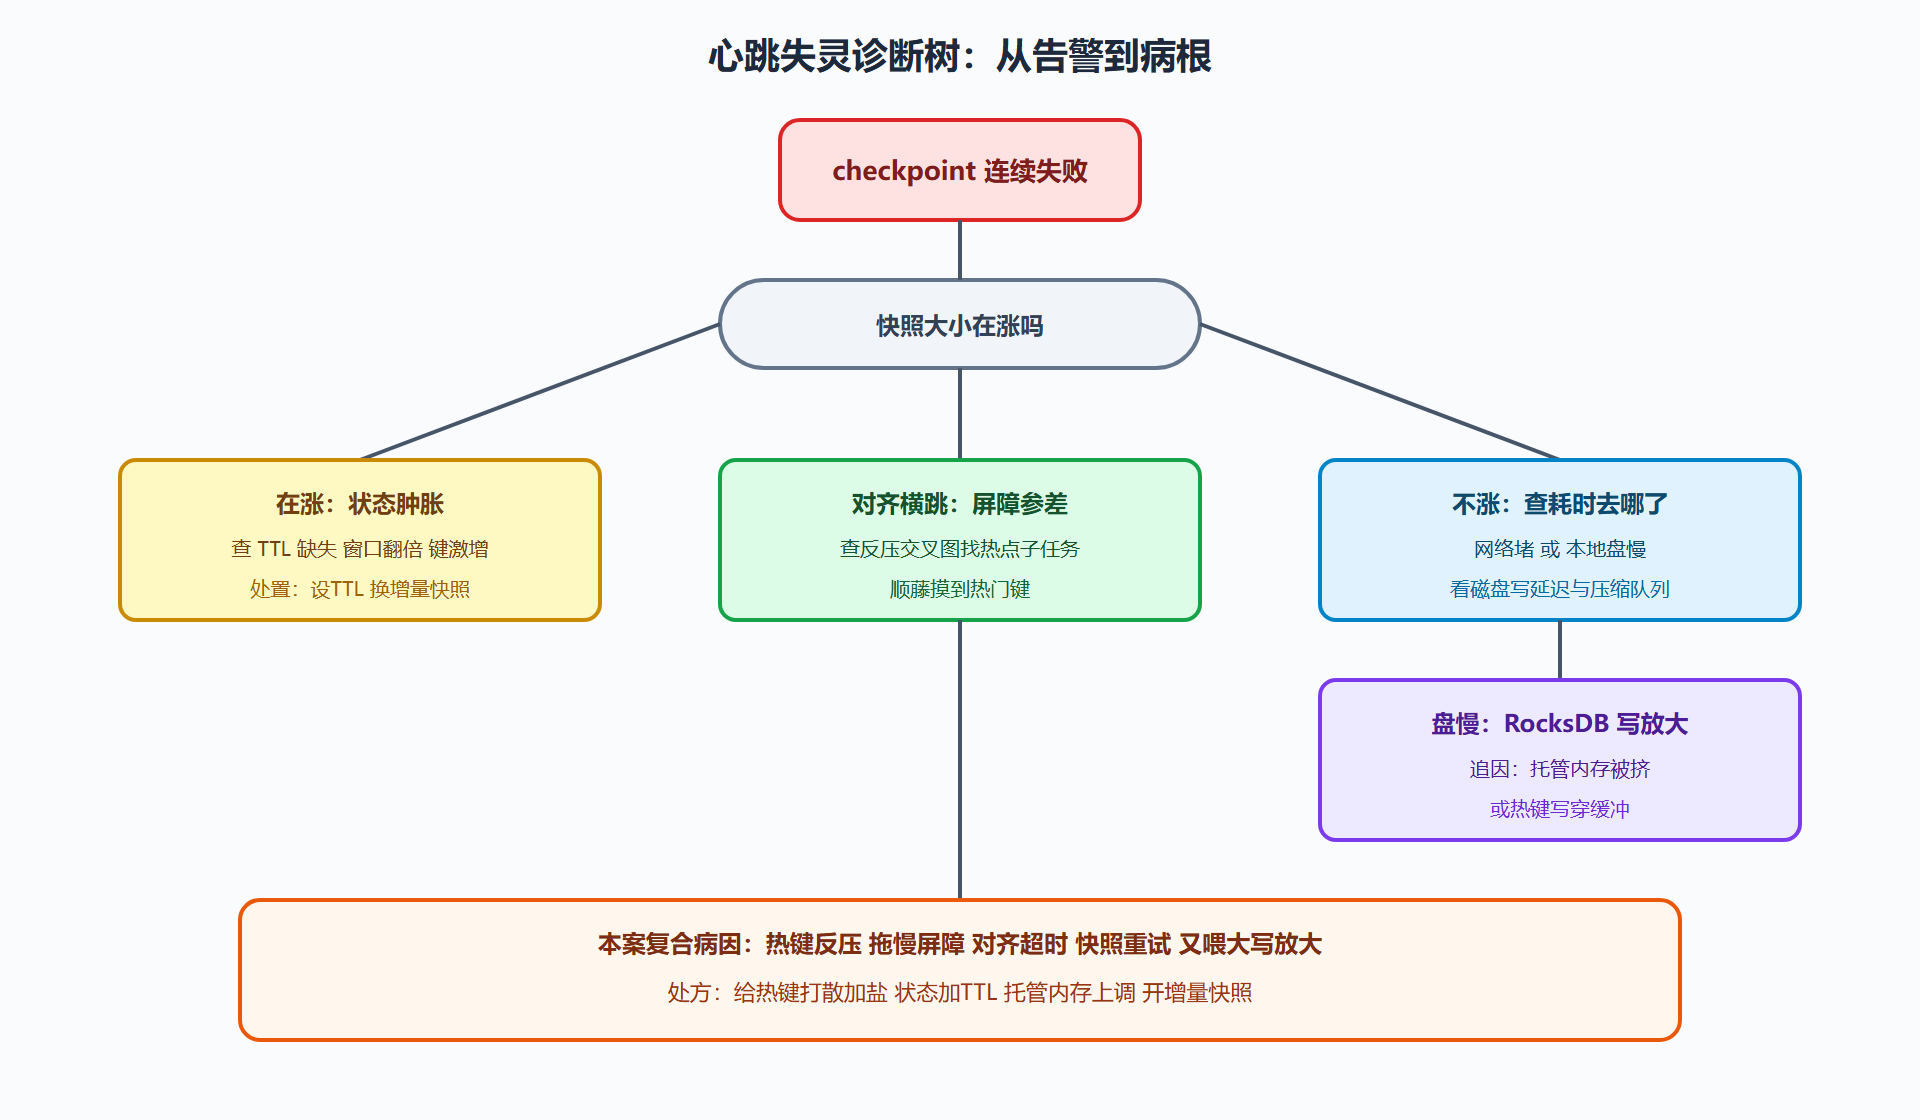
先拉快照大小的历史曲线。常态两 GB 左右的作业,最近七天缓慢爬升到三 GB,事发当天冲上四 GB。状态肿胀的嫌疑名单有三类:窗口翻倍(滑动窗口的记账数与步长相关,是否有人改过口径)、状态无 TTL(去重键只进不出)、流量结构突变(大促预热带来的新键涌入)。对照变更记录:口径没动、流量只涨了一成。剩下最大嫌疑是无 TTL 的去重状态——这个作业做用户去重,三个月前上线以来从没设过清理,键数随注册用户自然增长。肿胀是慢病,不是当晚的急症,先记下,继续查急症。
第二步:看耗时——快照在挨饿吗
快照耗时长,通常两条路子:要拍的东西太大(慢在写),或者写出去的路太堵(慢在传)。当时的快照走远端对象存储,网络监控平静无波;而快照大小只涨了四成,耗时却涨了百倍——量变不足以解释时变,嫌疑转向"写不出去"。RocksDB 后端的快照要先落本地、再上传,如果本地盘被 RocksDB 自身的写放大拖住(后台压缩线程堆积),快照的本地阶段就会干等。查 TaskManager 宿主机的磁盘指标:写入延迟从两毫秒恶化到八十毫秒,压缩线程排队深度爆表。写放大坐实,但它为何突然恶化?继续第三步。
第三步:看对齐——是谁在憋着谁
UI 上"等待对齐"反复横跳,说明各通道的屏障到得参差不齐。拉对齐耗时与反压指标的交叉图:某几个 keyed 子任务反压常年高企,它们的屏障总是最后到,全作业跟着它们对齐。为什么偏偏是这几个子任务?看 key 的分布统计——热门键。该作业按商户 keyBy,当天有头部商户大促预热,交易量是平日的几十倍,热键所在的两个子任务处理量是其他实例的百倍,状态块也集中在它们身上。热键导致局部反压,反压拖慢屏障,对齐超时,快照反复作废重试——重试的半成品快照又加剧了磁盘写入,与第二步的写放大互为放大器。病因闭环了。
图 4-4 Checkpoint 失败的诊断决策树
处方与复盘
当晚的止血动作按"先救心跳、再治病根"排序。止血:把对齐超时开关打开(超时自动转非对齐快照),心跳先恢复跳动——快照变大,但裸奔结束;同时调大失败容忍次数,避免作业被反复重启放大抖动。病根:次日按四个处方逐项落地——热键加打散盐值(把头部商户按订单号后缀拆成若干逻辑键,聚合时二次归并,手法详见第 8 章 8.3);去重状态加 TTL(九十天生命周期);RocksDB 托管内存配比上调,写缓冲充饥;checkpoint 改增量模式,快照体积降一个量级。一周后复盘:快照耗时稳定回落在十秒内,对齐耗时归零附近,写放大恢复正常。
这起案例留下的三条值班法则值得抄进手册:其一,checkpoint 告警从来只是症状,病因在反压、状态或资源三者之二三;其二,快照耗时与快照大小的增速背离时,先查磁盘与后端,别傻傻加带宽;其三,任何 keyed 聚合作业上线前都要问一句"头部键会有多大"——热键问题在流量低谷里潜伏,在大促前夜爆发。
从个案到制度:心跳的防病体系
排错个案的更高价值是变成防病制度。这起案例后该团队沉淀了四条制度化检查,新作业上线评审逐一过堂。其一,键分布评估前置:任何 keyed 聚合上线前用抽样数据跑键分布,头部键流量超均值十倍即触发打散设计——不等大促来验。其二,TTL 强制成对:状态描述符必须有保质期与物理清理,代码评审用检查清单核对,没写清理策略的 TTL 视为没写。其三,快照预算入容量表:作业的快照耗时与大小写进容量规划,占比超标即先治理再扩量。其四,月度心跳体检:每月拉一次全集群的检查点四指标分布,劣化趋势(哪怕仍在阈值内)即立项排查——趋势比阈值更早说话。
这套制度的本质是把 4.2 节的"心跳体检四指标"从值班时的读数,升级为上线前的门槛与运行中的趋势监控。急诊科的水平再高,也不如少送病人进急诊——排错能力的终点,是让排错变得稀少。
再补一条被反复验证的判断经验:心跳类告警里,"突发型"与"渐进型"的处置优先级完全不同。突发型(某次发布或流量事件后突然失败)先查变更关联;渐进型(耗时与大小逐日爬升)先查状态增长与写放大。两类混查是排错时间的最大黑洞——先分类,再钻取。
案例的最后一块拼图留给沟通:当时向业务方同步了三句话——故障影响(恢复点退后几分钟)、处置进展(心跳已恢复、根治次日完成)、预防动作(四条制度落地)。事故沟通的黄金结构就是这三段:影响、进展、预防。技术处置做得再好,少了这三段的及时同步,信任账户照样透支。
本节要点
- 诊断顺序固定为四看:大小(状态肿胀)、耗时(写路径拥堵)、对齐(屏障参差)、后端(写放大与内存挤压)。
- 耗时与大小增速背离是关键线索:量变解释不了时变时,去查磁盘、压缩队列与托管内存。
- 热键是"对齐超时"最常见的幕后推手:它制造局部反压,拖慢屏障,让全作业的心跳为少数子任务陪葬。
- 止血与治病分开:先用非对齐快照恢复心跳,再按 TTL、打散、内存配比、增量快照四个处方根治。
状态一章到此收官。接下来换一个视角:同样的业务逻辑,用不同的 API 来写,状态的负担与心跳的开销会截然不同——第 5 章讲表达层的选型。