1.2 ARM与x86、RISC-V汇编对照
1.2 ARM 与 x86、RISC-V 汇编对照
本节摘要:三种主流汇编的差异根源在于两条设计轴——指令长度是否固定、运算能否直接访问内存。ARM 选择定长编码与加载存储架构,x86 选择变长编码与内存操作数,RISC-V 用极简模块化重走 ARM 的路线却砍掉了历史包袱。本节用同一段累加代码的三种汇编、一张多维对照矩阵,把差异讲透。
上一节我们沿一条链看完了一行 C 的旅程,那条链在三种架构上都成立。但链上流过的"语言"长得完全不同。本节做一次横向对照——目的不是教你 x86 或 RISC-V,而是借邻居看清 ARM 的哪些设计是"加载存储架构的必然",哪些是"ARM 自家的选择"。
一个反例破除误解
常有说法是"x86 汇编比 ARM 难学,因为指令多"。这是一个值得拿来开刀的反例:x86 的难,其实不在指令数量,而在一条指令能同时干三件事——从内存取数、做运算、把结果写回内存。add DWORD PTR [rbp-8], 1 这一条指令里藏着一次内存读、一次加法、一次内存写。而 ARM 逼你把这件事拆成两条:ldr 先读进寄存器,add 只碰寄存器,str 再写回去。指令数多了,但每条指令语义简单了。难与易的翻转就在这里——x86 学的是"猜指令背后发生了什么",ARM 学的是"把动作排成队"。这个视角先立住,后面的对照才有抓手。
一、两条设计轴定气质
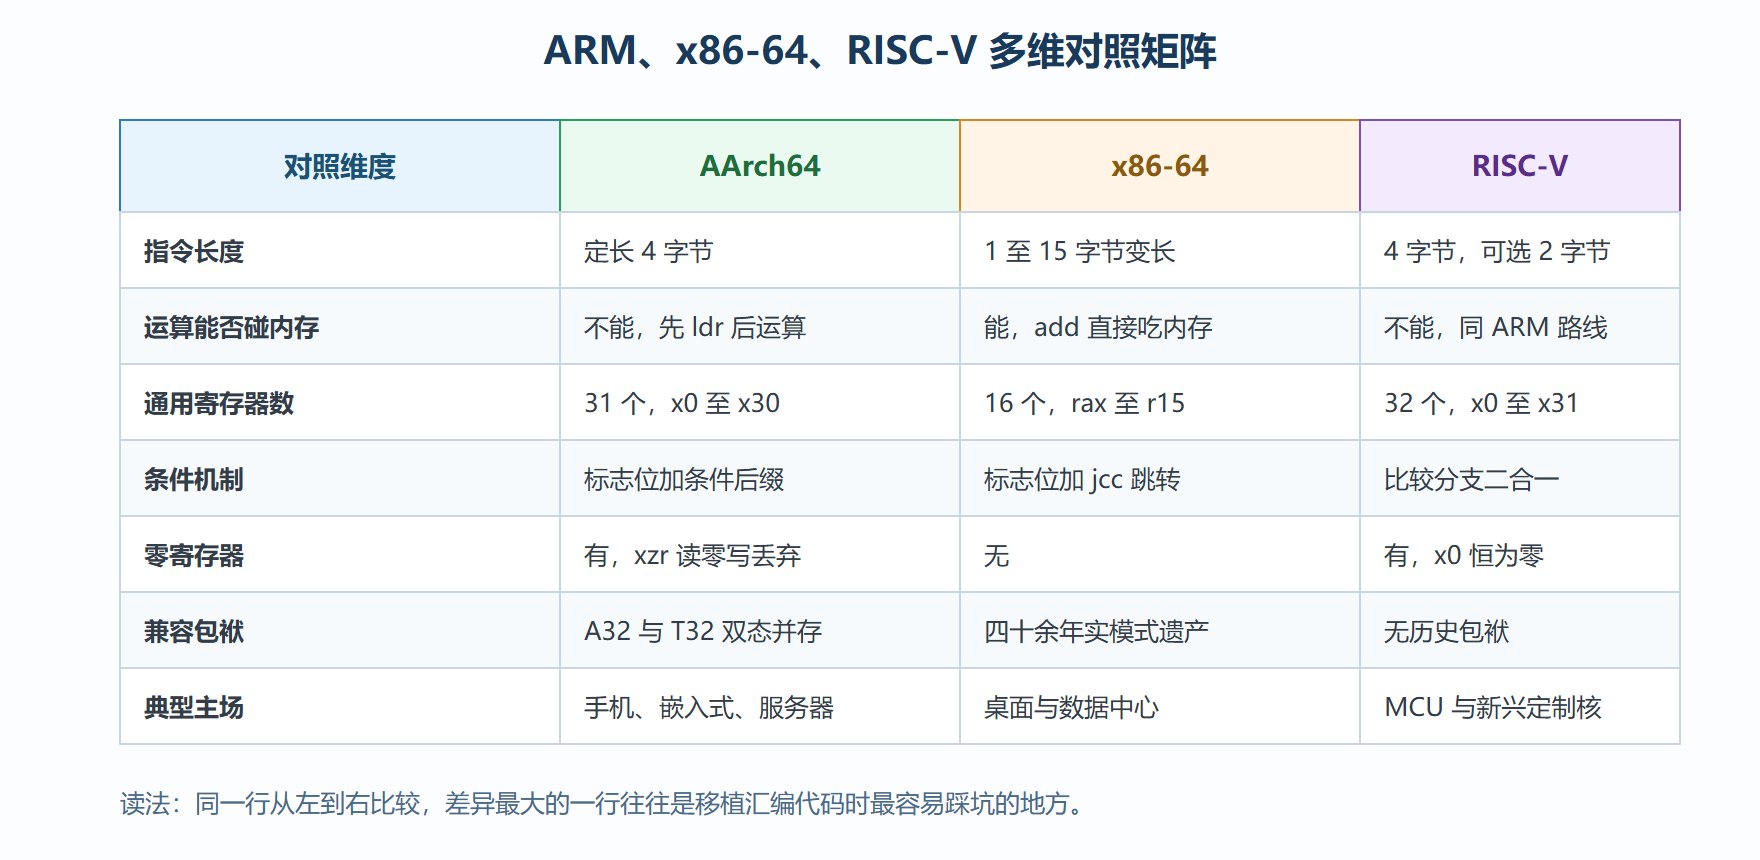
把所有差异归纳起来,真正起决定作用的是两条轴。
第一条轴:运算指令能不能碰内存。 x86 是典型的内存操作数架构,一条指令里操作数可以写在内存里;ARM 与 RISC-V 是加载存储架构,只有专门的加载与存储指令能访问内存,其余指令只在寄存器之间运算。加载存储架构的好处是指令周期好控制、流水线设计简单、便于优化器调度,代价是完成同样逻辑要多走一步搬运。
第二条轴:指令长度固不固定。 x86 指令从一字节到十五字节不等,译码器必须先切分才能译码;ARM 的 AArch64 把每条指令钉死在四字节,译码器不用找边界,取指吞吐稳定,代价是代码密度让位于规整——所以 ARM 后来补了 Thumb-2 混合长度编码来找回密度(第 3 章 3.3 节专门做混编实验)。RISC-V 基础指令四字节、可选压缩扩展两字节,把选择权交给编译器。
同一段"数组累加"在三种架构下的核心循环,把两条轴的差异落实成了看得见的代码。先是 AArch64:
// AArch64:加载存储架构,定长四字节 .Lloop: ldr x3, [x0], 8 // 取一个元素,x0 后索引自增一个 long 的宽度 add x2, x2, x3 // 只在寄存器里累加 sub x1, x1, 1 cbnz x1, .Lloop
x86-64 的同一段逻辑(Intel 语法):
; x86-64:运算指令直接吃内存操作数,变长编码 .Lloop: add rax, QWORD PTR [rdi] // 读内存、累加,一条完成 add rdi, 8 // 指针前移 dec rsi jne .Lloop
RISC-V 的 RV64I 版本:
# RISC-V:与 ARM 同属加载存储架构,但编码更省 .Lloop: ld a2, 0(a0) # 取元素,地址不加偏移变化 add a1, a1, a2 # 累加 addi a0, a0, 8 # 指针前移,addi 是唯一带立即数算术的入口 addi t0, t0, -1 bnez t0, .Lloop
三段代码读下来,两条轴立刻显形:x86 用一条指令干了 ARM 与 RISC-V 各用两条干的事;ARM 的 ldr 自带后索引自增把指针移动合并进加载,RISC-V 则连条件执行都没有,靠 bnez 纯跳转。谁更"优"?没有答案——在缓存未命中的场景里,内存访问延迟吞掉一切,指令数的差异被淹没;在译码器压力大的超标量实现里,定长编码又占尽便宜。工程上这是取舍,不是优劣。
图 1-2:三架构多维对照矩阵
二、从对照里学到的三件事
第一,寄存器名字不同,分工相通。x86 的 rax 常当累加器、rsp 是栈指针、rip 是程序计数器;ARM 的对应角色是 x0 系列加 sp 加 pc,RISC-V 是 a0 系列(参数)加 sp 加 pc。调用约定都规定"前几个参数走寄存器、返回值放固定寄存器",只是名额与编号不同——第 5 章 AAPCS 一节会把 ARM 的约定推到栈帧级。学会"按角色认寄存器",跨架构阅读就不需要死记名字。
第二,条件执行的取舍是 ARM 的个性。x86 与 RISC-V 的条件都靠跳转实现,ARM 却给大量指令配了条件后缀(AArch64 收敛为少数 csel 类指令,AArch32 则几乎条条可条件化)。这源自早期 ARM 无分支预测硬件、条件执行能省掉跳转开销的历史。今天它退化成一个精巧的小工具:csinc x0, x0, xzr, eq 一条指令完成"等于则加一",免掉两个分支。类似的"历史遗产变成现代工具"的故事,第 2 章 2.1 节版本演进里还会遇到。
第三,定长编码是理解 ARM 一切格式的钥匙。四字节定长意味着编码格式可以排成有限的几类模板,第 3 章 3.2 节我们会亲手拆一条 mov,你会发现所有字段都按固定位置躺好。x86 的变长指令则没有这种"地图感",这也是本教程选择 AArch64 做主编码的原因之一。
三、动手:用同一编译器产出三种汇编
对照不必靠想象。手头有交叉工具链的话,同一个 C 文件可以产出三种汇编并排看:
aarch64-linux-gnu-gcc -O2 -S sum.c -o sum_arm.s x86_64-linux-gnu-gcc -O2 -S sum.c -o sum_x86.s riscv64-linux-gnu-gcc -O2 -S sum.c -o sum_riscv.s # 三个文件里的循环体就是上面三段代码的出处,可逐行对照
一个值得动手验证的变式:把累加元素类型从 long 改成 char,观察三家的加载指令如何各自处理符号扩展——ARM 用 ldrsb(带符号字节加载),x86 用 movsx,RISC-V 用 lb。名字完全不同,语义却一一对应。做完这个实验,"跨架构对照"就从知识变成了技能。
本节要点回顾
- 两条设计轴:运算能否碰内存、指令长度是否固定,决定了三种汇编的全部气质差异。
- 加载存储架构:ARM 与 RISC-V 只许加载存储指令碰内存,指令多而语义简单,流水线友好。
- 内存操作数架构:x86 一条指令可以取数运算写回三件事齐做,指令少而译码复杂。
- 按角色认寄存器:参数寄存器、栈指针、链接寄存器的分工三家相通,名字不同而已。
- 同编译器对照法:一份 C 源码产出三种汇编并排读,是跨架构学习最快的路径。
三军对照看完,接下来该把镜头对准 ARM 自己的家底了——下一章我们走进寄存器版图与编程模型,看看处理器"手里"到底有哪些牌。