5.2 曲线与大库基准
5.2 曲线与大库基准
本节摘要:单个阈值只给你一个点,曲线给你系统在"任意阈值"下的全貌。本节讲清 ROC 曲线与 AUC(据识别二分类)、CMC 曲线与 Rank-k(据大规模 1:N 搜索),并用 SVG 示意把两条曲线的读法摆到眼前,最后落到 LFW、MegaFace、IJB 这些公开基准该怎么读、别被哪句话带偏。
单点测不准,用曲线看全貌
想象一个门禁,你把它调得极宽——几乎逢人放行,误识率就高;又调得极紧,拒识率就高。可究竟哪个阈值"好"?单看一个阈值测出来的 FAR/FRR 回答不了。你要的是"把阈值从最严拨到最宽,画出一条性能轨迹",再拿整条轨迹判断系统本身强不强。曲线干的就是这件事:曲线弱化阈值的影响,让你看清"模型底子"有多硬。
曲线还有一个好处:它让你在两位供应商之间做公平比较时,不必纠结于"他们用的阈值和我不同"。只要比 AUC 或整条 ROC 走向,就能看谁底子更硬。
ROC 与 AUC:不加阈值的诚实
ROC(受试者工作特性)以"误识倾向"(FAR)为横轴、以"正确接受倾向"(TAR/Recall)为纵轴:把阈值从最严拖到最宽,画出的轨迹越贴近左上角越好。曲线下的面积 AUC 就是系统"随机遇到一对正负样本,能把正样本排得更靠前"的概率度量——AUC 越大越强,且它不依赖阈值,适合跨方案公平比底子。
一个小细节:ROC 在类别极度不平衡时可能过于乐观,此时可以看 PR 曲线(精确率-召回率曲线)作为补充——PR 对不平衡更敏感,更能反映"正样本少"场景下的真实表现。
CMC 与 Rank-k:搜索人的读法
ROC 回答验证(1:1);可你要是做 1:N 搜索(在海量库里找"这人是谁"),问题变了:答案是不是出现在候选名单靠前的位置。CMC 曲线以"候选名次"为横轴,累计正确命中率作纵轴。Rank-1 指"第一名就是对的"的概率,Rank-5 指"前五名里有对的"的概率。通常 Rank-1 越高,大库找得越准。
CMC 曲线前期抬升越快,说明系统把正样本排到靠前名次的能力越强。如果 Rank-1 不高、但 Rank-5 明显更高,说明识别器"大致能缩小范围"但精确度不够——这种场景在人工复核时还能接受,在纯自动闸机上就不够。
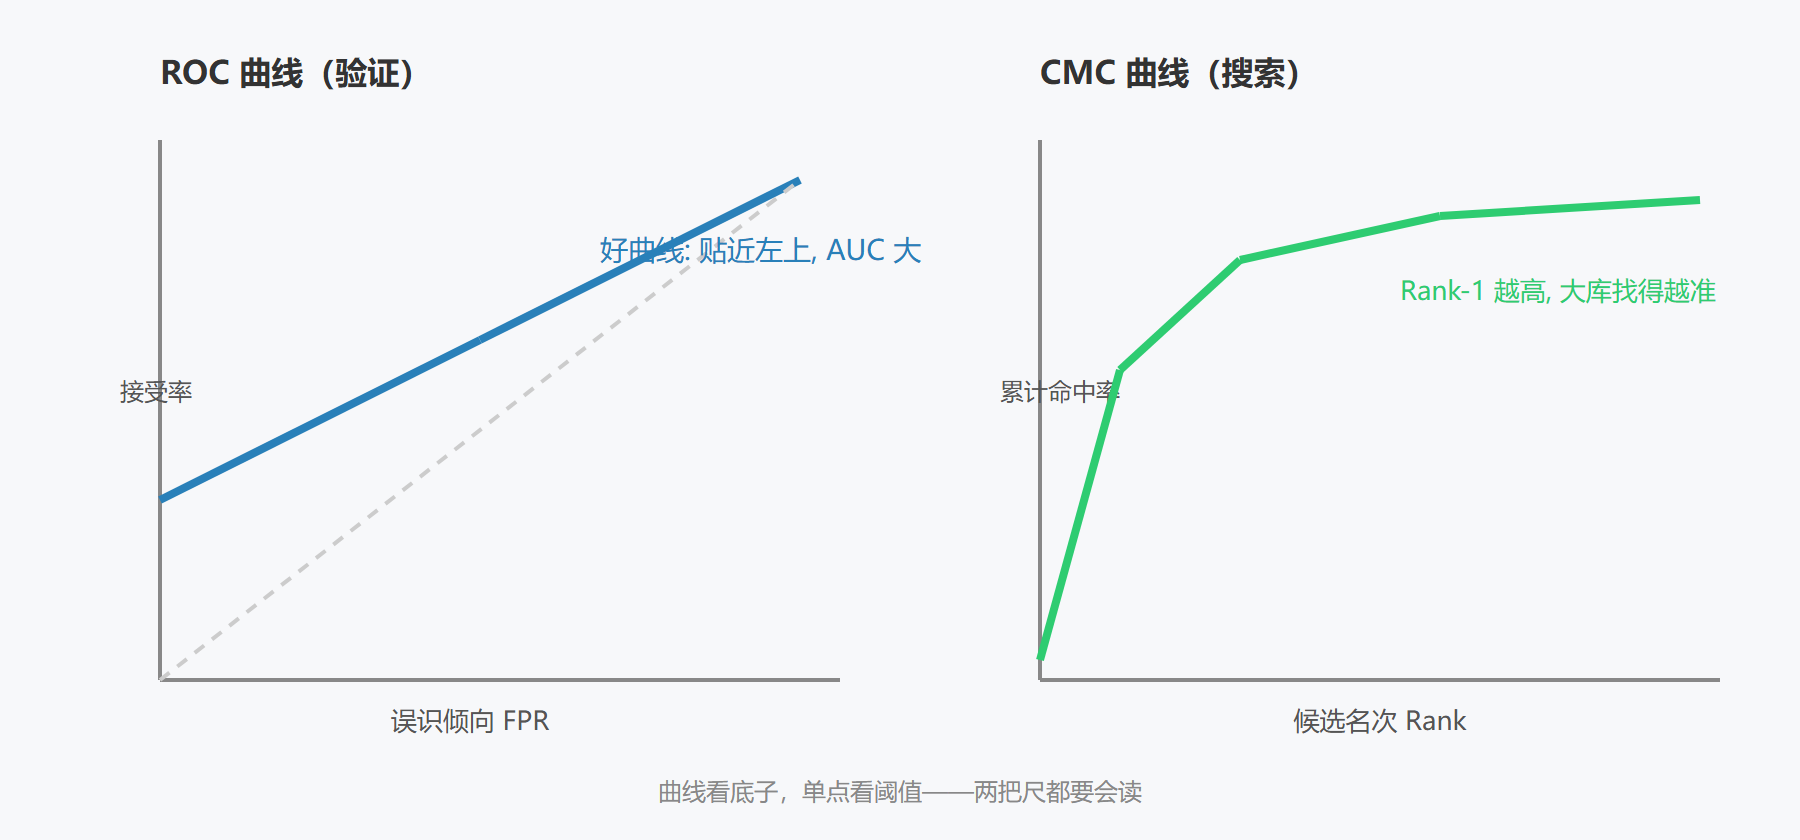
两条曲线各回答什么
左边 ROC 判断"验证做得好不好",越贴左上、AUC 越大越强;右边 CMC 判断"大库搜索找得稳不稳",曲线前期抬升越快、Rank-1 越高越好。两条曲线回答了两种不同的"行不行"。
公开基准怎么读
- LFW:毕竟小库老基准,主流新模型早已刷到 99%+,它已筛不出差距,别拿它当"天日"——一个 LFW 成绩 99.5% 的模型在你的场景可能只有 80%。
- MegaFace、MS-Celeb:更大库、更难,接近真实开放规模,适合见识排名。但要注意,跑 MegaFace 的不同口径(选什么子集、用什么对齐)会直接影响排名,别直接横向对比不齐口径的成绩。
- IJB 系列:含视频与真实场景,尺度更贴近落地,参考价值高。IJB 的挑战在于它更接近"在"真实条件下"的测试,跨姿态、跨光照、跨分辨率都有涉及,比 LFW 更接近生产感受。
读基准报告,一律先问三句:在哪个子集测的、用什么对齐、用什么阈值。否则数字再漂亮,搬到你的场景也要翻车。
| 基准 | 规模/性质 | 用途 | 警惕点 |
|---|---|---|---|
| LFW | 小库老基准 | 验证冒烟 | 新模型已刷到 99%+,筛不出差距 |
| MegaFace/MS-Celeb | 大库 | 见识开放规模排名 | 口径不同,别直接横向比 |
| IJB 系列 | 含视频、真实场景 | 贴近落地参考 | 对齐与阈值口径必须对齐 |
工程实践要点
- 验证(1:1)看 ROC/AUC,搜索(1:N)看 CMC/Rank-k,别拿错尺——用 Rank-1 吹"验证准确率"是常见错误,验证与搜索是两码事。
- 报性能多给曲线,既讲阈值对应的 FAR/FRR,又给 AUC/Rank-1,别人才能独立判断你的系统有多稳。
- 用公开基准对齐口径,但单独用贴近你线上条件的集做冷启动验收——别人库的红,不代表你能红;你的数据分布才是唯一的标准。
- 公开基准的"满分"不意味着你的模型在你场景上也满分,引论文时带一句"在 LFW 上 99.5% 但在我们场景上 92%",才是负责任的表述。
一句话直觉:ROC 是"评价模型底子的尺",不依赖阈值;CMC 是"评价搜索定位能力的尺",看头几名。两把尺合起来,才能把一个识别系统说清楚。
一个容易误读的点:AUC 不是一切
AUC 是个好用的"单数",但它只反映"随机碰到一对正负样本能排对"的整体能力,不一定贴合业务。比如你真正在乎的是"FAR 必须在千分之一以下",那即使 AUC 很高,也不能保证在你要的那个极端阈值下 FRR 可接受——因为 AUC 是整条曲线下的面积,它把"你最在乎的那一段"和"你不怎么在乎的那一段"平均在一起。所以报性能时,除了 AUC,还应给出你最想用的那个阈值对应的 FAR/FRR 专栏。否则光看一个大 AUC,很容易高估系统在真实工作点的表现。
Rank-k 读细节:Rank-1 不高时别急着放弃
做 1:N 搜索时,Rank-1 不够高,不代表系统没用。更细的读法:看 CMC 曲线在 Rank-1、Rank-5、Rank-20 这几个点抬升得快不快。如果 Rank-5 明显高于 Rank-1,说明识别器"能把候选缩到一个很小的范围、但第一名常常选错"——这种系统配合人工复核完全可用,但纯自动闸机就不够。所以用 CMC 判断时,要结合你"是否需要自动化放行"来决定该押 Rank-1 还是可以靠人工补一个 Top-k 段。给不同业务不同的 Rank 要求,才算读懂了曲线。
公开基准成绩单的一行怎么读
拿到一份模型 report,别只看一个准确率扎眼。把"库、对齐、阈值、样本难度"四件事对着看:库决定了难度上限,对齐决定了口径是否与本项目可比,阈值决定了它报的是哪一点而不是整条曲线,样本难度决定它到底在测什么。合格的报告至少会写"在某对齐下、某子集、某 FAR/FRR 对应的分数";只给一个准确率、还不说条件的,多半经不起推敲。把这套"追问四件套"用起来,你才不会被一句漂亮的 99% 牵着走——这也是跨方案公平比较的底线。
评估的尺都备好了。下一章把这些尺伸进真实世界,看同一个"断案台"在各行各业怎么跑、该以哪个指标验收。