5.1 混淆矩阵与核心指标
5.1 混淆矩阵与核心指标
本节摘要:评估人脸识别,起点是一张混淆矩阵——它把每一次认人判定放进四个象限:真阳、假阳、真阴、假阴。从这四象限出发,准确率、精确率、召回率、F1、误识率、拒识率、等错误率逐一定义到位。本节沿用"断案台"比喻讲透这些指标,并让你分清"整体准不准"和"放行/拦阻划得高不高明"是两回事。
一句"准确率 99%"先别信,拆开看四格
如果有人说"我这个人脸识别系统准确率 99%",你该立刻多想一步:它是在什么库上测的?如果说这是一个"99% 都陌生人"的闸机,系统只要逢人都拒掉、几乎不认人,也会有漂亮的准确率,因为"拒绝陌生人"本来就容易蒙对。这说明:准确率一个数字扛不起"行不行"的全部,你要靠一套指标组合来看清各环节。
这里有个更扎心的例子:假如闸机上 99% 的人是陌生人,一个"逢人全拒"的机器人准确率就是 99%——它一个真人都没放过,但客户会满意吗?所以要拆开看,看它在"该放行的"和"该拦下的"两头各做得怎样。
从一次判定到四格
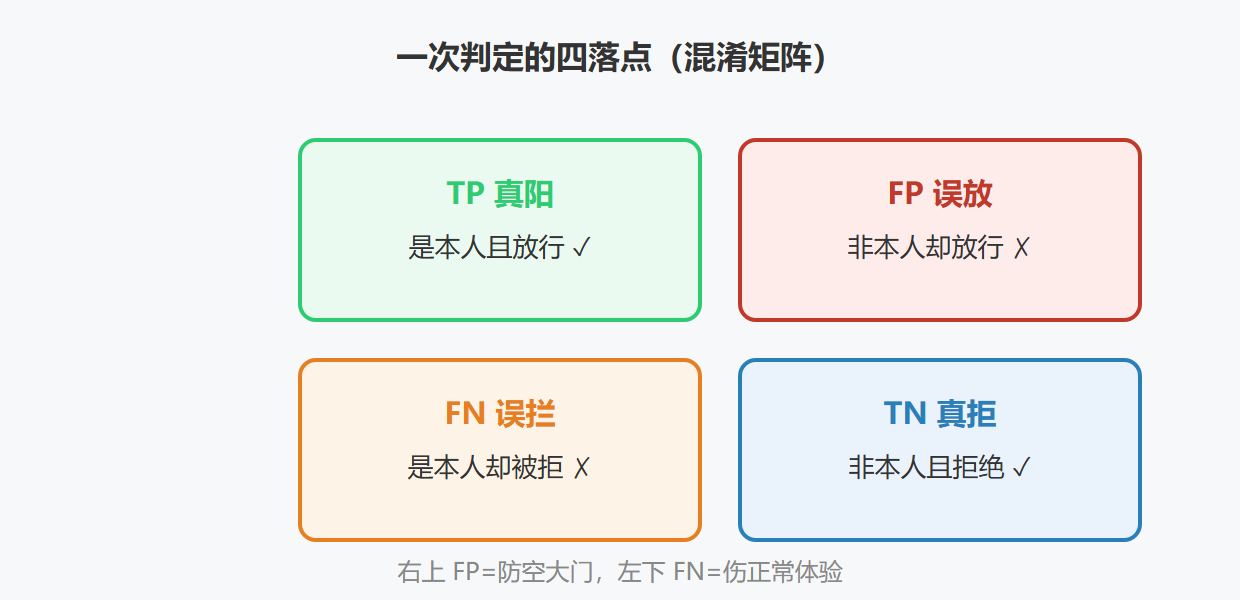
把"待核验是否本人"当成一次二分类。每次判定落在四格之一:
- 真阳(TP):目标确实是本人,系统也放行了。
- 假阳(FP):目标不是本人,系统却放行了——这就是"误放",安防最忌的事。
- 真阴(TN):目标不是本人,系统正确拒绝。
- 假阴(FN):目标是本人,系统却拒绝——这就是"误拦",本人被错拒。
后两格(FP、FN)正是"错放"和"错拦"两种麻烦的分身,也是场景取舍的起点:有些场景宁可错拦也别错放,有些正好相反。
六个公式与它们防什么
def summarize(tp, fp, tn, fn): acc = (tp + tn) / (tp + fp + tn + fn) # 整体对的比例 prec = tp / (tp + fp) # 放行的里真本的比例 rec = tp / (tp + fn) # 真本里被放行的比例 f1 = 2 * prec * rec / (prec + rec) far = fp / (fp + tn) # 陌生人被放行的比例 frr = fn / (tp + fn) # 本人被拦的比例 return dict(acc=acc, prec=prec, rec=rec, f1=f1, far=far, frr=frr) print(summarize(tp=9, fp=1, tn=8990, fn=1))
看这组数:准确率高达 99.98%,但看 frr,本人被拦了 10%——对用户体验来说是灾难。这就是准确率骗人的那一眼:库越"多数是陌生人",正确拒绝越容易把准确率垫高。
- 准确率 Accuracy:(TP+TN)/全部,整体对不对,但被类别不平衡欺负。
- 精确率 Precision:TP/(TP+FP),"放行的里头有多少是真人",越严越值钱。
- 召回率 Recall:TP/(TP+FN),"真该放行的里头放出了多少",越宽越不漏。
- F1:两者调和,要在放得对和放得全之间取平衡时的综合分。
精确率与召回率天然互斥:想放得全(召回高)就得多放,误放也上来(精确掉);想放得对(精确高)就得收紧,真人也可能被拦(召回掉)。场景决定押哪头。
误识率、拒识率与等错误率
识别场景最关心的其实是另两个率:
- 误识率 FAR:把陌生人错当本人放行的比例(防"假证放行")。所有"放行"类场景最怕它。
- 拒识率 FRR:把本人错当陌生人拦下的比例(伤正常体验)。戴个墨镜就进不来,多半是它。
两者此消彼长,而等错误率 EER 正是当 FAR=FRR 时那个交叉点——它给你一个"系统本来可以做到多均衡"的单点快照,EER 越低越好。但注意 EER 只是一个均衡参考,不是目标本身:真实系统往往要故意偏离均衡(宁可多点误拦,也别多点误放),所以 EER 之外还要按场景代价定阈值。
| 指标 | 公式 | 防什么 | 在断案台的对应 |
|---|---|---|---|
| 准确率 | (TP+TN)/全部 | 整体对错(但被不平衡骗) | 总判对率 |
| 精确率 | TP/(TP+FP) | 放行的里头真本的纯度 | 物证放行前再审 |
| 召回率 | TP/(TP+FN) | 真本里别漏放 | 真凶别错过 |
| FAR | FP/(FP+TN) | 陌生人被错放 | 假证被放行 |
| FRR | FN/(TP+FN) | 本人被错拦 | 真凶被拦门外 |
| EER | FAR=FRR 交叉点 | 均衡参考 | 断案台的最佳平衡点 |
工程实践要点
- 高安全场景押精确/FAR(放行谨慎),强体验场景押召回/FRR(别错拦真身)。
- 报指标永远带上"在什么库、什么阈值、什么分布下测的",否则"99%"这种话无从判断——数值脱离语境没有意义。
- 挑阈值要对准你自己的"误放代价/误拦代价",别抄别家默认值;EER 只是一个参考锚点,不是决策本身。
- 识别频率低但代价高的安防,倾向压 FAR;识别频率高但体验要紧的解锁、支付,倾向压 FRR——把"场景代价"和"指标"绑定起来,比背公式有用得多。
一句话直觉:指标是给"断案结论"打分的尺。想防"错放"就看 FAR,想防"错拦"就看 FRR,想在两者间找平衡就看 EER——但最终要回到你的场景代价去定阈值。
一个把四象限盘清的实战例子
设你部署了一套闸机门禁,一天里有一千次真实刷脸,其中 990 次是登记过的本人、10 次是陌生人试图闯入。假设系统的判定是:放行 9 个本人、漏放 1 个本人(把这个本人误拦了),同时误放了 1 个陌生人。套进四象限:TP=9、FN=1、FP=1、TN=9。这时准确率是 (9+9)/20=90%,看起来还行;但真正该盯的是 FAR=1/10=10%(陌生人十个里放进一个,安防不可接受)和 FRR=1/10=10%(本人十个被拦一个,体验差)。同样的数字,在不同场景眼里天差地别——这个例子就是想强调:脱离场景谈一个准确率,等于数字会骗你。
保守还是宽松:由"误放/误拦代价"定
在定阈值时,很多团队纠结"精确率要高还是召回率要高"。真正的答案是看两类代价:一次误放(FP)要付出的代价(安全事故、资金损失),和一次误拦(FN)给正常用户造成的代价(要人工复核、重刷)。代价越不对称,阈值就越应向代价小的一侧偏安全。给这两个代价各打个"高/中/低"的客观分,比拍脑袋定阈值靠谱得多;再拿你自己的 FRR/FAR 曲线在对应代价上挑一个平衡点,而不是照抄别家默认阈值——这才是把指标用出工程价值的方式。
指标已经认识全了。可光看单点不够,下一节我们用"曲线"看系统在任意阈值下的全貌,并学会读大库成绩单。