1.4 选型对比:Atlas、OpenMetadata与Amundsen
1.4 选型对比:Atlas、OpenMetadata与Amundsen
本节摘要:开源元数据平台的主流候选是 DataHub、Apache Atlas、OpenMetadata 与 Amundsen 四家。本节从架构取向、血缘能力、模型扩展性、运维复杂度、社区生态五个维度做横向比较,给出按场景决策的选型路径:重治理与 Hadoop 生态选 Atlas,重发现与轻量起步选 Amundsen,重一体化与标准化选 OpenMetadata,重规模化、字段级血缘与模型扩展选 DataHub。本节是第 1 章的落脚点,结论直接服务于立项决策。
先把一个问题说透
选型讨论最常见的开场是"哪个功能多",但这恰恰是最不重要的维度——四家的功能清单拉出来都足够长。真正该问的是:**每家平台为哪个场景而生,它的架构取向在什么条件下会成为优势或负担。**就像选测绘设备,纠结"谁的镜头多"没有意义,关键是进山还是进沙漠。
四家的出身决定了性格。Atlas 从 Hadoop 生态的治理需求里长出来,核心用户是 Hive 为主的传统数据平台;Amundsen 出自 Lyft,出发点是让工程师像搜代码一样搜数据,发现体验是它的灵魂;OpenMetadata 强调一体化与标准化,模型、API、采集调度打包交付;DataHub 从 LinkedIn 的超大规模数据环境里演化而来,目标是成为组织的元数据操作系统,规模化与扩展性刻在架构里。
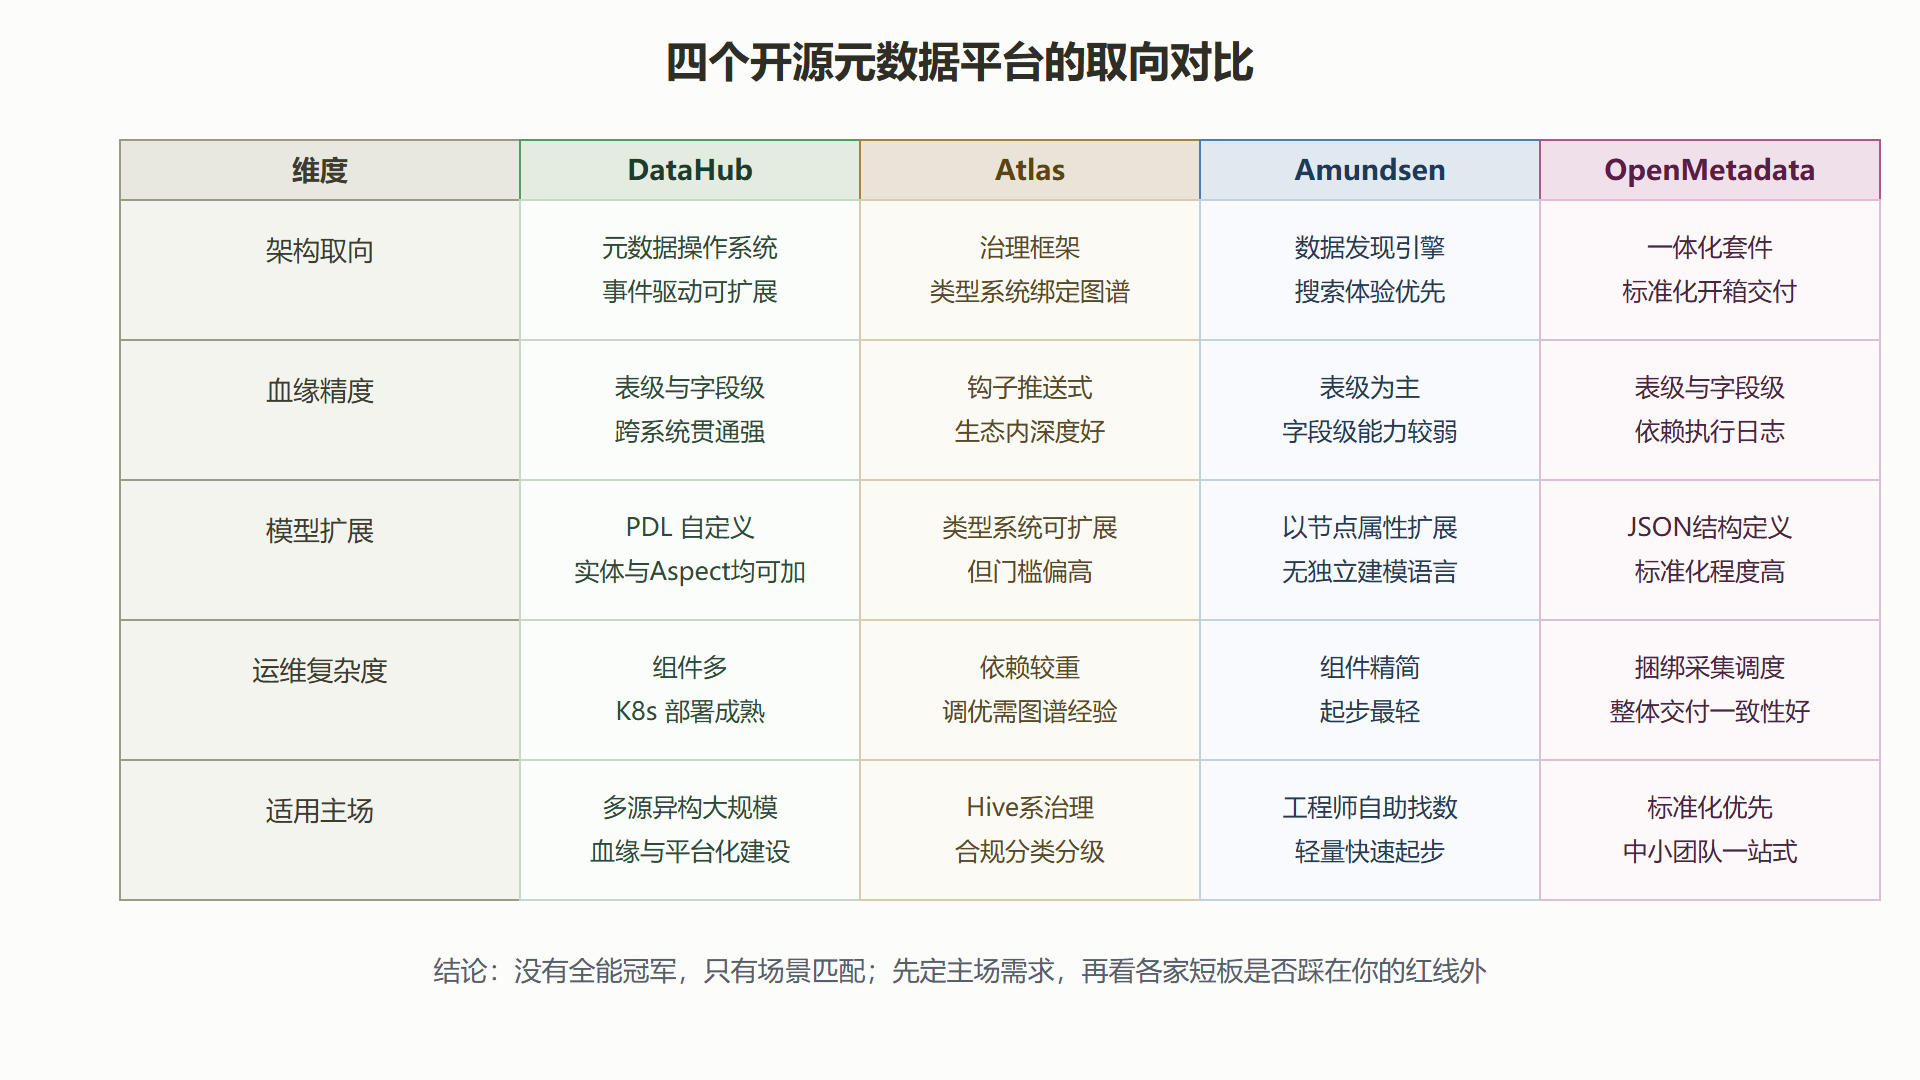
图4 四平台选型对比矩阵
五个维度的差异展开
架构取向。 Atlas 的中心是一个绑定类型系统的图谱服务,治理分类与图谱强耦合,好处是治理语义统一,代价是扩展与运维都要懂图谱内部。Amundsen 是"前端加元数据服务加搜索服务"的三件套,结构简单直接。DataHub 把元数据服务 GMS 作为中枢,底层用文档存储加图存储加搜索索引的组合,变更以事件方式扇出,任何一个存储层都可以独立替换或扩容——这种取向在大规模下是优势,小团队用会觉得组件偏多。OpenMetadata 选择把采集调度器直接捆绑进来,交付一致性好,但也意味着采集流程要跟着它的调度体系走。
血缘能力。 这是差异最大的维度。DataHub 支持表级与字段级血缘,血缘来自 SQL 解析、任务框架集成等多种渠道,跨系统拼接是它的常规用法。Atlas 在 Hive 生态内的钩子式推送做得很深,出了生态就依赖自定义钩子。Amundsen 的血缘相对基础,通常止步于表级。OpenMetadata 依靠执行日志推断血缘,字段级支持在持续增强,但覆盖面依赖连接器的成熟度。如果你的核心诉求是"改一个字段前看清全部下游",这一条的权重应当占到选型的一半。
模型扩展性。 DataHub 的 PDL 建模允许业务定义全新实体与 Aspect;Atlas 的类型系统理论可扩展但操作门槛高;Amundsen 倾向于在既有节点上加属性;OpenMetadata 用标准结构定义模型,规范但受框架约束。计划把元数据平台当基础设施深度定制(比如接入特征平台、指标平台)的团队,应重点考察这一条。
运维复杂度。 组件数量大致是 Amundsen 少于 OpenMetadata 与 DataHub,Atlas 的图谱调优则需要专门经验。四家都有容器化部署方案,差别在于社区踩坑资料的数量——DataHub 与 Atlas 的生产案例多,出问题时的搜索命中率更高。
社区生态。 四家都在活跃迭代,但节奏与风格不同。DataHub 的连接器数量与发版频率处于第一梯队,Atlas 背靠 Apache 基金会生态稳定,Amundsen 社区偏精悍,OpenMetadata 版本迭代快。评估时建议直接看近半年的发版记录与问题响应速度,而不是社区星标数。
一条可执行的选型路径
把决策收敛成三个问题。第一问:**你的核心场景是发现、治理还是血缘?**发现为主看 Amundsen 与 DataHub,治理为主看 Atlas,血缘与平台化看 DataHub 与 OpenMetadata。第二问:**你的数据栈是什么底色?**Hive 重且无大规模定制计划,Atlas 顺手;云数仓加多工具混用,DataHub 的连接器面更宽。第三问:**团队未来三年要把元数据平台用到什么深度?**只做目录,任何一家都能撑住;要长成内部数据基础设施,模型可扩展性就是硬指标,DataHub 的 PDL 与事件架构在此有明显余量。
⚠️ 选型演示(POC)阶段务必用自己的真实数据源测血缘,尤其是字段级血缘的准确率。厂商演示用的是标准场景,而你的数仓里躺着十年历史的"祖传 SQL"——血缘解析器对它们的兼容性,只有实测才知道。
本册以 DataHub 为主线展开,不是因为它是全能冠军,而是因为它的取向适合"把元数据当基础设施建"的路线。若你的选型结论是其他平台,本章的维度框架依然适用。
选定之后的验证清单
结论落地前,用两周的验证期把口头承诺变成实测记录。清单四项,每项都有明确的通过标准。
血缘实测:挑十个真实的加工任务——必须包含存储过程、多跳嵌套、字段重命名这类"祖传写法"——在候选平台上跑出血缘,人工核对边数与字段映射的准确率。通过线建议定在八成:低于它,意味着上线后你要长期人工补血缘。模型验证:把组织里一个真实资产类型(比如指标或特征)的建模需求拿到候选平台上走一遍自定义流程,记录从写模型到生效的耗时与踩坑数——这一步测的是 3.3 节那套流程在候选平台上的等价物有多重。运维压力:模拟一次索引重建与一轮全量摄入,记录耗时、资源占用与对查询的影响。小数据量下四家都流畅,差距只在接近你的真实体量时才显现。集成预演:让调度系统与一个 BI 工具各完成一次真实接入,配置的复杂度与文档的准确度,直接反映未来每个源的接入成本。
验证期结束,四份记录放在一起,选型会从"信仰之争"降维成"读数之争"。最后提醒一点:验证结论要写成对照本文档维度框架的评分表归档。一年后复盘选型质量、或新平台想再敲门时,这份档案是最省事的参照系。
如果四家都不完全合适怎么办? 常见于两种情形:数据栈过于冷门(自研平台占大头),或组织已有自建的目录系统想要渐进升级。此时的答案通常不是"选一个最不差的硬上",而是把候选平台当作元数据中枢,自研部分交给 4.3 那样的自定义连接器补齐——模型可扩展与 API 开放度,正是这种混合路线可行性的两个决定项,回到对比矩阵的第一行与第三行看分数。
清单之外,把验证期的两个坑提前标出:一是用厂商准备好的演示环境跑验证,读数全部失真,务必接自己的数据源;二是验证期太短没覆盖批处理窗口,血缘与摄入的真实负载要等定时任务跑过一整个周期后再读数。
本节要点回顾
- 出身决定性格:Atlas 长于治理、Amundsen 长于发现、OpenMetadata 长于一体交付、DataHub 长于规模与扩展。
- 血缘是最大分水岭:字段级、跨系统的血缘能力各家差异显著,权重应按核心诉求分配。
- 运维换功能:组件多的平台换来的是可替换与可扩容,小团队要用轻量方案对冲。
- 三问收敛法:核心场景、数据栈底色、三年深度,三问即可把选型收敛到一到两个候选。
- POC 实测原则:血缘准确率必须用自家真实任务验证,演示场景不构成依据。
选型落定,接下来进入仪器室。第 2 章拆开 DataHub,看它的架构如何支撑上述这些能力承诺。