1.3 手工 SQL、视图分层与 dbt 的方案对比
1.3 手工 SQL、视图分层与 dbt 的方案对比
本节摘要:在决定是否引入 dbt 之前,值得先把行业里常见的三种转换组织方式摆在一起:随写随扔的手工 SQL、有分层的视图方案、以及 dbt 的模型工程。本节从依赖管理、口径一致性、测试验收、文档传承四个维度逐项对比,并给出一个判断框架:什么规模的团队该停在哪种方案上。结论先行——方案没有绝对优劣,匹配团队规模与数据复杂度才是关键。
一个反例开场:视图越建越多的仓库
见过这样一个仓库:五年时间积累了四百多个视图,命名以人名拼音开头(因为不同分析师各建各的),视图引用视图平均三层,最深一层嵌套到九层。某天仓库的查询变慢,想下线一批没人用的旧视图,竟然没有人敢动手——删除任何一个视图前,都得先人肉排查它有没有被别的视图引用,而引用它的视图又可能被更多视图引用。最后这个团队的做法是:全部保留,谁也不敢动,仓库继续膨胀。
这个反例不是 dbt 的广告,它说明的是一件事:当转换逻辑的数量超过某个临界点,组织方式本身就成了最大的技术债。 手工 SQL 和视图分层都不是错误的做法,它们只是各自适应的规模有限。下面把三种方案拆开量。
三种方案分别是什么
方案一:手工 SQL 脚本。 分析师按需写查询,结果要么直接出报表,要么存成临时表。逻辑散落在个人电脑、BI 工具、调度系统各处,没有统一的家。它的优点是零门槛、启动快,一个人上午有需求下午就能出数。
方案二:视图分层方案。 团队约定若干层:贴源视图直接映射原始表,清洗视图做标准化,汇总视图做聚合,报表视图面向业务。下层不许引用上层,层层递进。这是比方案一成熟得多的做法——它已经具备了分层的骨架。但它有两个先天限制:视图本身不存数据,每次查询都要从头计算,链路一长性能迅速恶化;「视图引用视图」的关系仍然靠数据库内部依赖或人肉记忆,没有一处地方能一眼看到全图。
方案三:dbt 模型工程。 形式上和方案二很像——也是分层,也是 SQL——但三件事发生了质变:引用关系用函数显式声明,工具能算出全图;每层物化方式可选(视图、表、增量),性能可以调;测试、文档、版本控制成为与模型绑定的标准配置。可以把它理解为「方案二补齐了工程化短板之后的形态」。
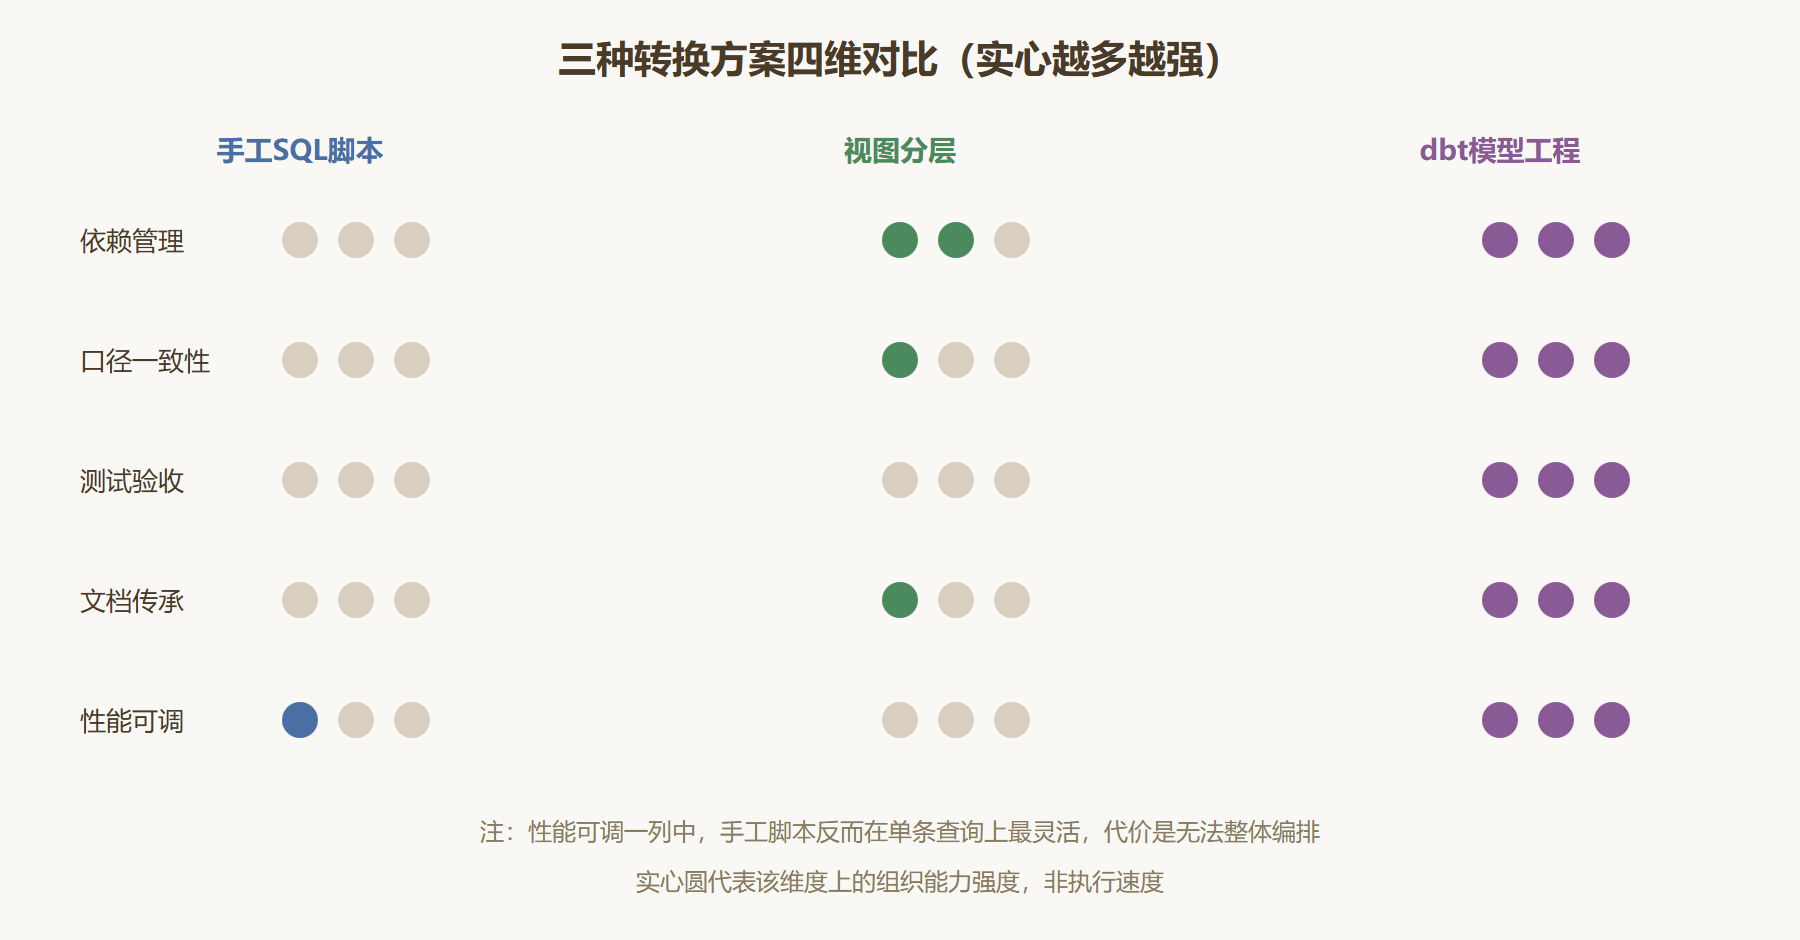
图:三种方案在四个维度上的对比矩阵
四个维度的逐项拆解
依赖管理维度。 手工方案的依赖活在人脑与全局搜索里;视图分层的依赖可以查数据库的系统表,但查出来的是一堆碎片化的引用记录,拼不成带方向的图;dbt 的依赖写在代码里,编译期即得全图,还能回答「删掉这个模型影响哪些下游」这类问题。这个维度上三者的差距最悬殊,也最没有争议。
口径一致性维度。 手工方案最容易出现「同名指标不同算法」;视图分层通过「所有人引用同一个清洗视图」部分缓解了问题,但视图可以被绕过——总有人为了方便直接查原始表;dbt 的做法是把口径层做成模型并配上测试,绕过分包的行为在文档与血缘上会直接暴露。要说明的是,工具只能让口径「被看见、被约束」,真正统一口径靠的是团队规范。
测试验收维度。 前两种方案里,数据正确性靠「跑完看两眼」;dbt 把验收变成可执行的检查项,每次构建自动运行。这是 dbt 最难被旧方案模仿的部分——测试挂在依赖图上,上游数据一出问题,下游所有相关测试立刻报警,影响范围一目了然。
文档传承维度。 手工方案交接靠文档(如果有人写的话)和口口相传;视图分层至少有数据库注释可用;dbt 的文档与代码同仓同审,改动模型不改描述会被评审者发现,文档过时的速度被流程压住了。
混合形态才是多数团队的真实处境
三个方案并排比完,还得补一句现实:多数团队不是三选一,而是三者共存。典型图景是——核心交易链路已经搬进 dbt,长尾报表还有几十个存量视图在跑,临时取数仍然是分析师手写 SQL。混合态本身不是问题,问题是没有画边界:哪类需求必须走模型、哪类允许临时查询、存量视图什么时候退役。边界没画的混合态会缓慢滑坡,新需求一条条流向「随手写个查询」那条最快的路,工程资产停止生长;边界画清的混合态则是一种务实的过渡态——存量视图按被引用次数排退役优先级,每次迭代清掉一批。所以评估自家处境时,别问「我们用没用 dbt」,问「新增转换逻辑的默认路径指向哪条」:默认路径就是团队的真实选型,其余都是存量。
迁移成本的诚实核算
选型讨论里最缺的是对迁移成本的诚实估算,这里给一个可参照的核算框架。迁移工作量集中在三处:
逻辑翻译(约占一半工作量)。把存量脚本与视图翻译成模型。不要逐字翻译——旧脚本里大量「为绕开工具限制而写的绕路代码」(手工去重、临时表接力、为跑得快而牺牲可读性的怪写法)在 dbt 里有了更好的表达。翻译时顺便做一次逻辑清洗,每个模型对照原口径写好描述与测试。
口径盘点(约占三成,且最容易被低估)。翻译过程中必然撞见「同名不同义」的旧口径:两张视图都叫「活跃用户」,窗口一个七天一个三十天。迁移不是把混乱数字化,是先裁决再数字化——每个冲突口径要有一次业务方确认,这部分的沟通量取决于历史混乱程度。
并行验证(约占两成)。新旧两套并行跑至少一个完整周期(周口径跑一周、月口径跑一个月),逐指标比对。比对工具本身也可以是个 dbt 模型:新旧表全量外连接,返回不一致行——这个「对账模型」在迁移期是最有安全感的资产。
一个二十人分析师规模、三百个视图的团队,渐进迁移的合理预期是三到六个月,前两个月收益感最强(最底层的清洗逻辑迁完后,下游口径立刻稳了)。如果有人向你承诺「两周全量切换」,那多半意味着跳过了口径盘点与并行验证——两周后会用三倍的代价补课。
选型判断框架
三个问题帮你定位:
- 团队里有几个人在写转换逻辑? 一到两个人、需求零散,手工 SQL 没什么问题,别为了方法论背上工程负担;
- 同一份明细数据是否被三处以上消费? 是的话至少需要视图分层,统一出口;
- 数据错误造成的业务损失是否已经超过工具的学习与迁移成本? 出过一次「两个部门数字打架」的事故,就值得认真考虑 dbt。
💡 关键直觉:从方案一到方案三,每往上一级,灵活性换来了组织性。个人作坊要组织性是浪费,百人团队没有组织性是灾难——判断自己处在哪个量级,比争论哪种方案更高级有意义得多。
还有一个常被问到的问题:已有大量视图的仓库要不要迁?经验是渐进式而非推倒重来:先把最底层、被引用最多的清洗逻辑迁成 dbt 模型(这部分收益最大、风险最小),让视图继续引用这些模型产出的表;逐层向上替换,每迁一层验证一次数字。三个月的渐进迁移通常比一次大爆炸切换更稳。反过来也有反方向的真实案例:业务萎缩的老系统,报表只剩两三张、月均变更一次,把它整体迁进 dbt 属于给危房做精装修——评估的第一问永远是「这块数据还有没有未来」,而不是「这个仓库还有多乱」。
本节要点回顾
- 三种方案一条主线:从手工脚本到视图分层再到模型工程,是组织性逐步压倒灵活性的过程。
- 最大差距在依赖管理:依赖显式化是 dbt 其他所有能力(排序、测试、血缘、影响分析)的地基。
- 工具不统一口径,工具暴露口径:一致性的最后一公里靠规范与评审。
- 迁移策略:底层清洗逻辑先行、视图逐层替换、每层验数——渐进优于重写。
三种方案的对比到这里收束成一个判断:如果团队规模与数据复杂度已经越线,dbt 值得引入。下一章我们进入它的内部,看编译与执行引擎是怎么把一堆 SQL 文件变成一次有序构建的。