3.4 电商数仓复盘:从建模到上线全程
3.4 电商数仓复盘:从建模到上线全程
本节摘要:本节是一次完整的端到端施工记录:一个三入电商(订单、用户、支付三类源表)的数据项目,从一页需求单出发,经分层设计、逐层实现、测试配置、调度接入,到上线验证收官。前三节的概念——分层规范、source 登记、物化选型、测试验收——在这里全部变成具体工序。跟着走一遍,你就有了自己搭项目的完整模板。
项目立项:一页需求单
需求来自运营与财务两个部门,汇总成一页纸:每天早上八点前,需要看到截至昨天二十四时的核心经营数据——成交金额、支付金额、退款金额、活跃买家数、客单价,按渠道和门店两个维度拆分;同时财务要求每月能回溯任意一天的口径版本,防止月度对账时口径漂移。
现状盘点:三类源表已经在仓库的原始区,由上游同步工具维持小时级到货;数据量量级为订单表日均百万行、存量六千万行;团队两个人,一个熟悉业务、一个熟悉 SQL;没有现成的调度平台,先用仓库自带的定时任务。
这页需求单里有三个关键技术判断,值得逐个说清。其一,订单表六千万行且每日增长,报表层必须用增量物化(2.2 节四要素法的直接应用)。其二,「按天回溯口径版本」指向了快照——口径定义本身的变更历史要留底。其三,两个人、八点交付死线,意味着测试必须全面自动化,不能指望人工核数。
图纸:分层设计与模型清单
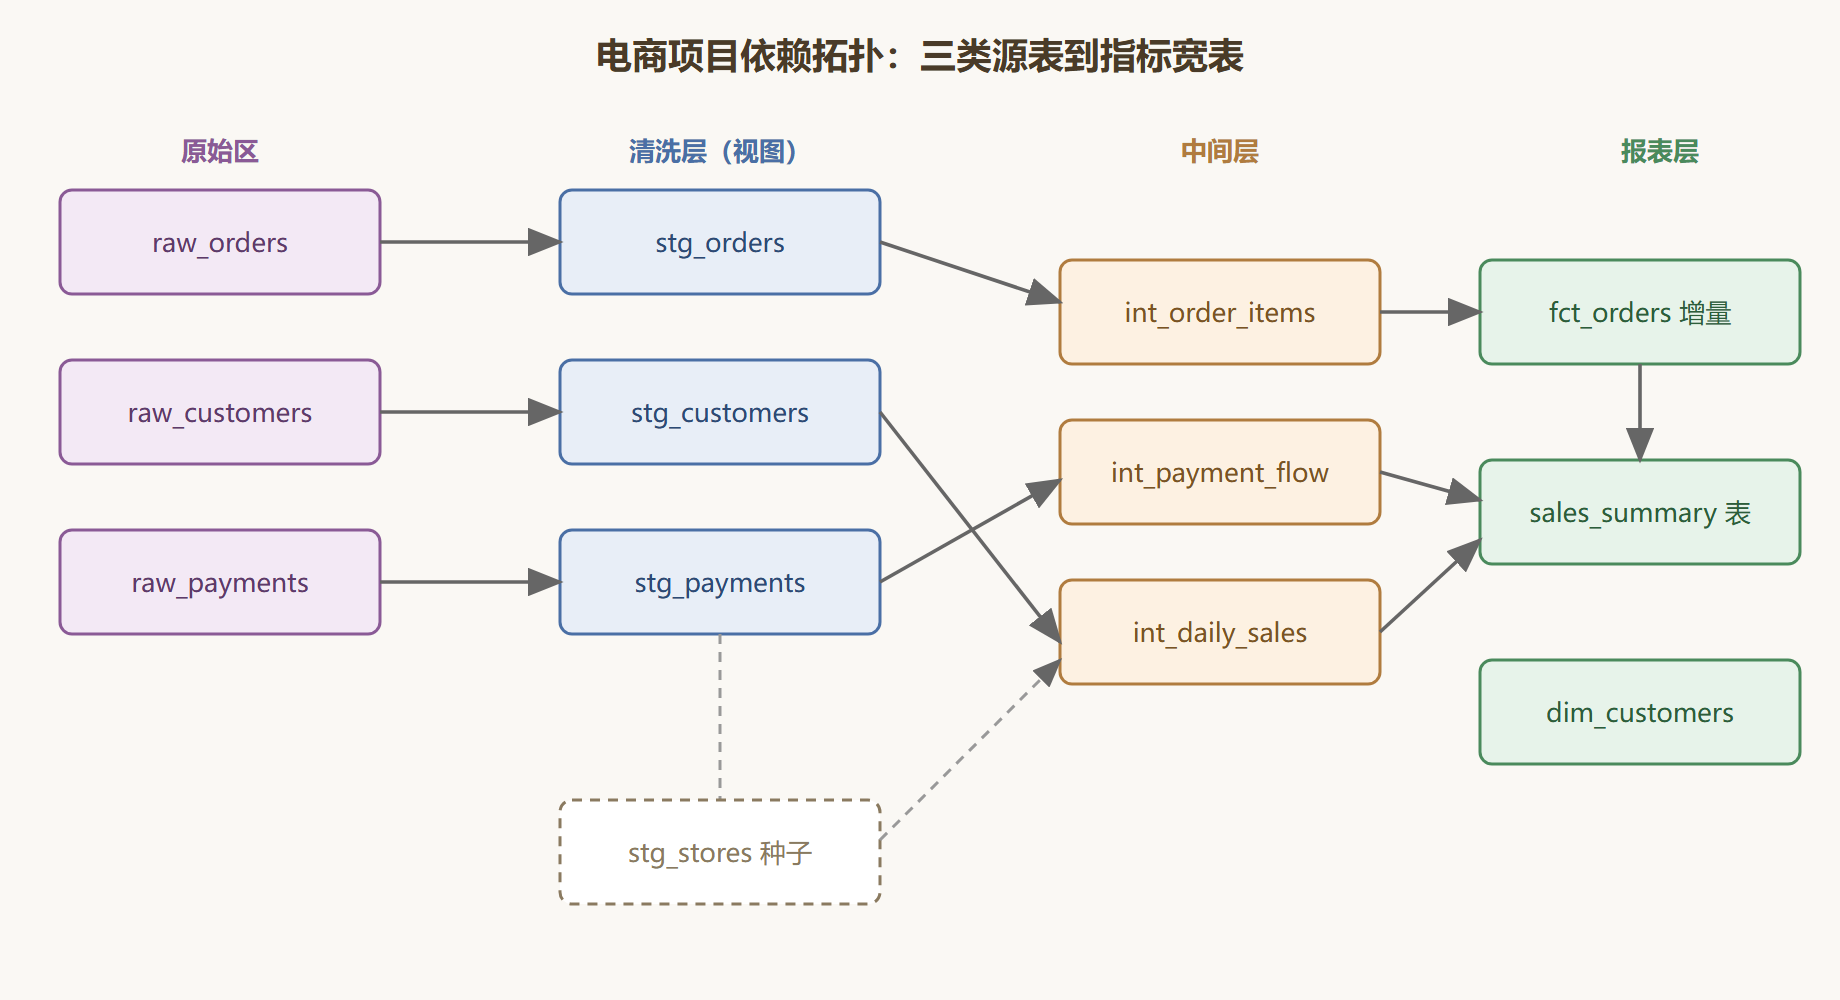
按 3.1 节的三层结构画图纸。清洗层四个模型:stg_orders、stg_customers、stg_payments、stg_stores(最后一个是种子装载的门店维表,见 3.2 节种子机制)。中间层三个模型:int_order_items(订单明细拆行与状态推导)、int_payment_flow(支付流水整理与退款标记)、int_daily_sales(按天按渠道按门店聚合的日销售中间表)。报表层四个模型:dim_customers、dim_stores、fct_orders(订单事实增量表)、sales_summary(经营指标宽表)。
每层的物化决策当场敲定并记录理由:清洗层全视图(逻辑轻、被多下游引用、不值得存两份);中间层 int_daily_sales 用表(聚合结果被三个下游引用,算一次存一份更省),其余视图;报表层 fct_orders 用增量合并(六千万行,全量重写不现实),sales_summary 用表(被看板高频查询,查询体验优先)。这张「图纸加批注」在评审会上过了半小时就定稿——花在图纸上的半小时,省掉的是后期无数小时的返工。
图:电商项目的模型依赖拓扑
施工:逐层实现的关键片段
图纸定稿后进入施工。清洗层是体力活,略过;中间层与报表层的两个关键模型值得展示。先是日销售聚合中间表:
-- 中间层:按天 按渠道 按门店聚合的日销售表 {{ config(materialized='table') }} select date_trunc('day', o.ordered_at) as sales_date, o.channel, s.region, s.city, count(distinct o.order_id) as order_cnt, count(distinct o.customer_id) as buyer_cnt, sum(o.order_amount) as gmv, coalesce(sum(p.paid_amount), 0) as paid_amount from {{ ref('stg_orders') }} o left join {{ ref('stg_payments') }} p on o.order_id = p.order_id and p.paid_at is not null left join {{ ref('stg_stores') }} s on o.store_id = s.store_id group by 1, 2, 3, 4
然后是报表层的订单事实表,全项目唯一的增量模型:
-- 报表层:订单事实表(增量合并) {{ config( materialized='incremental', unique_key='order_id', incremental_strategy='merge' ) }} select order_id, customer_id, store_id, channel, order_status, order_amount, ordered_at, updated_at from {{ ref('stg_orders') }} {% if is_incremental() %} where updated_at > (select max(updated_at) from {{ this }}) {% endif %}
施工顺序严格按依赖图自下而上:先清洗层、验证行数与源表一致,再中间层、抽查聚合数字与手工核算一致,最后报表层。每完成一层做一次「层验收」再进入下一层,错误在这一层就被消化,绝不带病向上传递——这是施工与「一把梭到最后再调试」最大的区别。
验收与上线
测试配置在实现阶段就随手挂上,不在最后补:清洗层每个模型的主键唯一与非空;fct_orders 的状态枚举与金额非负;sales_summary 挂一条业务测试——「活跃买家数不得超过当日订单数的十分之一的一百倍」这类量级哨兵(数字故意定宽,只为抓住量级级错误,如聚合键配错导致的数字爆炸);财务要求的口径版本回溯,用 2.3 节的快照机制对口径参数表拍照,每月归档。
上线的工序清单:先在新环境全量跑通一次(环境话题第五章展开);把构建命令接进仓库自带的定时任务,凌晨五点执行,前置一段新鲜度检查脚本;准备一张手工核对表,与财务上一日的手工台账逐指标比对;连续三天比对无差后,正式宣布切换,旧脚本保留两周后下线。
上线第一周出过一次小事故:周四的构建失败,原因是上游新增了一个渠道值,sales_summary 的渠道枚举测试当场拦下。因为挂在最前面,问题在五点零四分被发现,值班同学确认新渠道合法、更新测试、重跑通过,八点晨会无感。这次事故反过来验证了两件事:测试会咬人(不是摆设),上线预案有效(有明确的处理流程可循)。
复盘整个项目,三点经验值得带走:图纸先行——半小时的结构评审省掉的是以周计的返工;层验收——错误消化在它发生的那一层;测试随手挂——验收标准与代码同步生长,而不是事后补账。变式思考:如果这个项目的数据量再涨两个数量级,报表层的增量模型要开始考虑分区与聚簇(第四章调优的正题),中间层的全量聚合表可能要改成增量聚合——量变会引起工序的质变,但分层的骨架不会变。
复盘之外:如果重来一次
复盘的价值要靠「下一次怎么改」兑现。这个项目如果重做,三处会不一样:种子装载会更早接进构建流程(项目里它被排在最后,导致一次映射表变更差点遗漏装载);日销售聚合表的物化会从第一天就用表(中间曾短暂用过视图,聚合被三个下游重复计算了三天才改);上线检查单会增加「全量回放测试」一项(4.4 节档案二的教训正是从这里反哺回来的)。项目复盘永远该有这一节——「哪里做的对」用来固化,「哪里会改」用来迭代,只报喜的复盘等于没做。
本节要点回顾
- 立项先做三个判断:量级定物化、回溯需求定快照、交付死线定测试自动化。
- 图纸带批注:每个模型的物化决策连同理由当场记录,评审的是决策不是形式。
- 层验收工序:每层完成后核对行数与抽查数字再向上,不带病传递。
- 上线靠预案:新环境全量验证、定时任务加新鲜度前置、连续三日比对后切换。
- 事故是体系的试金石:上线首周的枚举拦截证明测试与预案不是纸面文章。
项目到这里已经能交付。但两个万人团队的问题还没解决:逻辑重复怎么收敛、大表慢了怎么办、报错了怎么排?下一章进入工程化的深水区。