6.4 生态集成与演进趋势
6.4 生态集成与演进趋势
本节摘要:dbt 从来不是一座孤岛——它在现代数据栈里占据「转换层」一环,与上游的数据同步、平行的任务编排、下游的 BI 与应用协作。本节画出这张生态版图,逐环讲清衔接方式与边界,给出「新工具要不要接」的判断框架,最后盘点社区正在发生的三个演进方向。作为全册收尾,这一节也是把前五章的知识放回行业坐标系的一次定位。
独木不成林
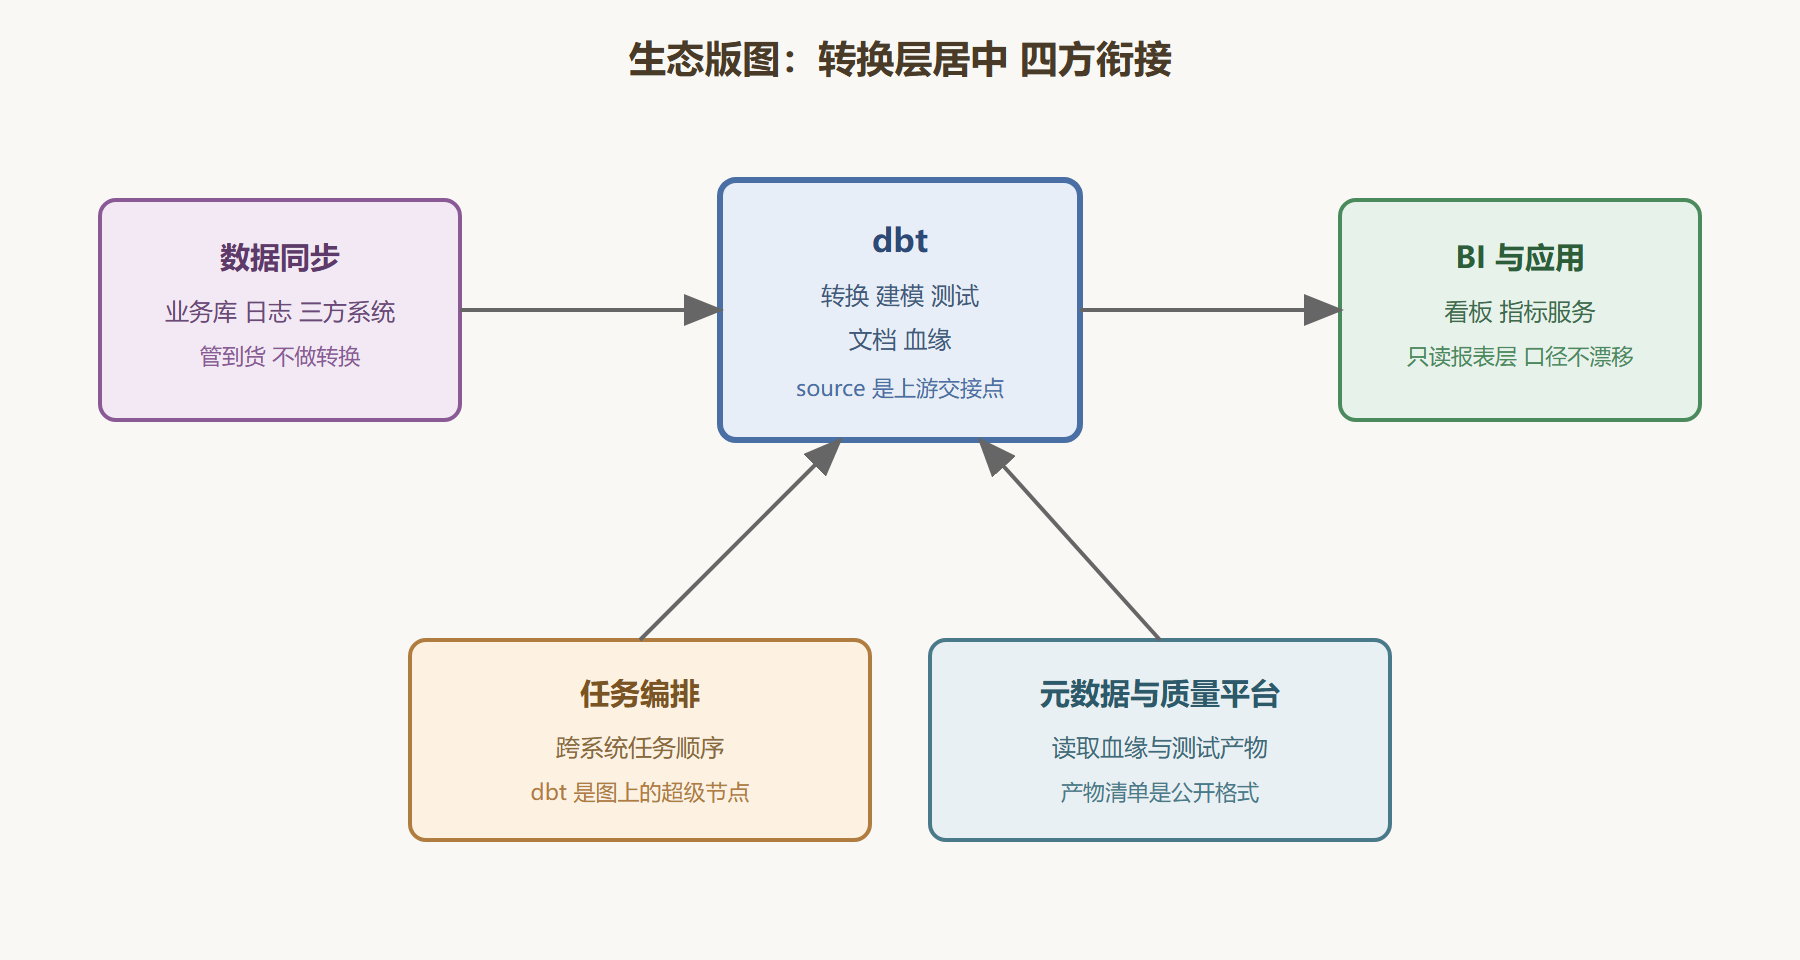
学了六章的 dbt,最后要回答一个定位问题:它在公司整个数据版图里站在哪、和谁打交道。生态版图可以画成一条四环节的链,dbt 居中:
上游环节:数据同步。 Fivetran、Airbyte 这类工具或自建采集管道,负责把业务库、日志、第三方系统的数据搬进仓库。与 dbt 的衔接边界在 1.1 节就划定了:同步管「到货」,dbt 管「到货之后」。技术上的交接点是 source 声明——同步工具写哪些表,dbt 的源声明就登记哪些表,新鲜度监控盯着同一批表。边界清晰的表现是双向不越界:同步工具不做转换(哪怕它提供简易转换功能),dbt 不做搬运。
平行环节:任务编排。 Airflow、Dagster 这类调度平台与 dbt 的关系在 5.3 节讨论过:dbt 管仓库内的依赖排序,编排平台管跨系统的任务顺序(同步完成再触发构建、构建完成再触发下游任务)。两者是协作而非竞争——把 dbt 当作编排图上的一个「超级节点」,节点内部还有自己的依赖图,两层各司其职。
下游环节:BI 与应用。 报表工具、看板、指标服务、特征存储,消费的是 dbt 产出的表。衔接的规范是「只读报表层」——消费端统一对接文档与口径最完备的 marts 模式(6.3 节权限设计的延伸)。BI 工具自带的建模能力(计算字段、语义层)与 dbt 的关系要刻意管理:业务口径尽量在 dbt 里定义,BI 里只做展示层的计算;否则口径又开始向工具侧漂移,前面章节苦心建立的单一口径会被慢慢腐蚀。
横切环节:元数据与质量平台。 第三方的元数据目录、数据质量平台,通过读取 dbt 编译产物里的血缘与测试信息获得「项目的知识」。dbt 对这些工具的态度是开放的:编译后生成的产物清单(含模型、依赖、测试、文档)是公开格式,生态工具围绕它读与写。
图:dbt 在现代数据栈中的生态版图
新工具要不要接:一个判断框架
数据工具生态的更新速度远快于团队消化工具的速度,「要不要引入这个新东西」是每个数据负责人的常设问题。给你一个四问框架:
- 它接在哪一环? 在生态版图上找到它的位置——与现有工具同环(替换)还是空环(新增)。同环引入要论证旧工具的退出成本,空环引入要论证这一环此前是不是真的空着(很多「空环」其实是「这一环的需求还不需要独立工具」)。
- 它让口径更集中还是更分散? 这是数据工具独有的判断维度——任何会把业务逻辑从 dbt 拉走的工具都要谨慎,无论它其他能力多强。
- 它的产物能不能被审计? 工具产出的血缘、指标、质量结果,能不能进你的审计与告警链路(5.3 节的四维监控)?进不了的黑盒工具,短期方便长期失控。
- 一年后的退出成本是多少? 引入时就想退出路径:数据与逻辑能不能迁出来、格式是否开放。退出成本高的工具,引入门槛就要相应抬高——「先进来再说」的债,第六章讲过的每种债都收过利息。
框架之外补一条实践节奏:新工具先在开发或集成环境试运行一个迭代,重点验证四问里的第三、第四问——产物能不能导出、卸载干不干净——再谈进生产。生产环境的工具清单每半年评审一次,与 4.2 节的包盘点合并成同一场会议,两份清单并排看,重叠加减一次做完。工具治理和模型治理一样:清单化的东西才会被盘点,凭印象记着的东西只会单向增殖。
演进方向:三条值得跟踪的线
语义层的标准化。 指标口径「定义一次、处处引用」正在从项目约定走向平台能力:在统一的语义层定义指标,BI 工具与应用直接消费同一份定义,终结「每个工具一套口径」的老问题。对学习者的影响是:指标建模(指标的维度、聚合规则、口径声明)会越来越像一门显式的工程学科——本册 3.4 节那页需求单里的指标定义,未来会有一半写在语义层的声明里。
工程实践的继续下沉。 数据测试从「主键唯一」这类结构校验,向「数据值分布异常」「跨表对账」这类语义校验延伸(3.3 与 5.3 节的对账思想的工具化);CI 从「跑测试」向「影响面自动分析」延伸(6.2 节血缘分析的流水线化)。数据工程的边界仍在向软件工程对齐,本册建立的「模型即代码、验收即断言、变更走评审」的心智模型,在这些演进里全部直接复用。
AI 与数据工程的互相成就。 一方面,语言模型显著降低了「把业务意图翻译成模型与测试」的成本——自然语言描述需求,生成模型初稿与测试清单,人做评审与口径把关,本册教的正是那套「把关所需的知识」;另一方面,数据团队沉淀的文档、血缘与测试,恰恰是让 AI 可靠理解一家公司数据的前提。这两件事互相加速,值得持续观察。
💡 关键直觉:生态判断的底层原则只有一条——你的核心资产是代码仓库里那份「口径加测试加文档」的组合,任何工具都只是它的读者或编辑器。 工具换了一茬又一茬,资产跟着版本库走,这是数据团队真正的不动产。
三个高频生态疑问
先上 dbt 还是先上调度平台
初建数据栈的团队几乎必问。答案取决于现有痛点的位置:如果当前的痛是「脚本散、口径乱、没有测试」,先上 dbt——它的价值在转换层的秩序,调度可以先用仓库自带的定时任务凑合(5.3 节说过这不丢人);如果痛在「多个数据任务排不了顺序、失败没人知道」,而转换层本身还算有序,先上调度平台。两者都痛(多数团队的实情),先 dbt 后平台:转换层的秩序是编排图的基础,节点内部一团乱的编排图只是把混乱可视化而已。
BI 工具选型要不要看它和 dbt 的集成度
值得作为权重之一,不必作为决定项。集成度高的组合(BI 直读 dbt 的产物清单、口径与血缘自动同步)省的是「两边维护」的人力;但 BI 选型的主体权重仍在业务适配性上——分析师用得顺不顺手、可视化能力够不够。务实的目标是保住那条纪律(口径定义在 dbt 侧),至于消费端怎么读这份口径,集成度高就自动同步,集成度低就靠文档站点衔接(6.1 节)——纪律在,工具差距是效率问题不是方向问题。
行业通用模型包值不值得引入
这是 4.2 节讨论过的话题,在生态视角下要补一句:行业通用模型的价值不在省代码,在带来行业共识的口径模板——它假设了「零售的订单长什么样」「SaaS 的留存怎么算」。当你的业务与行业共识高度贴合,它提供的现成蓝图比自建快;当你的业务有明显独特性(多数国内业务形态如此),强行套行业模板的改造成本会吞掉全部收益,不如把它的建模思路当参考读物,模型自己建。判断标准回到那句:它带来的是共识还是负担。
本节要点回顾
- 生态四环居中站位:同步管到货、编排管跨系统顺序、消费端只读报表层、元数据平台读产物,边界清晰才能协作。
- 四问选型框架:接在哪一环、口径更集中还是分散、产物可否审计、退出成本几何。
- 三条演进线:语义层标准化、工程实践下沉、与 AI 互相加速——本册的心智模型全部可直接复用。
- 核心资产论:口径、测试与文档在版本库里的组合才是团队不动产,工具只是编辑器。
全册至此收束。回头看这张地图:第一章的定位、第二章的机制、第三章的实战、第四章的工程化、第五章的交付、第六章的治理——一条从「认识工具」到「被信任的数据资产」的完整路线。工地图纸交到你手上,剩下的工序,在你的仓库里开建。