5.3 设备丢失与交换链报错排错实录
5.3 设备丢失与交换链报错排错实录
本节摘要:设备移除(DEVICE_REMOVED)与交换链报错是 Windows 图形开发最有名的两场戏。本节以一次真实事故的完整破案为主线:原因码怎么读、假设怎么验证、根因怎么收网,最后给出交换链常见报错的排查速查与运行时自愈方案。
报错都写明白了吗?——先破除两个误解
设备移除的对话框只丢下一句"设备已移除",很多开发者的第一反应是显卡坏了,第二反应是重装驱动。两个反应都偏了。误解一:设备移除等于硬件故障。 绝大多数案例里,是驱动遇到了无法恢复的非法命令——你的代码违反了契约,驱动按规则摘除设备自保。硬件真坏是少数。误解二:重装驱动能解决。 驱动重装治的是驱动,治不了非法命令;问题原地复现的概率极高。正确的起点是那行报错的后半截——原因码。设备移除后,接口会记录具体原因,把它读出来,案件就有了第一份证词。
破案实录:周五下午的黑屏
背景。 某渲染工具在长会话后随机黑屏,报 DXGI_ERROR_DEVICE_REMOVED,低配测试机必现、开发机偶发。
第一步:取证。 读设备移除原因码:
// 设备被移除后,问设备要死因 HRESULT reason = device->GetDeviceRemovedReason(); // 调试器里看 reason 的值
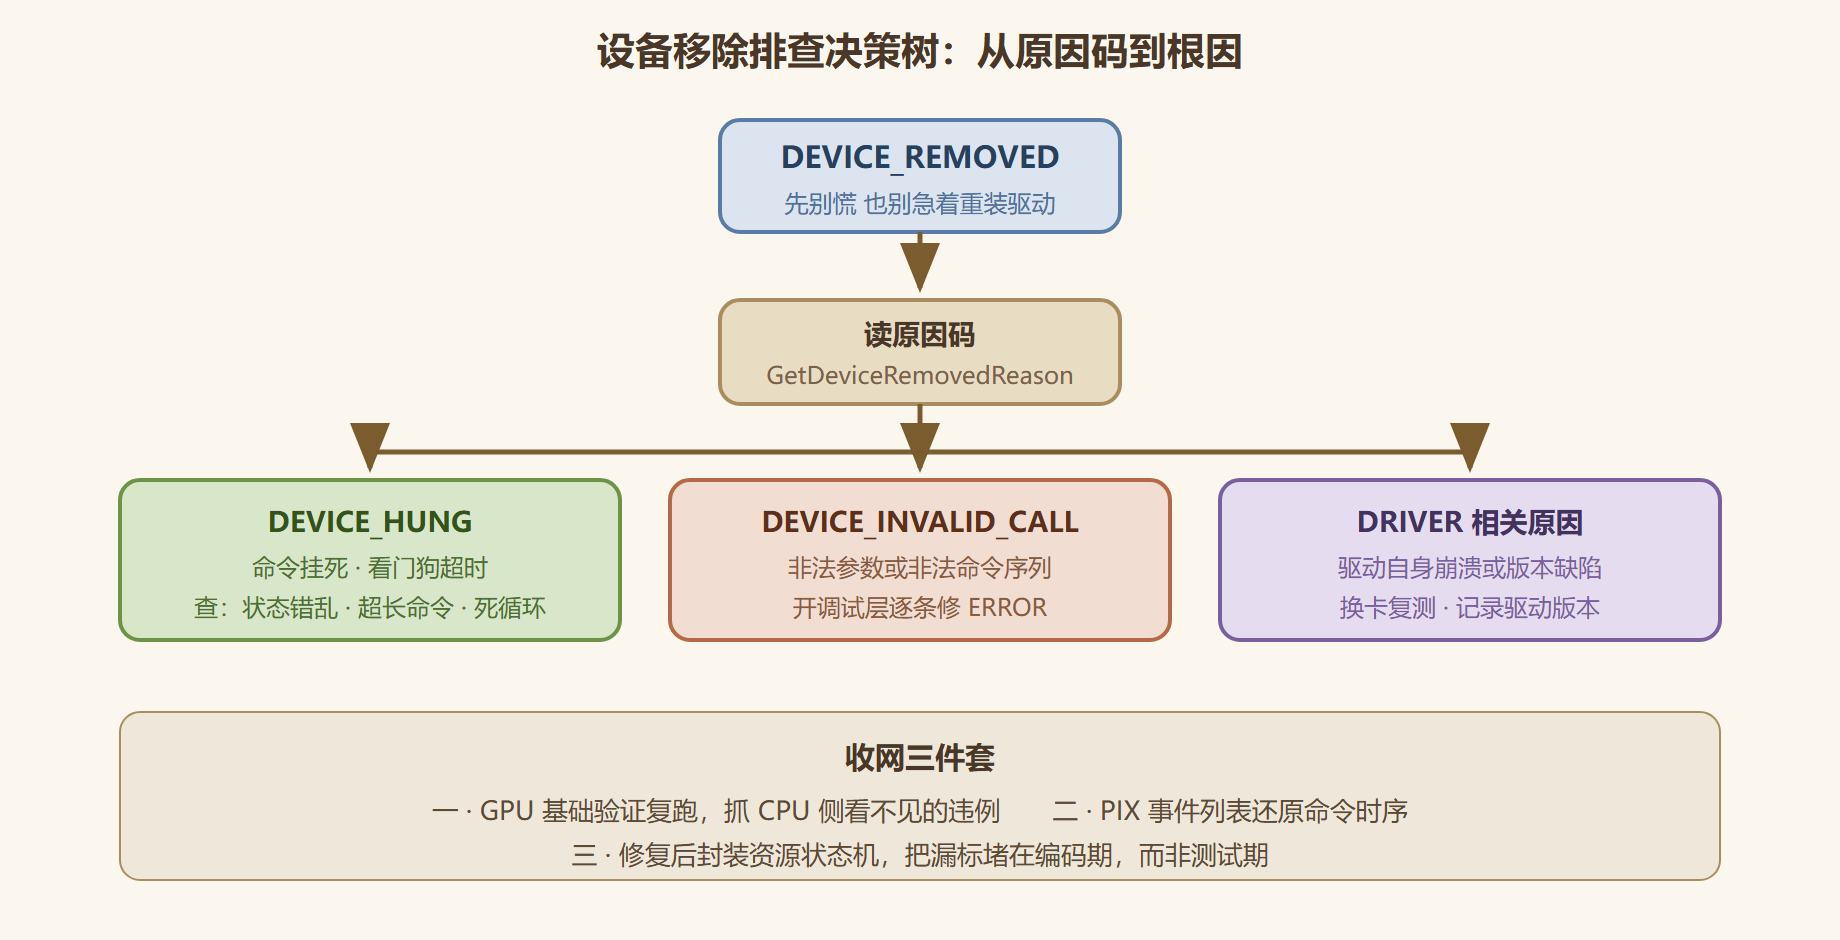
本案取到 DXGI_ERROR_DEVICE_HUNG——GPU 认为某条命令"挂死",看门狗超时强制复位。这不是非法参数(那是 DEVICE_INVALID_CALL 的戏份),而是某条命令让 GPU 停不下来或耗时超过看门狗配额。
第二步:缩小嫌疑范围。 DEVICE_HUNG 的惯犯:无限循环的着色器、超长的单条命令、以及资源状态错乱导致驱动插入无限等待。工具侧先开 GPU 基础验证复跑——立即抓到一条状态转换违例:一块缓冲被同时当作拷贝目标与顶点缓冲使用,缺状态屏障。
第三步:PIX 还原现场。 抓取事故前的帧,事件列表里找到问题命令:上传资源的拷贝调用之后,顶点缓冲直接投入使用,中间没有屏障。对照第三章 3.4 节的资源状态知识:拷贝完成前数据不可用,驱动为保正确性会等待状态就绪——而状态从未声明就绪,等待成了死等,看门狗收割。
第四步:修复与结案。 补上屏障(拷贝目标态 → 顶点缓冲读态),低配机连跑长会话不再复现。收尾动作是把这类错误堵在源头:封装资源状态机,所有状态转换走统一入口,漏标在写代码时就报错。
设备状态迁移图
理解这场戏的全局,看一张状态图:设备在哪些状态之间流转、程序在每个状态该做什么。
解读这张图的关键分岔:独显复位(TDR,超时检测与恢复)是驱动的自愈机制,成功时程序几乎无感;失败才升级为设备移除。程序侧的正确姿势是处理移除而非预防一切——拿到原因码、记录日志、走重建路径(重建设备、重建全部资源、重建描述符与交换链相关状态),这是 Microsoft Store 类应用的标准韧性设计。
交换链报错的排查速查
交换链是另一类高频报错源,常见错误与排查方向浓缩如下:
DXGI_ERROR_DEVICE_REMOVED → 同上,先读原因码,别在交换链上找原因 DXGI_ERROR_INVALID_CALL → 参数非法:缓冲数、格式、翻转模型组合不合法 DXGI_ERROR_NOT_FOUND → 枚举模式不存在:全屏切换用了当前模式没有的模式 DXGI_STATUS_OCCLUDED → 窗口被遮挡,Present 照常返回,可降频渲染 DXGI_ERROR_WAS_STILL_DRAWING→ 提交时 GPU 忙:同步设计问题,回头查栅栏等待
两条高发配置错误值得点名。其一,翻转模型与窗口模式组合:全屏独占与翻转模型、无边框窗口与翻转模型各有约束,乱组合在部分机器上创建即失败——按微软文档的组合表选,别凭感觉。其二,窗口尺寸变化未处理:缩放窗口后后备缓冲尺寸不匹配,呈现异常或报错;正确姿势是收到窗口尺寸消息后 ResizeBuffers 并重建尺寸相关的视图。
图1 设备移除排查决策树
底层机制:TDR——Windows 怎么处置 GPU 卡死
理解设备移除,绕不开 Windows 的看门狗机制 TDR(Timeout Detection and Recovery)。逻辑很简单:GPU 有两秒左右的预算回应系统探测;一旦超时(通常是某个命令死循环、或驱动级死锁),系统判定显卡失去响应,先给驱动一次软重置的机会,重置失败再升级处理——屏幕黑几下、通知栏弹"显示驱动程序已停止响应并且已恢复",程序侧收到的就是设备移除。这个机制存在的理由是系统级的:显卡挂了不能把整个操作系统陪葬,重启驱动比蓝屏温柔得多。
对开发者的含义有两层。其一,两秒预算是硬约束:单个提交的命令批量再大,也别让 GPU 连续算超过这个窗口(超大粒度的计算任务要切片,穿插栅栏探测点);撞线的结果不是"慢",而是"整个上下文作废"。其二,玩家环境是放大器:超频不稳、散热堆积、供电吃紧的机器会把边界情况变成日常——同一份代码你机器上跑一年没事,玩家论坛里"随机黑屏"刷屏。所以处理玩家工单时,先看原因码与驱动版本,再问使用环境,这个顺序能把排查从玄学拉回工程。顺带记住 TDR 有可调参数:注册表可以放宽超时阈值与探测节奏,但那属于诊断期的临时手段——发布产品把希望寄托在玩家改注册表上,无异于把地基建在别人家院子里。
运行时的自愈与预防
自愈:产品级程序应当实现设备重建路径——捕获移除事件、记录原因码、按序释放资源、重建设备与全部资源、恢复渲染。重建成本高(资产全量重载),所以它只该是保底,不该是常态。重建路径的演练也值得写进测试计划:手动触发一次设备移除(调试工具支持模拟),验证重建流程能否把程序带回正常渲染——自愈代码从不被测试,就等于不存在;玩家机器上千奇百怪的触发时机,不会给你现场调试的机会。预防按命中率排序:调试层常开(编码期抓违规)、资源状态封装(堵漏标)、栅栏等待纪律(防超时,第六章展开)、驱动版本基线(避免踩已知缺陷)。这套组合拳打完,设备移除会从"随机恐惧"降级为"可归因的事件"。
本节要点回顾
- 先读原因码再动手:DEVICE_HUNG、INVALID_CALL、驱动原因,三条路三种查法,重装驱动是最后的选项。
- DEVICE_HUNG 的惯犯是状态错乱与超长命令,GPU 基础验证 + PIX 事件列表是标准破案组合。
- 设备移除的正确姿势是处理而非恐惧:原因码入日志,重建路径做保底。
- 交换链报错先查配置组合与窗口尺寸处理,别把锅甩给硬件。
破案能力到手,最后一站看工程视角:项目规模上来后,API、中间层与引擎如何选择与集成。