2.4 内存溢出排错实录
2.4 内存溢出排错实录
本节摘要:一条按用户聚合的查询在十六GB内存的笔记本上撞了墙,报错提示要三十四GB。本节完整记录从复现、定位、缓解到根治的全过程——你将得到一份可复用的溢出排查路线,以及"中间态规模"这个核心概念的实操手感。
案例背景与现场
主线案例升级到全年数据后,业务方追加了一个问题:哪些用户的退款行为最集中。查询思路很直接——按用户分组,统计退款笔数和金额:
SELECT user_id, count(*) AS 退款笔数, round(sum(amount), 2) AS 退款金额 FROM read_csv_auto('trades_full.csv') WHERE status = 'refunded' GROUP BY user_id ORDER BY 退款金额 DESC;
回车之后,等来的不是结果,而是一行报错:内存不足,预计需要约三十四GB,当前上限只有十二GB。机器是十六GB内存的笔记本,库上限默认吃主存的八成。这不是偶发抖动,是确定性的必现问题——正好用来把排错流程走标准。
第一步:复现与读报错
排错的第一个动作是把报错读完整。DuckDB 的内存报错有个好习惯:它会写明"需要多少"和"上限多少"。三十四GB对十二GB,缺口近三倍——这说明靠微调参数解决不了,要么把中间态砍小,要么允许溢出,要么换更大的机器。同时确认两个前提:上限参数确实是默认值(没被历史会话调小),机器上没有别的大内存占用者。这两步排除了"假性溢出"。
第二步:定位中间态在哪膨胀
接下来用执行计划看这条查询到底在哪儿吃内存(执行计划的详细读法在第4.2节,这里只看结论):
EXPLAIN ANALYZE SELECT user_id, count(*), sum(amount) FROM read_csv_auto('trades_full.csv') WHERE status = 'refunded' GROUP BY user_id;
计划输出里,扫描算子旁边标注了它实际只读了两列——列存的功劳;但哈希聚合算子的中间行数显示为百万级。对着第2.2节的规律对号入座:分组数爆炸。全表数百万用户,每个分组要在哈希表里挂一笔,这就是那三十四GB的主体。定位结论:问题不在表大(扫描是流式的),而在"按用户分组"这个中间态本身。
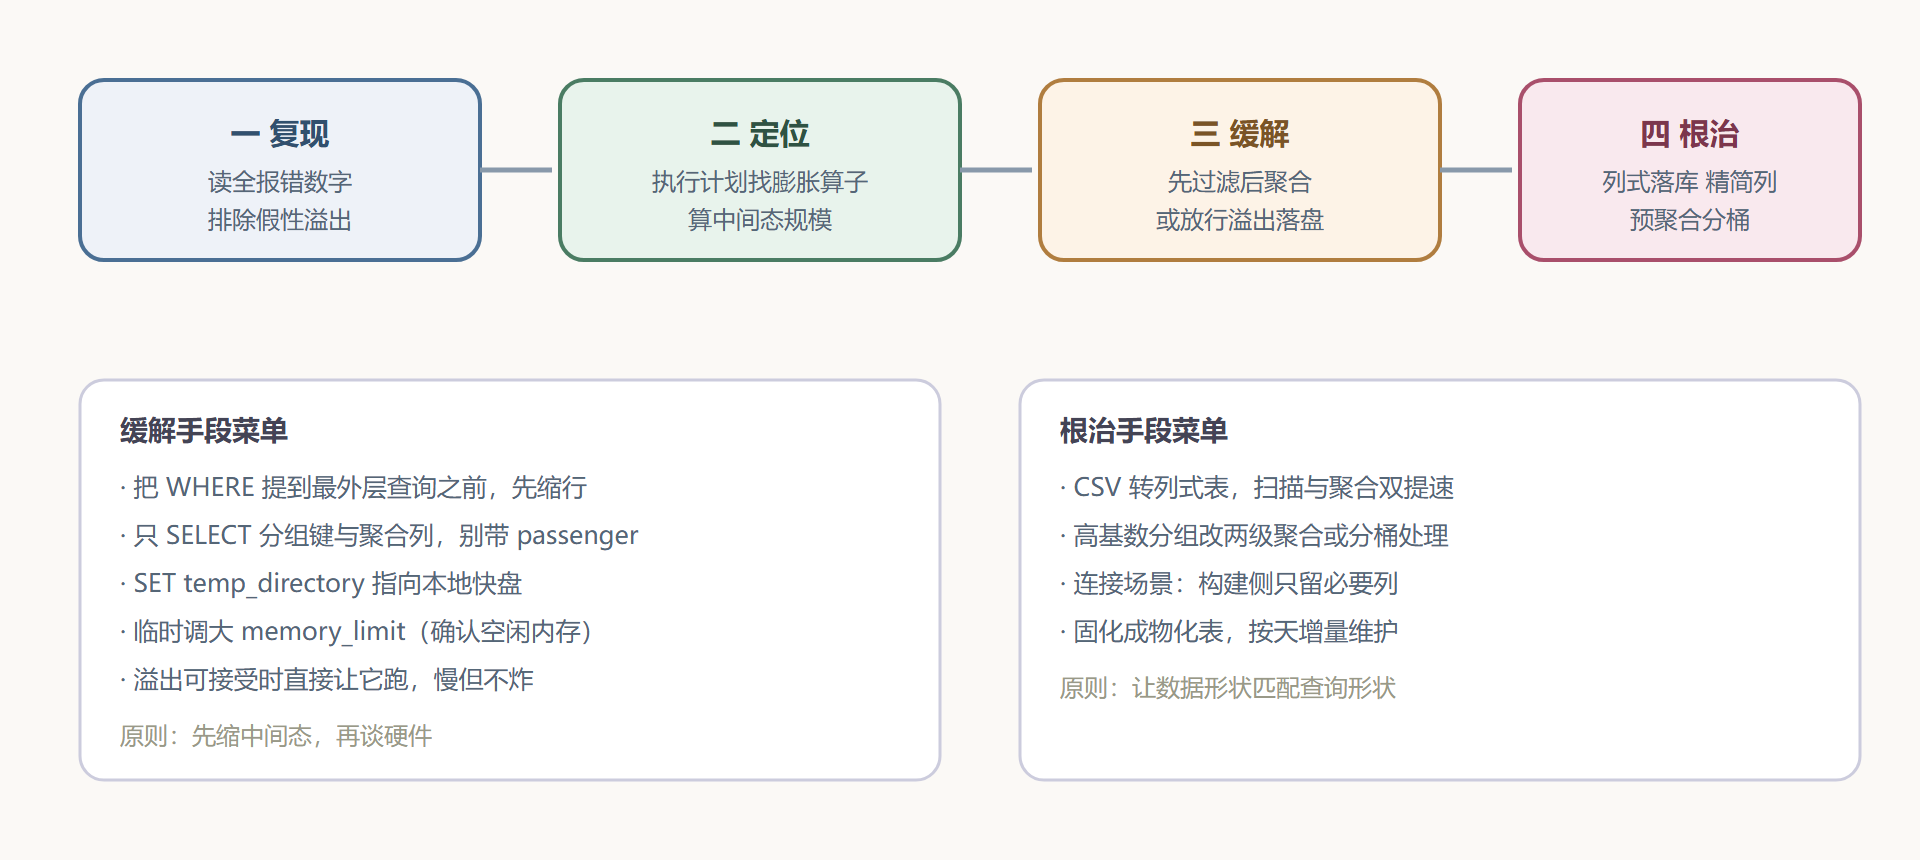
图2-3 溢出排查四步路线
第三步:缓解——把中间态砍小
对照路线图的缓解菜单,第一步动作是把"先聚合"改成"先过滤再聚合"。原查询里 WHERE 条件其实已经过滤了非退款行,但按用户分组的基数不会因此下降——退款照样来自百万用户。真正有效的缓解是放行溢出:指定临时目录到本地 SSD,把上限提到当时的空闲水平,让引擎用磁盘换内存:
SET temp_directory = 'D:/duckdb_tmp'; SET memory_limit = '14GB'; -- 同一查询重跑:成功出结果,耗时约四十秒
查询从报错变成四十秒出结果。这个版本已经"能用",但每次跑都要把百万分组的哈希表在内存和磁盘之间倒腾。缓解方案的意义是先解锁业务——答案当天先交上去。
第四步:根治——让数据形状匹配查询
根治分两刀。第一刀,把 CSV 落成列式表(具体做法是第3章的主题,这里直接用结论):清洗后的数据用 CREATE TABLE AS 收进库文件,扫描、过滤、聚合全走列式路径。第二刀,承认"按用户分组"的高基数事实,把它拆成两级:先按"用户与天"聚合出中间表,再在中间表上按用户汇总——中间态从百万级用户直接降到十万级天组:
-- 一级:按用户与天聚合,中间态大幅缩小 CREATE TABLE refund_daily AS SELECT user_id, CAST(trade_time AS DATE) AS 退款日, count(*) AS 笔数, sum(amount) AS 金额 FROM trades_clean WHERE status = 'refunded' GROUP BY user_id, CAST(trade_time AS DATE); -- 二级:在小的中间表上做用户级汇总 SELECT user_id, sum(笔数) AS 退款笔数, round(sum(金额), 2) AS 退款金额 FROM refund_daily GROUP BY user_id ORDER BY 退款金额 DESC;
两刀之后,同一条业务问题的查询稳定在六秒上下,内存峰值回到两位数MB级别,溢出通道彻底失业。结果与缓解版完全一致——结论没变,过程变好,这正是第1.4节立下的验收标准。值得记下的是两级聚合为什么有效:它利用了"日"这个天然的中等基数维度做缓冲——按"用户与天"分组时,每个分组的中间态只是一天的量,哈希表始终保持娇小;二级聚合面对的输入已经缩到十万行级。找到数据里天然的中等基数维度(天、地区、类目),把它垫在两个高基数维度之间,是内存敏感聚合的万能缓冲垫。
复盘与变式
这次排错的因果链值得背下来:报错数字给出量级 → 执行计划找到膨胀算子 → 中间态规模=分组基数乘行宽 → 要么砍基数(过滤、两级聚合)、要么砍行宽(精简列)、要么让引擎拿磁盘换内存。三个变式留给你:其一,连接爆炸——把构建侧表先精简成两列再连接,往往立竿见影;其二,巨型排序——只排主键加排序键,再回表取整行;其三,多任务抢内存——错峰跑批,或按任务拆成多个小库各自处理。排错这件事,走通一次,后面全是复制粘贴。如果只想带走一张卡片,那就是中间态公式本身:下次任何"内存不足"出现在你面前,先别碰参数,拿计算器算一算分组基数与行宽的乘积——数字会直接告诉你该往哪一档走。
常见的走偏路线
排错路线是标准了,但真实现场里人们常常在半路拐进死胡同,四种走偏提前点名。走偏一,无脑调大上限:缺口三倍时把上限拉到物理内存总额,换来的不是成功而是整个进程被操作系统终结——引擎的保护线(第2.2节)是有道理的,越过它赌的是机器的命。走偏二,迷信加内存条:缓解手段里"扩容"排在最后,因为多数溢出的病根是查询形态(分组基数、构建侧行宽),内存翻倍只能暂时把病压住,查询形态一变就复发。走偏三,把溢出当故障修:如果这条查询一个月才跑一次,四十秒的溢出版本完全可以是终点——排错的投入要与查询的复用频次成正比,"能用"和"最优"之间隔着一个业务判断。走偏四,忽略数据本身的变化:今天不溢出的查询,下月新数据进来了分组基数翻倍照样溢出——所以根治手段里永远有"预聚合、分桶"这类把基数摁住的结构性方案。四条走偏的共同解药是同一条:先算中间态规模,再动任何手。
预防性体检:让溢出别发生
排错能力是底线,预防习惯才是上限。三个低成本的例行动作。新查询先看计划:养成习惯,任何要跑在重要数据上的新查询,先 EXPLAIN 一眼,看聚合与连接算子标出的中间行数量级——趁没跑就知道它会不会撞墙。高基数分组敏感:写 GROUP BY 时先默算分组基数——按"小时"聚合睡得香,按"用户号""设备号"聚合先掂量。定期看峰值水位:一个月看一次重要查询的内存峰值,水位爬到上限七成就该做结构性优化了——这是给未来的自己留的反应时间。
本节要点回顾
- 先读报错再动手:报错里的"需要多少、上限多少"直接给出缺口量级,决定缓解策略。
- 执行计划定位膨胀点:找到那个中间行数惊人的算子,就是溢出的主犯。
- 中间态规模公式:分组基数乘行宽——所有缓解手段都是在砍这两个乘数。
- 缓解与根治分层走:先放行溢出解锁业务,再用列式落库加两级聚合根治。