7.4 主线案例收官复盘
7.4 主线案例收官复盘
本节摘要:导读里那份周五傍晚的交易明细 CSV,在此收官。本节把全书七章在主线案例里的落点逐一回放——每一步遇到什么、用了哪章的什么、拿到什么——最后沉淀出五条可迁移的原则。读这一节的方式应该是合上书自查:每一步先问自己会怎么做,再对照当时的解法。
回到起点:那句"给个结论,今天要"
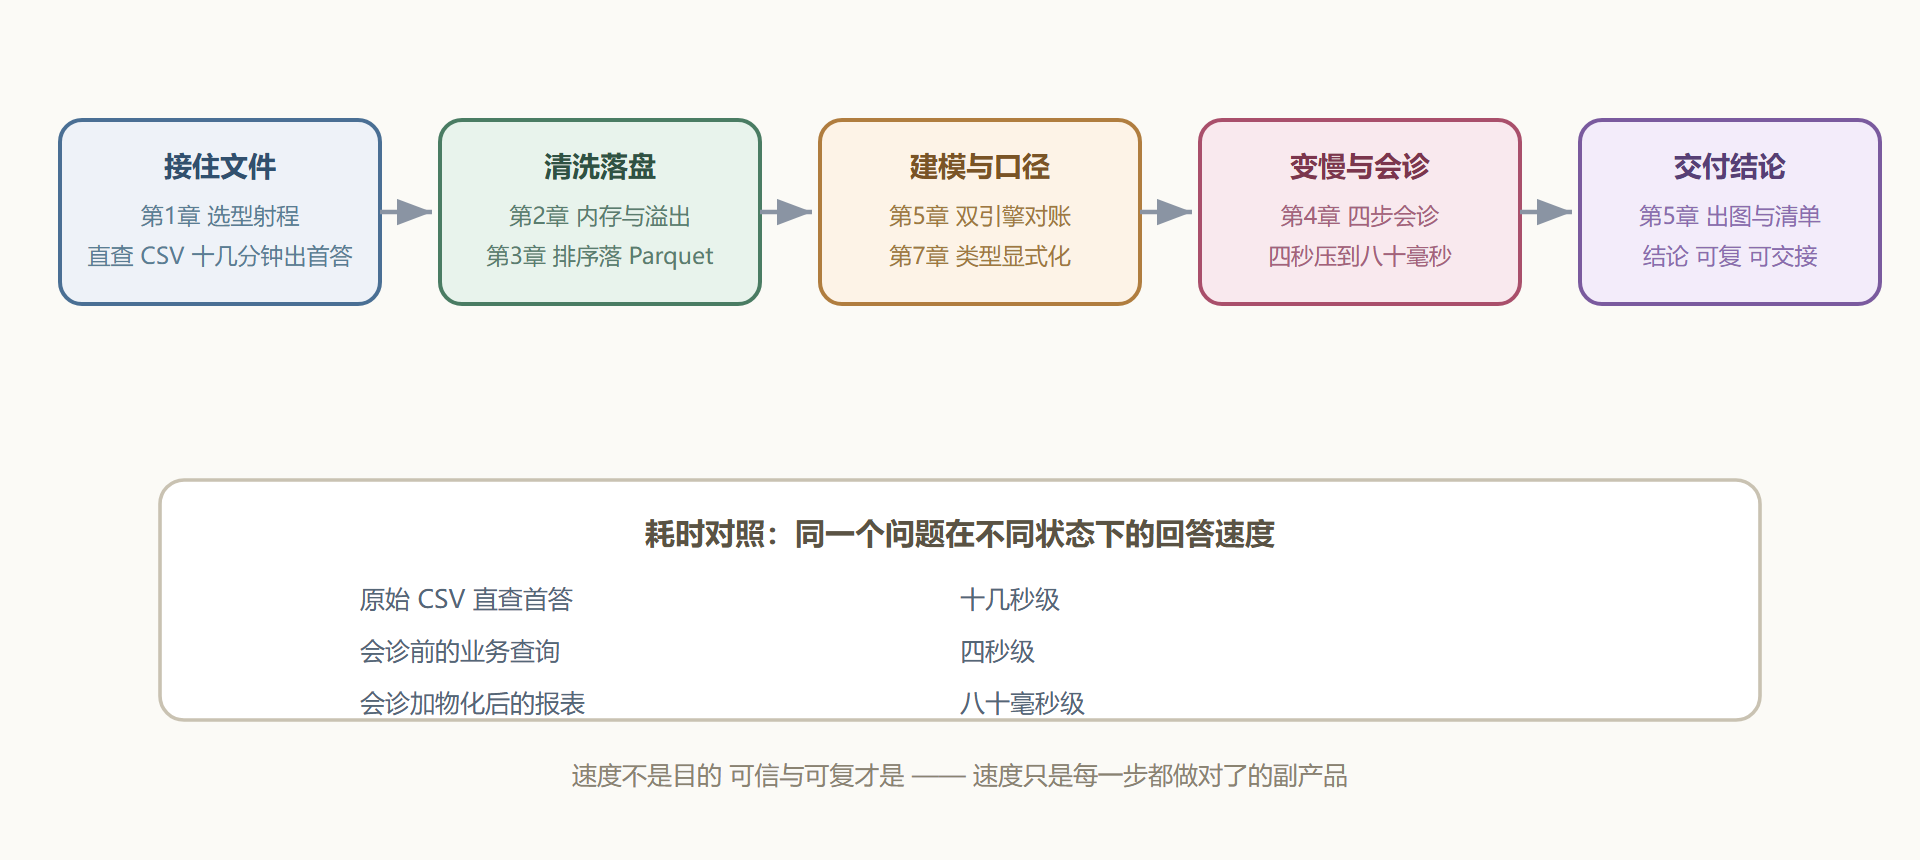
复盘从原始需求开始。业务方要的其实只有一句话的答案:这个月退款集中在什么时候。所有技术动作都由这句话派生。但当时手上的条件是:一份四个多 GB、类型不明的 CSV,一台普通笔记本,以及"今天要"的时限。传统路线在这里分岔——申请数仓账号走审批、把数据传上集群、或者让 Excel 自己卡死。DuckDB 路线的第一步则是两行命令:装库、直查文件。十几分钟后第一版答案已经摆在群里,而这本书剩下的三百多页,讲的都是怎么让这个答案可信、可复、可交接。首答与终局之间的距离,正是"看会了"与"跑通了"之间的距离——导读里埋的这句话,到这里有了具体的注脚。
七章在主线里的落点
第1章给的是选型底气:确认这单活属于"单机交互分析"的射程内——单文件、批处理分析、并发写几乎为零,三条边界检查全部通过。选型没做对,后面的优化都是给错误的架构打补丁。
第2章给的是故障预案:清洗环节一度把内存顶到上限,当时没有崩溃而是溢出落盘、变慢而非失败——事后对照第2.2节才明白这是引擎的设计行为,也因此学会了看溢出信号。第2.4节的排错实录(同款场景的完整会诊)让第二次遇到内存告警时五分钟收工。
第3章给的是文件摆放策略:清洗产物没存 CSV 也没塞库表,而是按时间排序落成 Parquet——列存加压缩,体积缩到原始的六分之一;直查 Parquet 让后续所有工具都能零导入地读到同一份数据。排序这个动作在当时看不出收益,直到第4章剪枝生效才兑现。
第4章是主线的重头:业务追问"大额退款里 VIP 用户走势",查询四秒起。会诊四步(第4.5节)——读计划、过滤前置、按时间重排、物化周度小表——把四秒压到八十毫秒。这一段是全书原理密度最高的落点:计划怎么读、写法怎么改、布局怎么动、物化怎么选,四步各有对应章节的原理垫底。
第5章给的是交付形态:结论最终不是一条 SQL,而是一套交付物(下一节列清单)。Jupyter 实录里那套"摸底、清洗、对账、深挖、出图"的日程,就是主线第二次运行时的实际节奏——同一个案例跑第二遍,用的已经是方法论而不是摸索。
第6章补了一次意外:季度末业务方坚持要读一份旧格式的报表附件,扩展货架装上读取能力十分钟解决;读完顺手把不可信文件的四个约束过了一遍。能力外延与安全边界,主线里各占一次出场。
第7章(本节之前)给的是秩序:调优三层排查、建表四个决定、报错解码表——前面六章的知识在本章被压缩成了随身工具。
图7-4 主线全旅程:从原始文件到可信结论
最终交付物清单
收官交付包括五样,每样都有明确的读者。结论文字:退款集中在每周五下午三点至五点,金额环比上季抬升约一成半——业务方唯一真正要的东西。报表图:周度退款金额图,出处在图,不在群里聊天记录。可复跑的清洗脚本与笔记本:从原始 CSV 到 trades_clean 再到周度表,任何人一条条跑都能得到同样的数字。物化表:refund_weekly_vip 落在库里,下周刷新一次即可。口径备忘:退款怎么认定、大额怎么定义、VIP 怎么圈——下次口径变了,改的是这三行定义而不是三份查询。
这五样东西合起来回答了导读留下的另一个问题:什么叫"说得清这个结论为什么可信"?就是以上五样都在,且每样都能追溯到具体章节的原理。
五条可迁移的原则
复盘最后压成五条,它们不属于 DuckDB,属于一切单机数据分析。其一,先出粗答案再提精度:十几分钟的直查首答让业务方先看到方向,深加工在等待中并行。其二,数据落地即排序:落盘那一刻的物理顺序,决定之后每一次过滤的身价。其三,类型显式化永远划算:五分钟换掉一整类静默错误。其四,反复执行的查询值得物化:延迟换速度,是分析系统里最便宜的交换。其五,每步留痕:数字、计划、改动的先后顺序记下来——复盘之所以可能,全靠过程在场。
课程至此收官。接下来轮到你:找一份自己手头的陌生数据,从"给个结论"开始,把这条路线重新走一遍——走到哪一章卡住,就回哪一章去读。这大概是这本教程最好的打开方式。也欢迎你把走的过程当成一次质检:如果你发现某一步的操作与正文讲的有出入,那不是你的错——工具在演进,这本书教的是"怎么想",具体命令永远以你手上的版本为准;而"怎么想"的部分,才是不会过期的行李。
如果你只有一小时
复盘的完整版值一天,但它有个一小时压缩版——换工作、换数据、赶时限时用。第一个二十分钟:装库、直查原始文件、DESCRIBE 加 SUMMARIZE 摸底,顺手把最关键的过滤条件跑一遍首答。第二个二十分钟:显式类型、按过滤列排序,落成 Parquet——这两个动作从第7.2节的检查单直接抄,不要临场发明。第三个二十分钟:跑出核心聚合,出图,把口径三行写进备忘。一小时结束时你手里的东西,与一周精修版的差距只在"慢查询会诊与物化"这一层——而那一层,等业务真的问深了再补也来得及。快速路径存在本身就是这本书方法论的证明:重要动作就那几个,其余的都是深度选项。
复盘会怎么开
如果这是团队项目而非个人作业,收官还差一个环节:复盘会。三段式,一小时以内。第一段过时间线——从需求进群到交付落地的关键节点与耗时,只摆事实。第二段找分岔——哪些步骤卡过壳、当时的绕路与最终解法差在哪,报错台账(第7.3节)在这里派上用场。第三段定资产——这次产出里哪些该模板化(建表模板、刷新脚本)、哪些该进台账、哪些口径该收口成宏。复盘会最大的纪律是不评判人只评流程:卡壳的环节修的是工具与清单,不是追责谁的曲线救国。一场复盘会开完,下次同类需求的起点就不再是这份 CSV 的起点,而是这次复盘的终点。
时间线上的技术决策回放
复盘还可以更细一层:把几个关键岔路口的决策依据摊开,看当时的取舍是否经得起复盘。岔路一,首答用直查还是先入库:选了直查——因为业务方要的是"集中在什么时候"这个方向性答案,聚合维度单一,直查十几秒可接受;如果首问就是复杂多表关联,先入库再答更稳。岔路二,清洗产物存 Parquet 还是入库表:两者都留了——Parquet 是归档与跨工具的正文,库表是查询优化的载体;只留其一都会在后续某一章返工。岔路三,会诊从逻辑改写开始还是从重排开始:从逻辑开始——改写零成本,重排要重建表;先便宜后昂贵的顺序在 7.1 的三层路线里被制度化了,但在那之前,它在主线里就已经是本能。三个岔路复盘下来没有一单需要翻案——这不是运气,是"每个决定当时都写下了理由"的红利:可复核的决定才可能被复用。
本节要点回顾
- 需求派生一切:所有技术动作都由"给个结论,今天要"这句话定价。
- 七章各有落点:选型、预案、摆放、会诊、交付、外延、秩序,缺一环都会在别的环节还债。
- 交付五件套:结论、图、可复跑脚本、物化表、口径备忘,缺一样可信度就打折。
- 五条原则可迁移:粗答先行、落地即排序、类型显式、反复查询物化、全程留痕。