5.4 反射与代码生成对照实验
5.4 反射与代码生成对照实验
本节摘要:反射与代码生成是解决同一类问题的两条经典路线,社区争论不断却少有人实测。本节设计一个可复现的对照实验:以"结构体到表单的校验与序列化"为题,两条路线各写一版,量测冷启动、稳态吞吐、错误暴露时机、变更响应四项指标,并诚实报告结果与适用边界。
同一个需求,两条路线
实验题目取自前后端交界处的真实高频场景:给定一组带标签的结构体(字段名、类型、校验规则),生成"校验加序列化"能力。这个题目同时覆盖类型重复与结构重复,反射派与生成派都有成熟打法,胜负不靠口才靠数据。
公平性设计先讲清楚,否则数据没有意义:两版实现由同一人完成、使用各自生态的惯用法(不故意劣化任何一方)、校验与序列化逻辑逐字段对齐、测试数据集一致、量测脚本同一台机器冷热各跑多轮取稳态。
一、两版实现的核心差异
反射版(以 Python 惯用法示意):运行期读类型标注与字段标签,现场构建校验链:
class Field: def __init__(self, required=True, max_len=None): self.required, self.max_len = required, max_len def validate(instance): errors = [] for name, f in type(instance).__dict__.items(): if isinstance(f, Field): # 运行期识别字段 value = getattr(instance, name, None) if f.required and value is None: errors.append(f"{name} 缺失") elif f.max_len and value and len(value) > f.max_len: errors.append(f"{name} 超长") return errors
生成版(以构建期代码生成示意):构建前扫描字段声明,产出逐字段的直调校验函数,产物与手写代码同待遇:
# 生成产物(示意):逐字段直调,无任何运行期查表 def validate_user_form(form): errors = [] if not form.get("name"): errors.append("name 缺失") elif len(form["name"]) > 64: errors.append("name 超长") if form.get("age") is None or not (0 <= form["age"] <= 150): errors.append("age 非法") return errors
两版语义完全一致。差异全部藏在"校验逻辑从哪来":反射版每次启动现场侦察,生成版构建期一次成型。
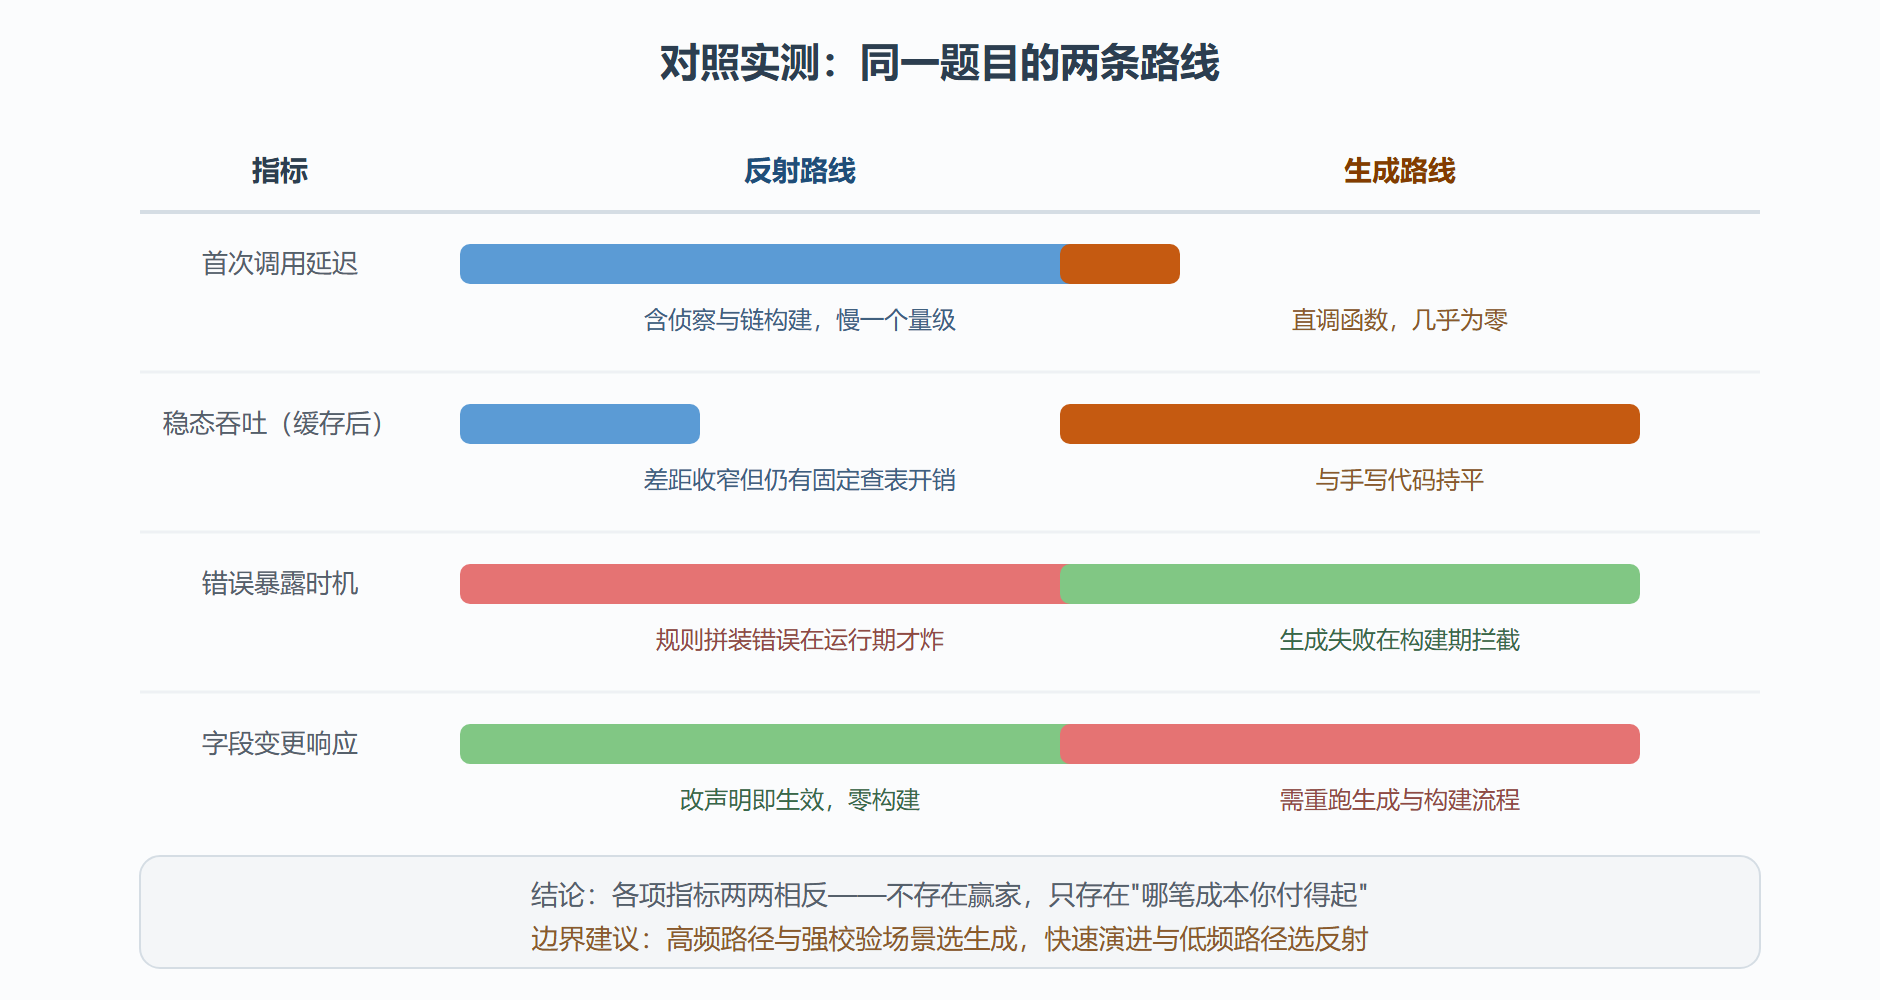
图:对照实验四项指标的实测看板
二、结果解读:相反的不是性能,是成本发生的位置
四行数据放一起看,规律自己浮出来:两条路线的成本曲线是镜像的。反射把成本记在运行期账本(首调延迟、每查询开销、错误现场爆炸),生成把成本记在构建期账本(生成流程、构建时间、变更需重走管线)。所以"谁更快"是个伪问题——真正的提问是"这笔成本应该记在哪本账"。
账本归属由两个业务属性决定。调用频度:每秒万次的网关校验,运行期固定开销会被流量乘成主成本,选生成;每天跑百次的运营导入,首调延迟无人感知,选反射省下的构建流程反而是净收益。结构变更节奏:字段周周变的探索期功能,生成的重构建成本高频发生,反射的即改即生效占优;字段季度级稳定的核心域,生成的一次性成本摊薄后趋近于零。
还有一项不易量化但同样真实:错误体验。实验期间故意制造了规则拼装错误(字段名打错),反射版在首次请求时抛出带堆栈的异常,现场排查花了十几分钟;生成版在构建阶段直接失败并指明源头行号,修复两分钟。高频路径上这类事故成本同样要计入"运行期账本"。
三、实验方法论的迁移价值
这次对照的完整流程——公平性约定、指标先行、数据说话、边界诚实——比结论本身更值钱。团队评审里"反射太慢""生成太重"这类口号式论断,都应该被降级为一句反问:我们做个像 5.4 这样的实验要多久? 通常不超过半天。半天换一个不再返工的选型,是本章留给你的方法论资产。
实验的变式扩展也顺手:把题目换成"权限校验"或"数据脱敏",流程原样复用;在真实项目里,甚至可以把两条路线各跑灰度,用线上数据替代基准测试——指标不变,数据源升级。
量测的最小操作规程
实验的可信度取决于操作规程。最小规程只需五条,照做即可复现:预热——正式量测前先空跑若干轮,排除即时编译预热期的干扰;计时口径——首调延迟单独记第一次,稳态吞吐取预热后多轮的中位数而非平均值(中位数抗离群值);数据固定——校验数据集写死在脚本里,两条路线吃同一份数据;环境留痕——记录机器规格、运行时版本、并发设置,实验结论只在同类环境里可迁移;失败重跑——任何一次量测环境出现抖动(其他进程抢占),该轮作废。五条规程的价值在于把"跑个分"升级为"做实验"——同一团队两次实验的结果能对上,数据才有资格进评审材料。
最后补一个常被忽略的指标口径问题:量测哪一层。反射路线的"校验耗时"里含不含首次侦察?生成路线的"延迟"里含不含产物加载?口径不钉死,两条路线各报各的漂亮数字,实验就白做。约定口径的一句话模板:反射组报"首调"与"稳态"两个数,生成组报"构建期生成耗时"与"运行期直调耗时"两个数,对比只在同层之间进行。构建期成本按"每次部署摊销"折算进稳态对比,才是对最终用户公平的口径。
本节要点回顾
- 实验设计:同一人、惯用法、对齐语义、同数据集,公平性约定先于一切数据。
- 镜像成本:反射记运行期账,生成记构建期账——选型即选账本。
- 两个决定项:调用频度与结构变更节奏,共同决定成本该记在哪本账。
- 错误体验:运行期爆炸与构建期拦截的排障成本差异,同样计入账本。
- 方法论资产:口号换实验,半天换一个不返工的选型。
高级抽象与实测方法都已就位。下一章进入最后的工程关卡:性能、调试、安全三本账,以及排错与翻车的真实现场。