3.2 赌徒破产问题:一道概率名题的完整复盘
3.2 赌徒破产问题:一道概率名题的完整复盘
本节摘要:赌徒破产问题是概率论史上被研究得最久的问题之一:有限资金的赌徒面对资金雄厚(或无限)的对手,反复进行每注输赢一元的公平或不公平博弈,问破产概率、博弈期望时长与策略含义。本节以首步分析法完整推破产概率与期望时长两套公式,用吸收链矩阵法复核,并附模拟验证——全程走一遍"建模、求解、验证、解读"的标准流程。
这道题的源头常被追溯到十七世纪中叶帕斯卡与费马的通信,后来惠更斯、雅各布·伯努利都研究过它。它承载的不只是一道题,而是一个崭新世界观的第一次亮相:一次输赢无法预测,但无穷次输赢的命运可以被精确计算。三百年后它有了工程化身——保险公司对"赔付击穿准备金"的计算、通信系统对"缓存溢出"的评估,数学内核全是赌徒破产。
题面与建模
赌徒初始资金 i 元(正整数),目标是攒到 N 元收手(或说总资产达到 N),每注赌一元:以概率 p 赢一元,以概率 q = 1 − p 输一元。资金降到零即破产离场。求破产概率与游戏期望时长。
状态设计:状态 = 当前资金,取 0, 1, …, N。0 与 N 是吸收态(到达即止),内部状态每步移动一格。这正是 3.1 节强调的"吸收态显式建模"。记 uᵢ 为从资金 i 出发最终在 N 收手的概率(到达目标的概率),破产概率即 1 − uᵢ。
破产概率:首步分析
首步分析是吸收链问题的万能钥匙:从当前状态走一步,按第一步的去向分类,用全期望公式(1.3 节发动机)合并:
u₀ = 0,u_N = 1,且对 1 ≤ i ≤ N−1:uᵢ = p·uᵢ₊₁ + q·uᵢ₋₁
这是一个二阶线性差分方程。特征方程 p·r² − r + q = 0,两根为 r = 1 与 r = q/p。分两种情形:
情形一,p ≠ q:通解 uᵢ = A + B·(q/p)ⁱ。代入边界条件解出:
uᵢ = [1 − (q/p)ⁱ] / [1 − (q/p)ᴺ]
情形二,p = q = 0.5(公平博弈):两根重合,通解为线性函数,uᵢ = i/N。
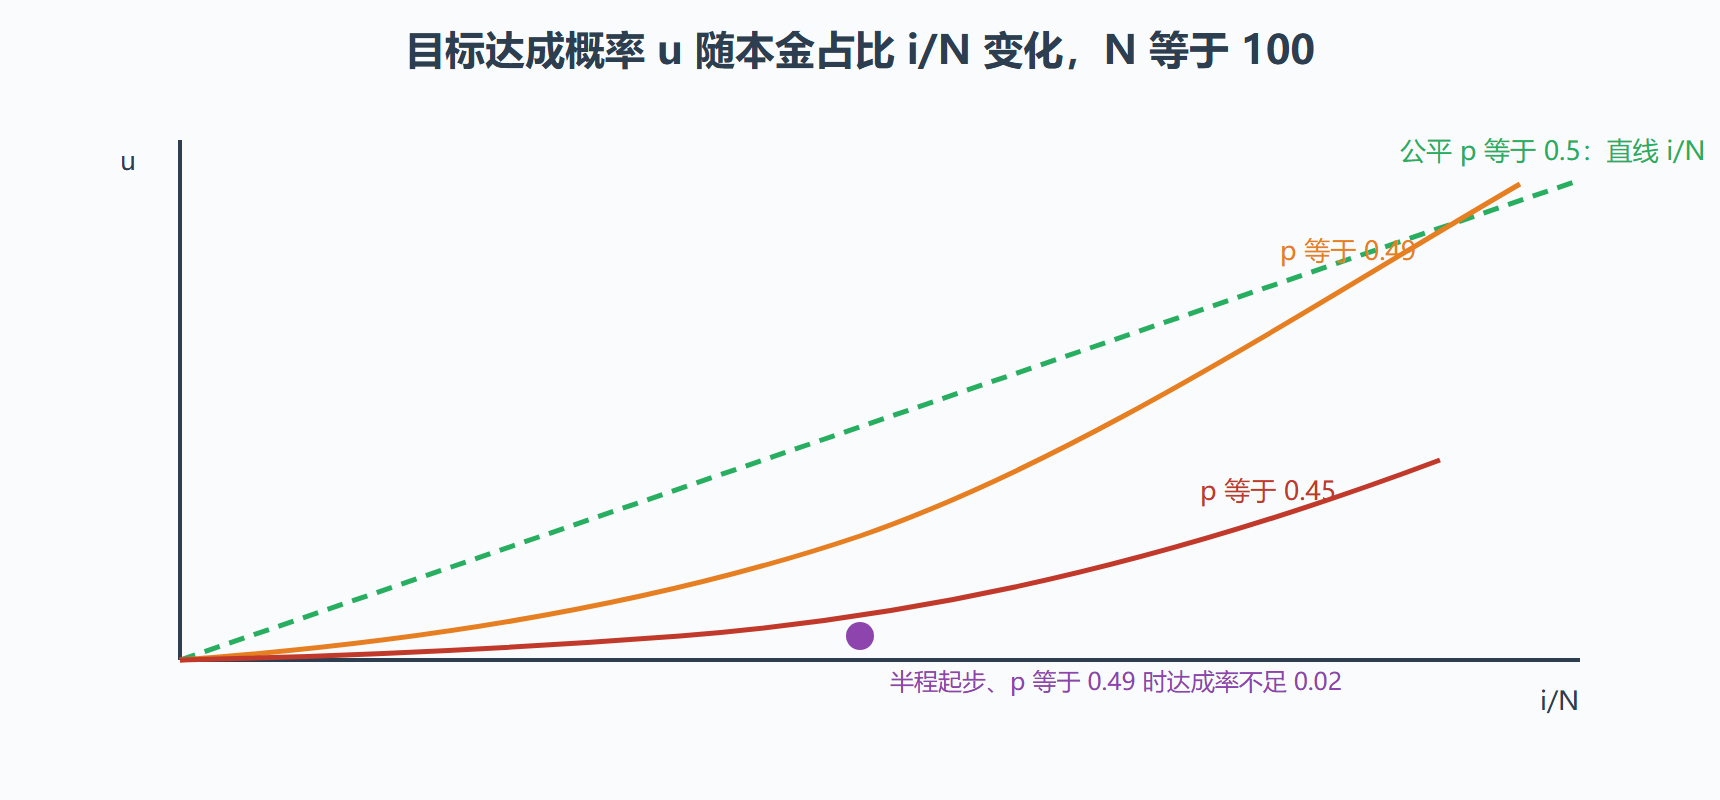
破产概率即 1 − uᵢ。公平博弈时,破产概率恰为对手资金占比 i/N——你的胜率就是你的本金占比,简单到近乎残忍。不公平博弈(p < 0.5,赌场模式)更残酷:代入具体数字感受一下,设 p = 0.49、N = 100、i = 50,则 q/p ≈ 1.041,(q/p)¹⁰⁰ ≈ 56.4,目标达成概率 u₅₀ = (1 − 56.4)/(1 − 56.4²) ≈ 0.0177——每一百次尝试只有不到两次带着翻倍的钱离场。每注只让出一个百分点的小劣势,靠重复博弈被指数级放大,这就是"久赌必输"的数学形态。
图:不同胜率下目标达成概率随初始资金的变化
期望时长:同一把钥匙开第二把锁
记 dᵢ 为从资金 i 出发到游戏结束(破产或达标)的期望步数。首步分析给出:
d₀ = d_N = 0,且 dᵢ = 1 + p·dᵢ₊₁ + q·dᵢ₋₁
差分方程带常数项。特解在 p ≠ q 时为 i/(q − p),在 p = q 时为 −i²(代入验证 p·(i+1)² + q·(i−1)² − i² = 1 成立)。补上齐次部分并代边界:
公平博弈:dᵢ = i(N − i)。从半程出发(i = N/2)期望时长 N²/4——平方级增长。资金各 50 元的两家对赌,平均要玩约 625 注才分出胜负;而同样的局,若 i = 90(只差 10 元),期望仅 90 步。离终点越近,"拖"得越短。
不公平博弈:dᵢ = i/(q − p) − N/[q − p] · [1 − (q/p)ⁱ]/[1 − (q/p)ᴺ]。取 p = 0.49、i = 50、N = 100:第一项 2500,第二项约 2491,期望时长仅约 9 步——不公平的局不仅赢不了,还结束得飞快。优势方在数学上是"速胜收割机"。
这两条结论合起来,构成对一切"翻本策略"的判决:调整注码顺序(先大后小、先小后大)不改变每注的 p,因而不改变差分方程,破产概率纹丝不动。能在公平或不公平博弈里改变命运的只有三件事:提高单注胜率、减少总注数、以及"见好就收"的停止线——最后一条正是第 4 章停时定理要精确化的对象。
矩阵法复核:吸收链的标准流水线
把转移矩阵按"内部状态、吸收态"分块:P = Q 与 R 的组合,其中 Q 是内部状态间的转移块(本例是 N−1 阶三对角矩阵),R 是内部到吸收的两列。吸收链理论给出两个闭式:基本矩阵 N_basic = (I − Q) 的逆,其第 i 行和 = 从 i 出发的期望吸收时长;吸收概率矩阵 = N_basic 乘 R。用数值复核上面的公式(见下方代码),结果与手推完全一致。矩阵法的价值在状态多于三维时显现——差分方程写不出来时,矩阵方程总是能列。
import numpy as np rng = np.random.default_rng(99) p, N, i0 = 0.49, 100, 50 q = 1 - p # —— 手推公式复核 —— r = q / p u_i = (1 - r**i0) / (1 - r**N) # 目标达成概率 d_i = i0/(q-p) - N/(q-p) * (1 - r**i0)/(1 - r**N) # 期望时长 print(f"公式解:达成概率 {u_i:.4f},期望时长 {d_i:.1f} 步") # —— 吸收链矩阵法 —— # 内部状态 1..N-1 之间的转移块 Q(内部到吸收态的部分放在 R 中) Q = np.zeros((N-1, N-1)) for k in range(1, N-1): Q[k-1, k] = p Q[k, k-1] = q Nmat = np.linalg.inv(np.eye(N-1) - Q) t_expect = Nmat.sum(axis=1)[i0-1] # 期望吸收时长 # 吸收概率:R 只有两列(破产、达标) R = np.zeros((N-1, 2)); R[0, 0] = q; R[-1, 1] = p hit = (Nmat @ R)[i0-1] print(f"矩阵法:破产概率 {hit[0]:.4f},期望时长 {t_expect:.1f} 步") # —— 蒙特卡洛验证 —— trials = 50_000 wins, steps = 0, 0 for _ in range(trials): money, cnt = i0, 0 while 0 < money < N: money += 1 if rng.random() < p else -1 cnt += 1 steps += cnt wins += money == N print(f"模拟:达成率 {wins/trials:.4f},平均时长 {steps/trials:.1f} 步") # 典型输出:达成率约 0.0177,平均时长约 9.1 步——三路结果互相咬合
解读与变式:三套独立方法(差分方程、矩阵方程、模拟)给出同一组数字,这是吸收链问题的标准验收姿势。变式一是"对称化训练":把 p 设回 0.5 再跑,达成率等于 i/N,期望时长 2500 步,可检验你对公平情形的记忆。变式二是工程版:把"资金"换成"库存水位",补货率 p 与消耗率 q 不对称时,"库存击穿"概率就是破产概率的翻版——同一套公式换一个车间就能用。
本节要点回顾
- 吸收链建模三件套:状态含吸收态、首步分析列方程、边界条件定解。
- 公平博弈:达成概率 = 本金占比 i/N,期望时长 i(N − i),平方级。
- 不公平博弈:劣势虽小,重复之下达成率指数崩塌、时长迅速缩短——久赌必输的精确形式。
- 矩阵法总兜底:(I − Q) 的逆同时给出期望时长与吸收概率,高维问题唯一出路。
- 调整注码不救破产:不改 p 的策略都不改差分方程。
赌徒的故事结束在破产或达标。下一章视角放宽:不设终点的链走无穷多步之后,比例上稳定在何处——平稳分布与遍历性,以及谷歌如何靠它赚钱。