3.1 马尔可夫性:无记忆的演化法则
3.1 马尔可夫性:无记忆的演化法则
本节摘要:马尔可夫性声明"下一步的分布只依赖当前状态"——这是对条件期望的一次关键瘦身,让演化建模从"记住全部历史"降成本为"记住一个状态"。本节给出两种等价定义、建立转移矩阵与多步计算、并用一个客服系统的小模型演示完整流程,最后讨论"状态怎么选"这个决定建模成败的问题。
行话里管马尔可夫链叫"无记忆的过程",这个说法容易引起误会:链并非丢失了信息,而是把对未来的全部影响压缩进了当前状态这一个数字里。压缩是否成立,取决于状态定义得好不好——这是本节最后要重点讨论的实践问题。先把定义立起来。
定义:条件概率与条件期望两种写法
设 {Xₙ, n = 0, 1, 2, …} 取值于状态空间 S(先设为有限或可数集)。若对一切 n、一切状态序列 i₀ 到 iₙ 与 j,有
P(Xₙ₊₁ = j | Xₙ = iₙ, …, X₀ = i₀) = P(Xₙ₊₁ = j | Xₙ = iₙ)
则称 {Xₙ} 为马尔可夫链。直观读法:给定"现在","未来"与"过去"条件独立——过去能提供的信息已全部折算进现在。
用第 1 章的条件期望语言重写:对任意"未来可测"的函数 f,E[f(Xₙ₊₁) | 全部历史] = E[f(Xₙ₊₁) | Xₙ]。这一版在理论文献里更常见,也是第 4 章鞅定义的原型——鞅就是把这里的条件期望进一步要求等于 f(Xₙ) 本身。
同质性:若转移概率 P(Xₙ₊₁ = j | Xₙ = i) 与 n 无关(记作 pᵢⱼ),链称为时齐的。本教程默认时齐——非时齐链的处理思路与泊松过程的非齐次版本平行,加时间下标即可,不另立章节。
转移矩阵与多步计算
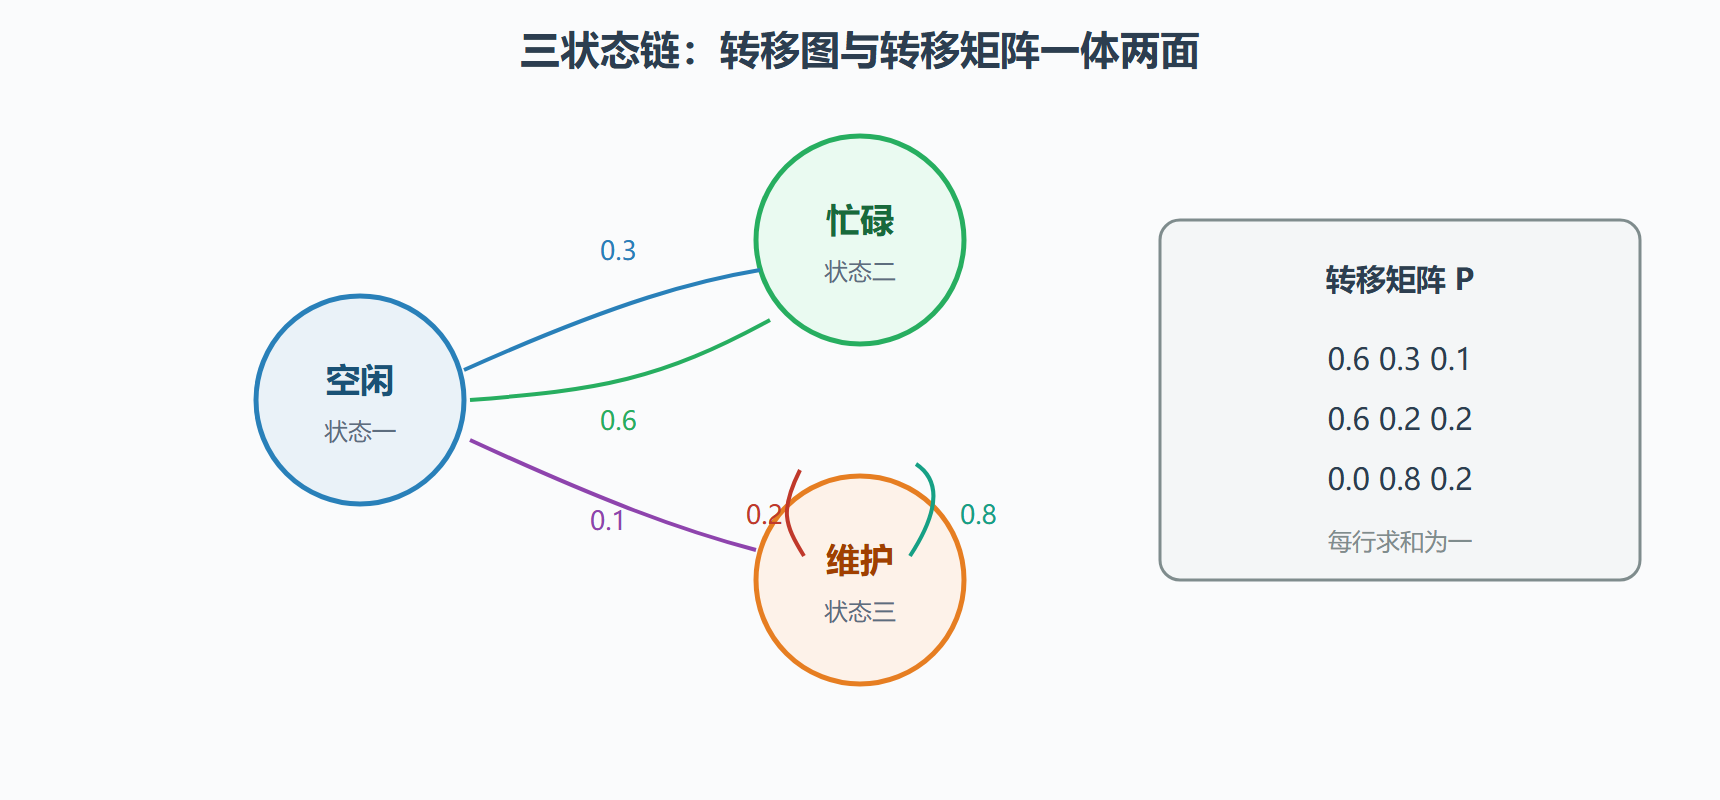
把所有一步概率排成矩阵 P(第 i 行第 j 列为 pᵢⱼ,每行和为一),整个链的短期行为就存进了这一个矩阵。多步的核心结果是 Chapman–Kolmogorov 方程:
P⁽ⁿ⁺ᵐ⁾ᵢⱼ = Σₖ P⁽ⁿ⁾ᵢₖ P⁽ᵐ⁾ₖⱼ
矩阵语言里就是一行字:n 步转移矩阵 = P 的 n 次幂。"走 n 步的概率 = 途中任选中转站 k,先走 n 步到 k 再走 m 步到 j,对 k 求和"——全概率公式在矩阵上的显形。于是"第 n 步在状态 j 的概率"等于初始行向量乘 P 的 n 次幂再取第 j 列。
数值上有个常被忽略的坑:P 的高次幂计算在状态数大时开销陡增,且稀疏结构会被幂运算迅速填满。实践中算"长期占比"应走平稳分布的线性方程组路线(3.3 节),算"有限步到达"才动矩阵幂,或直接在图上做动态规划。
图:状态转移图的矩阵视角
演示:一台设备的双状态模型
背景:一台机床每天收工时记录状态,只有"正常"与"故障"两个状态。历史统计:今天正常则明天仍正常的概率 0.9;今天故障则修好明天正常的概率 0.6。问:从正常出发,三天后仍正常的概率?长期看正常的时间占比?
操作一,多步概率。转移矩阵 P 的第一行 0.9 与 0.1,第二行 0.6 与 0.4。算 P²:左上角元素 0.9×0.9 + 0.1×0.6 = 0.87;P³ 左上角 = 0.87×0.9 + 0.13×0.6 = 0.861。三天后正常的概率 0.861。
操作二,长期占比。解平稳方程 π = πP 联合 π₁ + π₂ = 1:π₁ = 0.9π₁ + 0.6π₂,得 0.1π₁ = 0.6π₂,π₁ : π₂ = 6 : 1,即 π₁ = 6/7 ≈ 0.857。三天后的 0.861 与长期的 0.857 已经非常接近——有限步计算快速逼近极限,这在"最大特征值与次大特征值之比明显小于一"的链上是普遍现象。
解读:0.857 的占比是排班与备件的依据——每七天约一天处于故障或修复中。若引入第三状态"带病运行"(能干活但明天故障率翻倍),矩阵变三阶,占用占比与真实产能都要重算:状态定义一变,答案全变,这正是下一段的主题。
状态怎么选:建模成败的分水岭
马尔可夫性是对"状态"的宣言,建模自由度全在状态设计里。三条经验法则:
法则一,状态要吸收所有相关历史。若设备故障概率取决于"已连续运行天数",双状态链就不够——把"连续运行天数"编进状态(或做分箱),马尔可夫性才能恢复。判断口诀:如果"只用当前状态预测下一步"让你心里发虚,说明状态漏装了信息。
法则二,状态空间规模与数据量匹配。状态每翻一倍,转移矩阵的待估参数约翻四倍。数据不足时宁可粗分箱也别硬造高维状态——填不满的矩阵比分箱误差更伤模型。
法则三,吸收态要显式建模。破产、报废、流失这类"一旦进入不再离开"的状态必须显式设为吸收态(对角线概率为一),3.2 节的赌徒破产整套工具才有用武之地。把它们隐含地摊在其他状态里,是初学者最常见的结构性错误。
⚠️ 一句话排雷:马尔可夫性是假设不是定理。检验手段有限(常见做法是把滞后项加入模型看是否显著),更多时候靠领域知识背书。论文里引用马尔可夫模型时,为这个假设留一段辩护是标准动作。
代码:幂迭代观察收敛
import numpy as np P = np.array([[0.9, 0.1], [0.6, 0.4]]) v = np.array([1.0, 0.0]) # 从"正常"出发 for n in (1, 2, 3, 5, 10, 50): vn = v @ np.linalg.matrix_power(P, n) print(f"n={n:>2}: 正常概率 {vn[0]:.6f}") # 平稳分布:解 (P.T - I) pi = 0 且 sum(pi)=1 A = np.vstack([P.T - np.eye(2), np.ones(2)]) b = np.array([0, 0, 1.0]) pi = np.linalg.lstsq(A, b, rcond=None)[0] print(f"平稳分布 pi = {pi}") # 约 [0.857, 0.143] # 典型输出:n=10 时 0.857146,n=50 与极限在小数点后六位一致
观察输出的节奏:前几步概率快速挪动,随后几乎冻结——幂迭代收敛到平稳向量的速度由 P 的次大特征值控制,这个比值后面还会以"混合时间"的名字再次登场。
案例:一篇论文里的转移矩阵是怎么炼成的
以一篇典型的设备预测性维护研究为例,走一遍从原始日志到转移矩阵的工序,看清每一步做了什么决定:
工序一,定义观测节拍。日志是连续的传感器流,建模取每日快照——节拍的选择决定"一步"的含义,也决定后面的参数量级。快照太密则相邻状态高度相关、矩阵接近单位阵;太疏则转移信息被抹平。常见的做法是把节拍与业务决策的周期对齐(按班次、按天)。
工序二,状态分箱。把连续的健康指标切成三档:健康、亚健康、故障。切点用分位数或领域阈值。切三档得九个待估参数(每行概率和为一约束一个自由度),切五档得二十五个——参数量随档数平方膨胀,数据量不足时先粗后细。
工序三,计数与归一。数出每一对(当前档、下一天档)出现的频次,行内归一得转移概率。零计数的格子记为零还是加平滑(拉普拉斯加一),是这一步的关键决定:样本不足时零概率过于武断,平滑让矩阵更稳但引入偏置。
工序四,合理性体检。行和必为一(数值误差检查);对角线占优是慢演化系统的正常形态;若某个状态的行几乎全押在一个去处,回头查是不是状态定义出了吸收误解。
这套工序的产物就是本章所有计算(矩阵幂、平稳分布、吸收分析)的输入。矩阵的每一个数字都有出处,这是评审马尔可夫模型时最先问的问题,也是复现一篇论文时最先重做的实验。
本节要点回顾
- 马尔可夫性 = 给定现在,未来与过去条件独立;条件期望写法是第 4 章鞅的原型。
- 转移矩阵存一步,矩阵幂算多步;Chapman–Kolmogorov 是全概率公式的矩阵版。
- 长期占比解线性方程组,别硬算高次幂;收敛快慢看次大特征值。
- 状态设计三条法则:吸收全部相关历史、规模与数据匹配、吸收态显式建模。
- 马尔可夫性是假设,需要领域知识辩护,不能当免费午餐。
矩阵与状态的装备已经上身。下一节进入一道具体名题:赌徒破产——有限步分析最漂亮的完整战例。