2.3 到达间隔与条件均匀性:两条性质卡的完整推导
2.3 到达间隔与条件均匀性:两条性质卡的完整推导
本节摘要:到达间隔独立同分布指数,给出泊松过程的"无记忆"性格,也催生了反直觉的检查悖论;条件均匀性则回答"已知到达次数时,到达点如何分布"。本节把两条性质的推导、推论与易错点完整过一遍,并以公交站等车为例完成一次全流程计算。
车站上你刚错过了公交,下一班要等多久?如果你以为"刚走了一班,下一班大概率要等一整个间隔",那就掉进了检查悖论。这个悖论的解释要用到本节的全部装备:间隔分布、无记忆性、以及一个隐蔽的"长度偏倚抽样"。把这道题算透,你对泊松过程的理解就从背定义升级到能上手。
到达间隔:指数分布与无记忆性
设 S 是相邻两次到达的间隔。2.2 节已经证过 S 服从参数 λ 的指数分布:P(S > t) = e^(−λt)。指数分布有一条所有连续分布中独一无二的特征——无记忆性:
P(S > s + t | S > t) = P(S > s)
证明只有一行:P(S > s + t) / P(S > t) = e^(−λ(s+t)) / e^(−λt) = e^(−λs)。左边是"已经等了 t 还没来,再等 s 以上的概率",右边是"从头等 s 以上的概率"。已等的 t 像被系统清零了一样,对未来毫无影响。
无记忆性其实是"恒定机会"的间隔翻译:如果到达机会在每一瞬间都是常数 λ,那么"已经等了多久"当然不该影响下一瞬的机会。反过来,无记忆性也唯一确定指数分布——若你确信"等了半天该来了",那这个到达流从一开始就不是齐次泊松,硬用指数间隔建模就是在给不存在的记忆强行记账。
实际到达流的间隔常被检验:把观测到的间隔画成直方图与指数密度对照,或算间隔的变异系数(标准差除以均值)。指数分布的变异系数恰为一:明显大于一说明间隔忽长忽短(聚集,比如余震型或热点型到达),明显小于一说明间隔被"拍平"了(强管理的时刻表服务)。变异系数一,是与非泊松间隔快速分诊的第一指标。
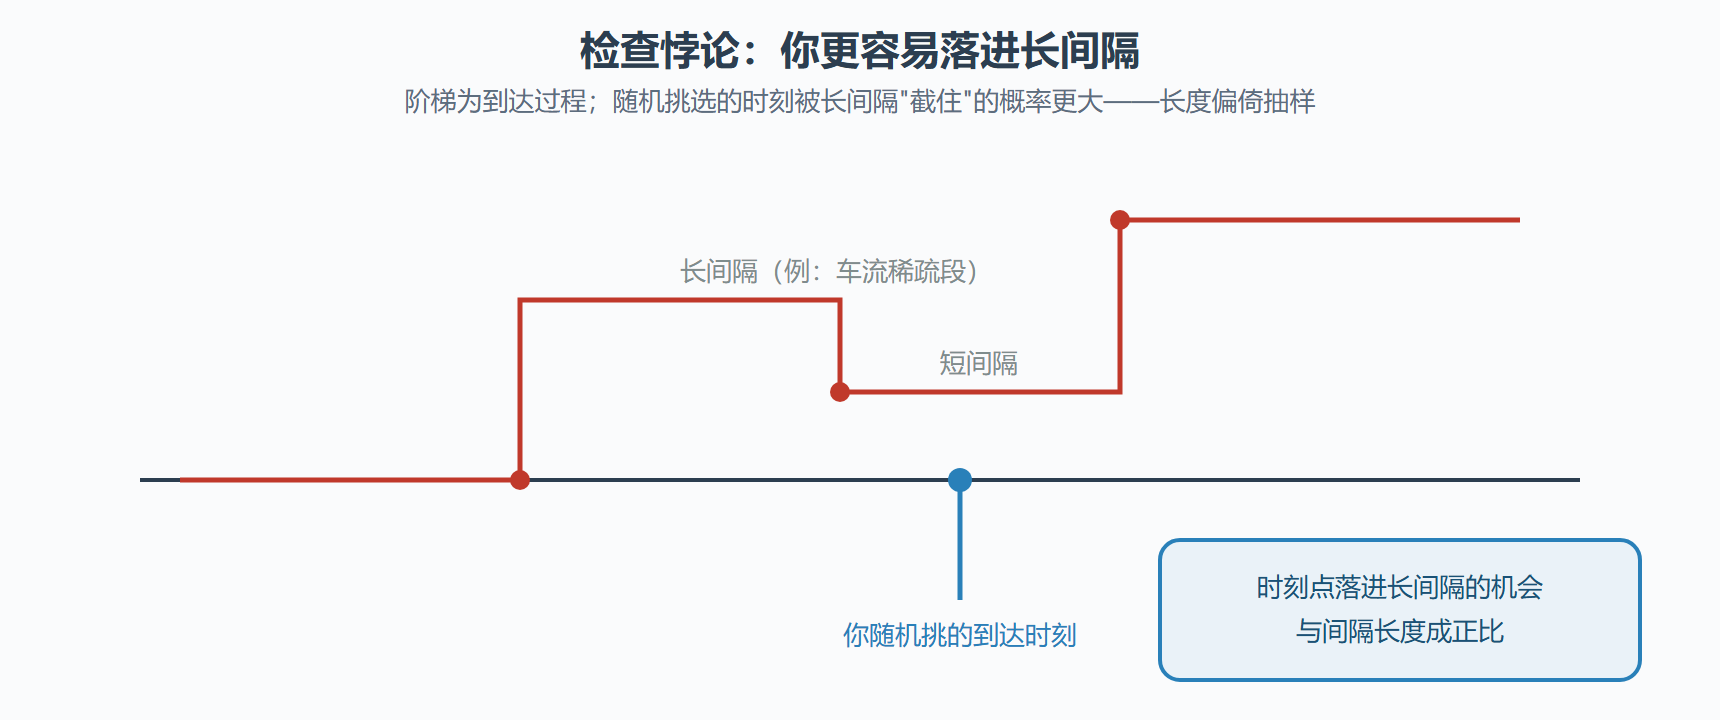
图:检查悖论的几何解释
检查悖论:完整走一遍算术
问题:公交按泊松过程到站(平均间隔 1/λ),你在随机时刻到站,问平均等待多久?
直觉答案"半个平均间隔(1 除以 2λ)"是错的,正确答案是整个平均间隔 1/λ。推导分两步:
第一步,长度偏倚。随机时刻落在某个间隔内的概率与该间隔的长度成正比——长的间隔在时间轴上占的面积大,被挑中的机会自然大。精确地说,选中间隔的长度分布带上了偏倚因子,密度正比于 s·f(s),其中 f 是原始指数密度。归一化后得到"被截间隔"的密度:λ²·s·e^(−λs)(这是参数 2 的伽马分布,也写作两个独立指数之和的分布),期望为 2/λ——你落进的那个间隔,平均长度是普通间隔的两倍。
第二步,对称平分。你到站的时刻在所选间隔内均匀分布(这正是条件均匀性的特例,下一段证明),所以从你到站到下一班车的剩余等待平均是这个长间隔的一半:(2/λ) / 2 = 1/λ。
结论合并成一句话:你等的不是半个普通间隔,而是半个"被挑大的间隔"。实践含义不少:泊松假设下"刚错过一班"并不恶化你的处境(期望等待仍为 1/λ,无记忆性保票);但如果到达流是强规则的(间隔固定),随机到站的期望等待会降到 1 除以 2λ——到达流越随机,随机到站者平均等待越久。调度策略里"以随机性换平滑"的取舍,在这里第一次露出数学獠牙。
条件均匀性:已知次数后的布点
定理:设泊松过程在区间 0 到 t 内恰好到达 n 次,则这 n 个到达时刻的(无序)位置,与把 n 个独立均匀分布点撒在区间上的次序统计量同分布。
证明思路是一次巧妙的条件化。把区间切成 m 等份,由独立平稳增量,各段计数独立同分布于均值为 λt/m 的泊松分布。在 m 趋于无穷时每段至多一件(普通性发力),"第 i 段恰有一件"的概率趋于均匀。因此给定总数 n 后,n 个点在各处的机会均等,次序统计量即均匀布点。
这个定理是"事后分析"的瑞士刀。例:某理赔时段内发生了 3 起事故,问第 2 起落在时段后半段的概率?把 3 个均匀布点的第 2 小个记为 S(2),由次序统计量理论 S(2) 服从贝塔分布 B(2, 2),密度 6x(1−x),积分得 P(S(2) > 0.5) = 0.5。一般地,n 个均匀布点的第 k 小服从 B(k, n+1−k)——需要"第几件何时发生"的场合都能直接查表。
⚠️ 使用条件均匀性时先确认前提:它要求"齐次泊松 + 已知恰好 n 次"。非齐次过程里给定次数后的布点偏向强度高的时段(直观:高强度段更容易贡献到达);事先规定"看第 n 次"与"事后发现恰好 n 次"是两个不同的条件,混用会得出错误的后验。
一次全流程计算:呼叫中心的加班判断
背景:某夜班热线,呼入近似强度 λ = 12 件每小时的泊松过程,夜班 10 小时,处理能力充足,唯一问题是当夜呼入超过 150 件需要申请支援。操作分四步:
建模:总呼入 N(10) 服从泊松分布,均值 λt = 120。
计算:P(N(10) > 150) 用正态近似(泊松在大均值下的标准技巧):均值 120、标准差 √120 ≈ 10.95,超过 150 相当于超过 2.74 个标准差,概率约 0.003。
解读:不需要提前安排支援——每千个夜班只会有约三个触发支援线,临时调度完全来得及。
变式:若管理层把支援线定在 135 件(1.37 个标准差),概率升到约 0.085,每月值班约两三次触发,支援排班的固定化就值得讨论。你看,同一模型换一个阈值,运营结论从"无需准备"翻到"值得排班"——阈值选择的敏感性分析比点估计本身更有决策价值。
from scipy import stats lam, T = 12.0, 10.0 mu = lam * T for threshold in (150, 135): p = stats.poisson.sf(threshold, mu) # P(N > threshold) z = (threshold - mu) / (mu ** 0.5) print(f"阈值 {threshold}: 精确泊松 p = {p:.4f},正态近似 z = {z:.2f}") # 典型输出:阈值 150: p ≈ 0.0027;阈值 135: p ≈ 0.0855
问答:等待问题的三个变体
变体一:已知上一班车刚走三分钟,等待期望变了吗? 泊松假设下不变——无记忆性把"已等三分钟"清零,期望仍是 1/λ。若到达流是固定间隔(每十分钟一班),同样的信息会把期望从五分钟砍到三分钟半(还剩七分钟的平均再对折不到,精确值为剩余七分钟)。同一句"上一班刚走",在两种流里的信息含量完全不同——这也是判断该用哪个模型的生活化试纸。
变体二:随机到站者的"完整间隔"期望为什么是 2/λ? 因为长度偏倚抽样:长间隔在时间轴上占地大,被随机时刻截中的机会与长度成正比。想再直观一点,想象把一天切成许多间隔卡片,抽卡概率按卡片宽度加权——宽卡(车流稀疏段)被抽中的机会成倍放大,于是"抽中的间隔"平均比"随便一个间隔"宽一倍。
变体三:条件均匀性能算"已知恰好一次到达,它在前半段的概率"吗? 能,且答案是漂亮的二分之一——单点均匀布点。推广到 n 次到达、问第 k 次的位置,就是次序统计量加贝塔分布(正文给出)。反过来提醒:若到达强度本身随时间线性上升,前半段的到达概率就不是二分之一而是一半的平方比——条件均匀性只在齐次假设下成立,强度有形状时布点跟着形状走。
本节要点回顾
- 间隔独立同分布指数,无记忆性是"恒定机会"的间隔语言,且唯一刻画指数分布。
- 变异系数为一是泊松间隔的快速体检指标,偏大提示聚集、偏小提示规则化。
- 检查悖论:随机到站者平均等待 1/λ 而非 1 除以 2λ,根源是长度偏倚抽样。
- 条件均匀性:给定到达次数后,到达点如均匀次序统计量,第 k 小服从贝塔分布。
- 前提先核对:齐次、恰 n 次,两个条件缺一,布点结论就不成立。
到达流本身讲完了。下一节给每次到达装上"随机幅度",进入复合泊松与 Lévy 过程的通用框架。