3.4 乱序执行引擎:重命名、调度与提交
3.4 乱序执行引擎拆解:重命名、调度与提交
本节摘要:顺序流水线的每周期指令数天花板很低——一条指令卡住,后面无关的指令全体陪等。乱序执行的思路是把"指令顺序"与"执行顺序"解耦:靠寄存器重命名消除假依赖,靠发射队列按"操作数就绪"调度,靠重排序缓冲把乱序的结果按程序顺序提交、保住精确异常。本节拆解这三大件的协作闭环,并诚实列出乱序要付的账。
顺序核到底卡在哪
把 3.2 的机制用到极致,顺序流水线仍然受制于一个事实:指令按程序顺序排队过独木桥。前面一条装载遇上缓存未命中,后面纯寄存器运算的指令明明数据齐备,也只能顶着等。程序里大量指令彼此无关,却被队列强行捆绑——这就是假串行。顺序核的每周期指令数很难逼近每周期一条的满值,遇到访存密集的代码段还会大幅跳水。
反过来,代码里真正无法并行的只有真数据依赖链:后一条要用前一条的结果。理想执行器的形态呼之欲出——按数据流推进:谁的操作数齐了谁先算,依赖链自动串行,链外指令自由插空。乱序执行引擎就是把这个理想做进硬件的三件套。
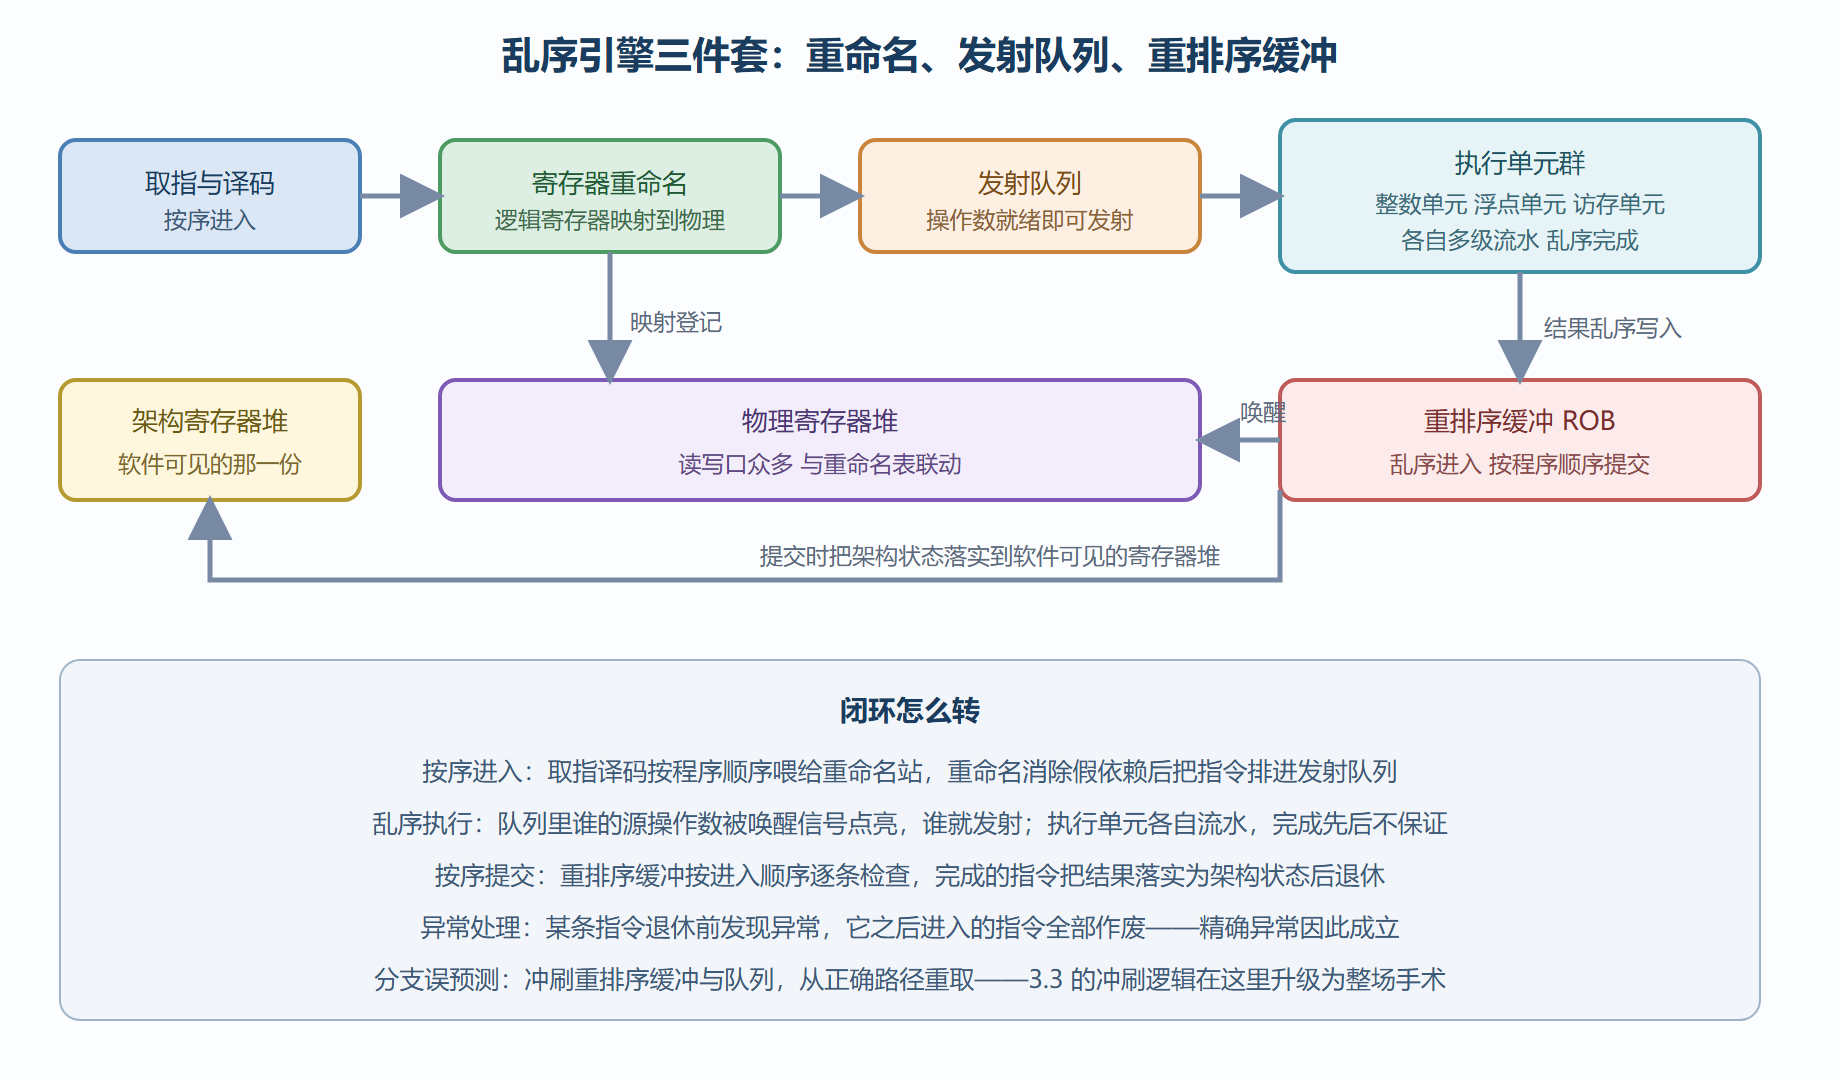
乱序引擎结构图
三件套各自在干什么
重命名:把假依赖拆掉。 程序里三种寄存器依赖,只有"读后写依赖前一条的结果"(真依赖)是语义必需的;"先写后读""写后又写"这两类是复用寄存器名造成的假依赖——纯粹是寄存器编号不够用的历史问题。重命名的做法:准备一个远大于架构寄存器数的物理寄存器池,每条指令写结果时分配一个新的物理寄存器,重命名表记录"逻辑寄存器当前由哪个物理寄存器实现"。假依赖因每次写都换名而烟消云散。唯一不能消除的是真依赖链——它本来就该串行。
发射队列:就绪驱动的调度器。 重命名后的指令带着"源操作数来自哪个物理寄存器、是否已就绪"的标记进入队列。某个执行单元产出结果时,广播唤醒信号,队列里所有等这个源的条目点亮就绪位。一条指令所有源就绪即可发射——与它在程序里的位置无关。队列深度决定了乱序引擎能"看多远":太浅,依赖链稍长就无处插空;太深,唤醒广播的选择网络规模按深度平方增长,时序与功耗双双失控。队列深度是乱序设计里最贵的旋钮。
重排序缓冲:秩序的守门人。 乱序执行出来的结果不能直接当真——异常与分支误预测都要求"仿佛按序执行"的假象。重排序缓冲按进入顺序给每条指令留一个条目,结果先记在条目里;提交阶段按顺序扫描,完成的指令才把结果落实为架构状态并退休。任何一条指令退休前发现异常,它之后的所有条目整体作废,异常处理地址精确指向它——第五章的精确异常就建立在这里。
顺序与乱序的谈判记录
| 维度 | 顺序五级 | 乱序宽发射 |
|---|---|---|
| 每周期指令数潜力 | 接近一条,遇险跳水 | 数条,依赖链外自由插空 |
| 面积 | 小,寄存器堆与旁路简单 | 大,三件套都是大头 |
| 功耗 | 低,控制简单 | 高,唤醒与重命名网络耗电 |
| 验证难度 | 中,场景有限 | 高,乱序交织的组合爆炸 |
| 时序收敛 | 容易,站短 | 难,调度网络常成关键路径 |
| 合适场景 | 控制、实时、成本敏感 | 桌面级负载、不规则访存 |
乱序不是免费午餐:三件套的面积动辄数倍于顺序核的控制逻辑;唤醒网络的时序压力常常成为全核最难收敛的路径(第八章的开源核对比里,代际差距一大半花在这里);验证上,乱序交织的可能性空间让随机验证的种子需求量级上升。所以"要不要上乱序"从来不是技术问题,而是产品定位问题——负载的不规则性越高(数据库、浏览器这类指针追逐型程序),乱序的回报越大;负载规整(流式信号处理),顺序核加宽发射向量单元反而更划算。
💡 关键直觉:乱序引擎买的是"动态发现并行"的能力,卖的是面积、功耗与验证排期。真依赖链是任何引擎都绕不过的墙——先把链找出来(性能剖析),再决定要不要为墙外的空地买一台推土机。
访存侧的两个专属部件
乱序引擎里访存比运算更难管,因为装载可以提前、存储不能提前出错——两条访存指令的地址可能相同,顺序颠倒就改变语义。为此乱序引擎配了两个专属部件。装载—存储队列:存储先进队列等着按序提交;装载出发前查一遍队列里未决存储的地址,地址相同就等或直接转发数据,地址不同放心提前访存。内存消歧预测:地址还没算出来时先猜"这个装载与前面的存储不冲突"提前发出——猜对省时,猜错回滚重来,本质是把 3.3 的赌博哲学搬到了访存上。这两个部件是高性能核的重灾区:历史上多个著名处理器的安全漏洞都出在投机装载的侧信道上,可见其微妙。
验证视角再看一眼。顺序核验证器的头号敌人是冒险组合;乱序核的敌人是交织爆炸——重命名顺序、发射时机、缓存命中与否、中断到达时刻,四个维度的组合让同一个 bug 可能百万条指令才现形一次。工业级乱序核的验证环境因此必须有定向覆盖交叉维度(8.4 的交叉覆盖率)与超长随机回归,这也回应了本节的账单表:乱序的"验证难度高"不是一句形容,是种子数与机器时的真实开销。
常见问题快答
问:乱序核跑单线程慢代码会不会反而不如顺序核? 单看那一段,可能——乱序的额外功耗与面积不因代码简单而打折。但把整个程序算总账,乱序核几乎总能靠"别的段落更快"补回来,除非程序从头到尾都是一条依赖链或全是分支密集的琐碎逻辑。极端情况下(简单控制循环),低功耗顺序核在能效上完胜——这就是异构系统大小核并存的逻辑。
问:重排序缓冲满了会怎样? 新指令进不来,前端停顿——乱序窗口深度限制了"看多远"。窗口内的依赖不满足,窗口外的指令再多也只能等。剖析上表现为退休指令数周期性停涨,硬件计数器能看到这类停顿的占比。
一句话对比收束:顺序核像单车道山路——简单、可预期、堵一段全线慢;乱序核像多车道立交——任何时刻总有车道在走,但修建立交的钱、油、路牌(验证)都是实打实的开销。两代方案没有胜负,只有路况匹配。
本节要点回顾
- 顺序核的天花板:按序排队让无关指令陪等,每周期指令数难以稳定在满值;
- 重命名消假依赖:物理寄存器池加映射表,写即换名,只剩真依赖该串的串;
- 发射队列按就绪调度:唤醒广播点亮源操作数,深度是最贵的旋钮;
- 重排序缓冲保秩序:乱序执行、按序退休,精确异常与误预测恢复都靠它;
- 乱序的账:面积、功耗、验证、时序四涨,回报取决于负载的不规则程度。
执行引擎讲完,访存站背后的世界还没打开——第四章进入缓存、虚拟内存与多核一致性的领地。