4.5 内存模型实验:弱序不是缺陷
4.5 内存模型实验:弱序不是缺陷,是账单
本节摘要:缓存一致性保证副本最终一致,却不保证各核看到内存操作的顺序一致——弱内存模型允许处理器与缓存系统对访存指令重排,单线程无感、多线程协作时却会翻车。本节用一个双线程标志实验亲手复现重排,讲清 RISC-V 弱序模型的重排边界、栅栏与获取释放语义这两层工具,以及为什么"可预期性对性能"的谈判结果写成了一份弱序合约。
实验设计:两个线程、四个变量
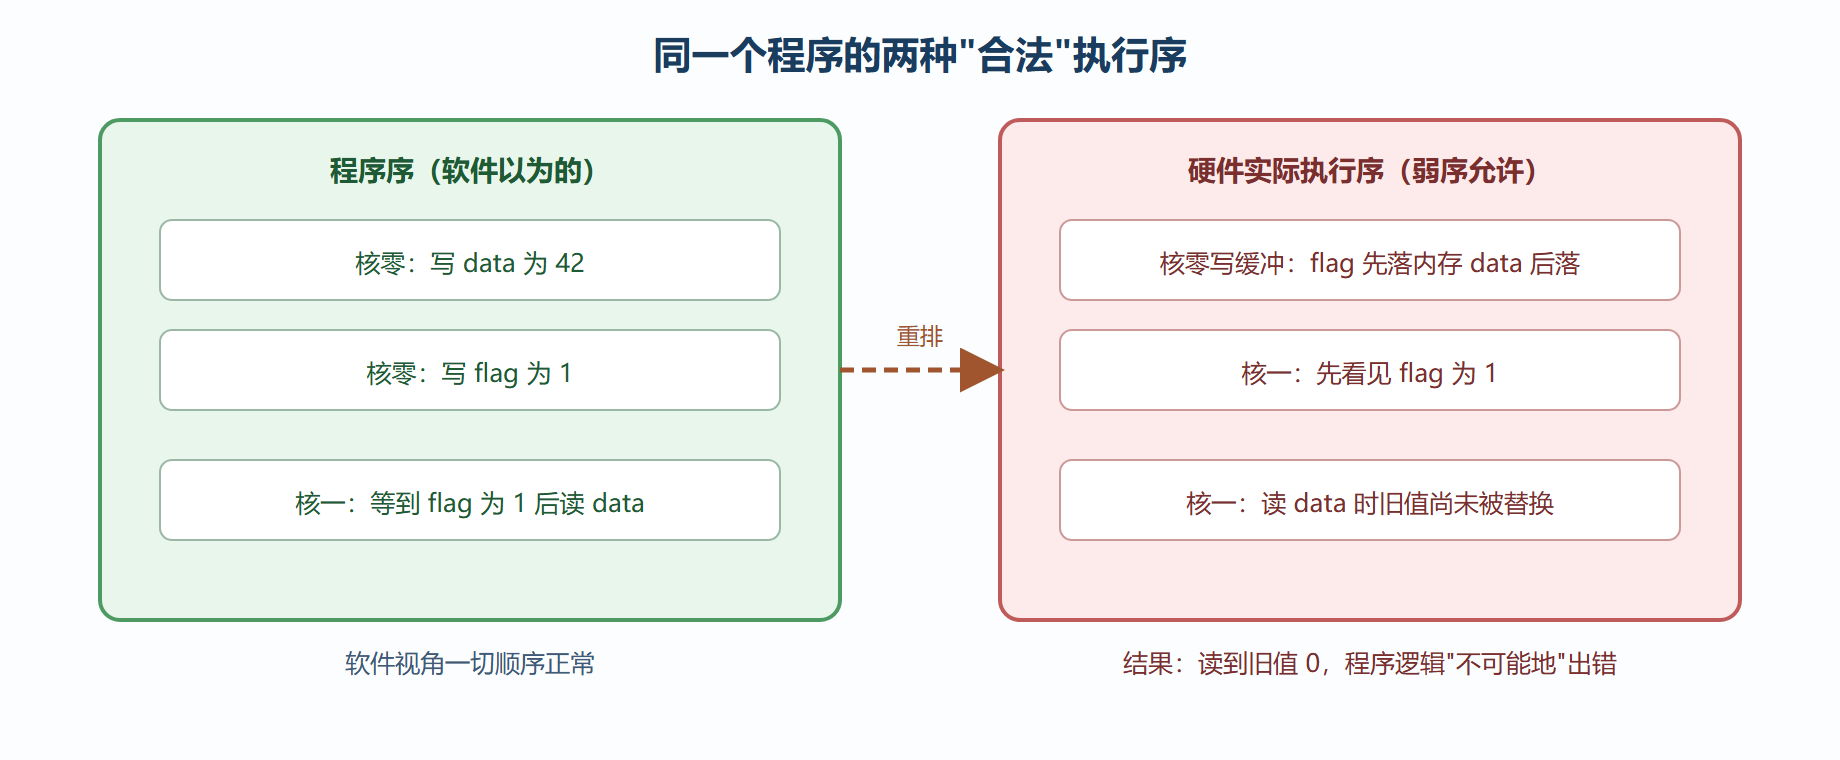
经典的双线程互锁模式(得名于最早研究它的学者):核零先写数据标志甲、再写旗标乙;核一先轮询旗标乙、看到置位后读标志甲。直觉上,核一读到旗标为真时,标志甲必然已是新值——毕竟核零"先写的甲后写的乙"。代码骨架如下:
// 核零 // 核一 data = 42; while (flag == 0) ; // 自旋等待 flag = 1; x = data; // 期待读到 42 // 双方都跑完后,x 竟然可能读到 0 —— 在弱内存模型的机器上 // 条件:编译器不重排(看汇编确认两条存储顺序未换), // 且两个变量位于不同缓存行(排除 4.4 伪共享的干扰)
单线程视角下两边的顺序都天经地义;但两边的顺序互相之间没有任何保证:核零的两次写可能被写缓冲合并重排(先到内存的是旗标),核一的读也可能乱序执行( speculative 读提前探路)。两个"合理"的本地优化叠加,产生了全局上"不可能"的结果。这个实验在弱序模型的真实硬件上可以稳定复现——只是概率性出现,压得越久、核越多、频率越高,越容易撞上。
重排是怎么发生的
为什么故意弱序:一张性能账单
如果硬件承诺"所有核看到的访存顺序完全一致"(顺序一致性),代价是什么?写缓冲不能合并、装载不能提前探路、每个访存都要等前一个全局确认——流水线里最赚钱的两类优化(写合并与投机读)直接停摆。RISC-V 的选择是弱内存模型:默认允许大量重排,把"要不要顺序"的决定权交给软件,用显式栅栏指令按需购买。
这是全章最大的一场谈判:性能对可预期性。弱序合约把绝大多数无共享的普通访存留给硬件全速优化,只对软件显式标注的同步点收费。反过来,顺序一致性模型相当于强制所有人买全程保险——写系统级代码的少数人舒服了,跑普通代码的多数人陪着付保费。弱序是按需付费的方案。
两层工具:栅栏与获取释放
第一层:栅栏指令。在两条访存指令之间立一道墙,墙前的读写先于墙后的对外可见。修正实验代码只需在核零两次写之间、核一的等待与读之间各插一道:
# 核零侧的修正(示意汇编): sw 42, data # 先写数据 fence rw, rw # 读写栅栏:上面的写对外可见先于下面的写 sw 1, flag # 再写旗标 # 核一侧对应:轮询到 flag 后,先 fence 再读 data # 栅栏的两个操作数域分别约束 墙前可观察范围 与 墙后可观察范围
栅栏是重锤:精确但可能挡住本可并行的无关访存。
第二层:获取与释放语义。观察到绝大多数同步场景其实只有"锁保护临界区"一种模式——进临界区前的读不许沉下去、出临界区后的写不许浮上来——于是把栅栏的语义轻量化后绑定到特定访存指令上:带释放语义的存储(写旗标即释放)、带获取语义的装载(读到旗标即获取)。上面的实验用一对获取释放指令就能修正,且比全栅栏给硬件留的优化空间更大。原子指令族自带这些语义选项,锁的实现由此而来。
| 工具 | 语义强度 | 给硬件留的优化空间 | 使用心智 |
|---|---|---|---|
| 全栅栏 | 最强 | 最小 | 粗放但保险 |
| 获取释放对 | 够用即可 | 中等 | 同步原语的标准姿势 |
| 普通访存 | 无顺序承诺 | 最大 | 默认选择 |
⚠️ 常见坑:在弱序机器上"碰巧没出错"的并发代码不等于正确代码。重排是概率性现象,实验室跑一万遍无恙、量产现场翻车的案例比比皆是。并发正确性只能靠模型推理与形式化工具保证,不能靠测试碰运气。
什么时候必须想起顺序:一张触发清单
弱序模型下,绝大多数代码永远不需要考虑栅栏;需要考虑的场景有明确触发特征,列一张清单备查:有生产者消费者关系的跨线程共享数据(写数据再发信号、收信号再读数据——本节实验的正形);锁的实现本身(锁获取释放的语义要用对原子指令,4.5 的第二层工具就是为它设计);设备驱动的内存映射输入输出(写给设备的命令与数据流出的顺序必须严格,通常由驱动框架封装好的屏障保证);与旧代码或跨架构代码共享的数据结构(按最严格的参与者设计同步)。清单之外的普通代码——局部变量、单线程对象、初始化后才共享且只读的数据——放心让硬件全速优化,这正是弱序模型"按需付费"的善意。
常见问题快答
问:单线程程序需要担心内存模型吗? 基本不用。处理器保证单线程看自己的访存服从依赖顺序(自己写的自己能按序读到)。例外是与设备的交互——设备不是"本线程",映射内存的读写顺序要按驱动规范加屏障。
问:栅栏加多了会怎样? 性能退化但不出错——这是栅栏与并发 bug 最大的区别:宁过度勿缺失。实践中常见的稳健策略是先用高层同步原语(锁、消息队列)规避裸栅栏,只有剖析证明原语开销成为瓶颈时,才下沉到获取释放级别的精细控制。
给实验者的最后一条建议:本节的实验值得亲手跑一遍——双线程加长循环加多次采样,在真实板子上撞出一次重排,比读十遍文字记得牢。实验代码很短,变式也多:把栅栏换成获取释放对再跑、把两个变量挤进同一缓存行观察伪共享叠加、在仿真器与真机各跑一次对比出现概率。做完这一组,4.4 与 4.5 的边界就再也忘不掉了。
本节要点回顾
- 一致性不管顺序:副本最终一致与各核看到的操作顺序是两回事;
- 双线程标志实验:写缓冲合并与投机读叠加,能复现"不可能"的旧值读取;
- 弱序是一张账单:默认放行重排换性能,顺序由软件按需购买;
- 两层工具:全栅栏保险粗放,获取释放轻量精细,普通访存是默认;
- 测试撞不出重排:并发正确性靠模型推理,不靠跑得久。
内存世界的地图至此完整。下一章回到处理器内部,看操作系统与硬件的交界——特权架构。