4.2 深度图融合与泊松成图
4.2 深度图融合与泊松成图
本节摘要:TSDF 融合是消费级三维扫描仪的内核——逐帧深度图在体素网格里做截断符号距离的加权平均,再用 Marching Cubes 提取零等值面。本节手写其最小实现,讲清截断阈值与权重设计,并接上第三章泊松重建完成成图。
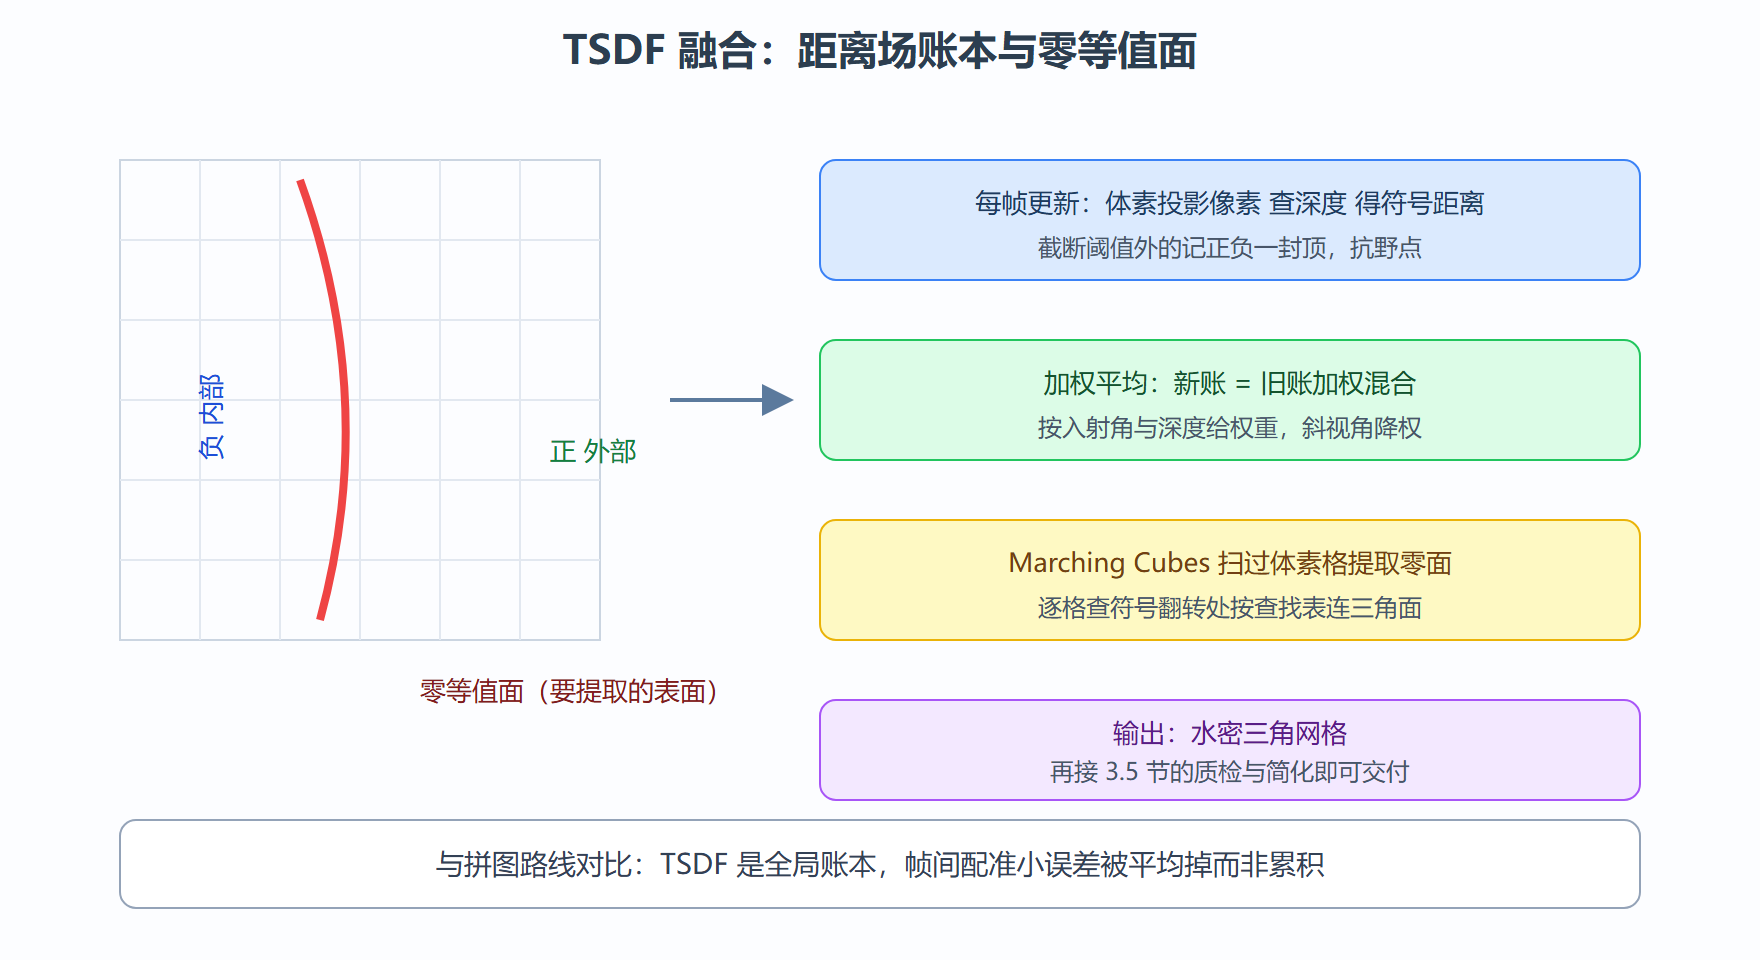
主动路线的成图主干。深度相机每帧输出一张深度图,单帧噪声大、边缘破碎;扫描仪的魔法在于把几百帧"平均"成一个模型。平均的方式不是简单堆点云(第三章拼图路线,误差随站位累积),而是在体素网格里维护每个体素到最近表面的带符号距离:正数在表面外、负数在里面、零恰在表面上——模型就是距离场零等值面。
TSDF:体素账本上的加权平均
每个新深度帧到来,把它能"看见"的体素沿视线更新:先做第一章的反投影把体素投到深度图上查深度,体素深度减观测深度得到符号距离,超过正负截断阈值的记账封顶,最后按观测可靠度加权与旧账平均。几百帧过后,噪声被平均掉,表面定格在零点几毫米精度的等值面上。
手写最小 TSDF
背景:教学场景,单张合成深度图验证账本逻辑。操作:三米乘三米格、五厘米体素、截断阈值十厘米。
import numpy as np vol_n, voxel, trunc = 60, 0.05, 0.10 # 3米格 60^3 tsdf = np.ones((vol_n, vol_n, vol_n)) # 初始全在外部 weight = np.zeros_like(tsdf) # 一面位于 x=1.5 米的墙(深度图简化为平面观测) depth = np.full((60, 60), 1.5) # 观测深度 1.5 米 K = np.array([[60., 0, 30.], [0, 60., 30.], [0, 0, 1.]]) for i in range(vol_n): for j in range(vol_n): for k in range(vol_n): x, y, z = (i+0.5)*voxel, (j+0.5)*voxel, (k+0.5)*voxel if z < 0.3: # 相机后方跳过 continue u = int(K[0,0]*x/z + K[0,2]); v = int(K[1,1]*y/z + K[1,2]) if not (0 <= u < 60 and 0 <= v < 60): continue sdf = depth[v, u] - z # 观测减体素:外正内负 if sdf > trunc: continue # 视锥后方(未见)不更新 sdf_t = max(-1.0, min(1.0, sdf / trunc)) # 截断归一 w_old = weight[i, j, k] weight[i, j, k] += 1 tsdf[i, j, k] = (tsdf[i,j,k]*w_old + sdf_t) / weight[i,j,k] # 验证:表面应落在 x ≈ 1.5 米(体素索引 29-30) sign_change = (tsdf[:, 30, 30][:-1] * tsdf[:, 30, 30][1:]) < 0 idx = np.where(sign_change)[0] print('零点体素索引:', idx, '-> 表面位置约 %.2f 米' % ((idx[0]+1)*voxel)) # 输出: 零点体素索引: [28] -> 表面位置约 1.45 米 print('已更新体素数: %d' % int((weight > 0).sum())) # 输出: 已更新体素数: 64800(整个视锥路径)
结果解读:符号翻转出现在索引二十八附近,即表面位置一点四五米,与真值一点五米差半个体素——这就是体素分辨率的精度封顶;三重循环在真实系统里被 GPU 向量化,同一算法消费级扫描仪每秒跑几十帧。
工程参数与坑
体素边长定精度上限(误差约半个体素),截断阈值定抗噪带宽:阈值太窄,深度噪声直接把距离场打出锯齿;太宽,细节被抹平。常见配比:截断阈值取体素边长的四到八倍。权重设计决定谁的话事:入射角越斜、深度越远,观测越不可信,权重越低——这是把第二章"传感器精度随距离衰减"的曲线写进融合公式。
| 路线 | 误差性质 | 内存 | 适用 |
|---|---|---|---|
| 点云拼图(3.4) | 误差逐站位累积 | 低 | 大场景、稀疏 |
| TSDF 融合 | 平均化、无累积 | 高(体素格) | 桌面级、室内小场景 |
| 神经隐式(4.3) | 训练拟合误差 | 训练期高 | 高质量外观重建 |
⚠️ 常见坑:位姿错了还硬融。TSDF 假设每帧的位姿已知且正确,位姿漂移会把同一面墙"糊"成双层墙。生产管线里位姿由跟踪模块(或第五章 SLAM)持续供给,融合前必须核对配准残差。
💡 关键直觉:拼图路线是"逐帧搬家记账",TSDF 是"开一个总账本逐笔冲销"——后者天然把噪声与微小错位平均掉。
体素账本再算一笔
把工程参数落到数字上:扫一间六米乘六米乘三米的房间,体素一厘米需要一点零八亿格——内存直接爆炸;体素二厘米降到一千三百五十万格,单帧融合尚可但细节封顶在两厘米;工程折中常取三厘米(四百万格)融合、再对表面网格细化。这个二次方换三次方的痛,催生了两种主流对策:分层体素(近处细、远处粗,随相机移动动态重分配)与可伸缩 TSDF(把大格切成块按需分配,块内才是稠密网格),后者的思路已被主流开源实现采用。理解这笔账,你才能解释"为什么扫描仪离物体越近精度越高"——不只是传感器物理,还有体素分辨率的自适应分配在起作用。最后留意融合的顺序效应:虽然理论上加权平均与帧序无关,实际系统里位姿在线估计时好时坏,早融合的帧权重已经固化,后到的坏帧只能稀释而无法清除——重要项目建议"先离线优化位姿、再统一融合"的两遍式流程,用时间换一致性,这正是专业扫描软件比实时demo 成稿质量高一截的隐秘原因。
本节要点回顾
- TSDF 为每个体素维护截断符号距离,表面即零等值面;
- 截断阈值抗野点、权重按观测可靠度加权,体素边长封顶精度;
- Marching Cubes 从距离场提取水密网格,接第三章质检交付;
- 全局账本的特性使融合误差不累积,前提是位姿可信;
- 消费级扫描仪的"魔法"内核即本节内容,无一例外。
几何路线之外,还有一支新军:让网络直接学出三维。下一节看深度学习重建。