第六章 RAG 与工具生态:给智能体接上外部世界
第六章 · RAG 与工具生态:给智能体接上外部世界
本章要回答的三个问题:模型的知识停在训练截止日,怎么让它回答"现在"的问题?检索出来的内容质量参差,怎么用参数把质量管起来?每个项目都在自研同样的查询、邮件、日历工具,这套轮子能不能不重复造?
为什么会有这一章
第 1 章列出的第四个缺口——"不知道自己不知道"——至今没有正式处理。它有两种表现形式:知识过时(昨天发的政策今天来问)与知识私有(公司制度、产品手册从没进过任何训练集)。两者的共同解法是检索增强生成(RAG,Retrieval-Augmented Generation):回答之前先去权威来源取证,把证据连同问题一起交给模型。第 3 章的向量检索已经打好了地基——本章把它从"记用户的事"扩展到"记世界的知识",并补上引用与验真这两个生产级要求。
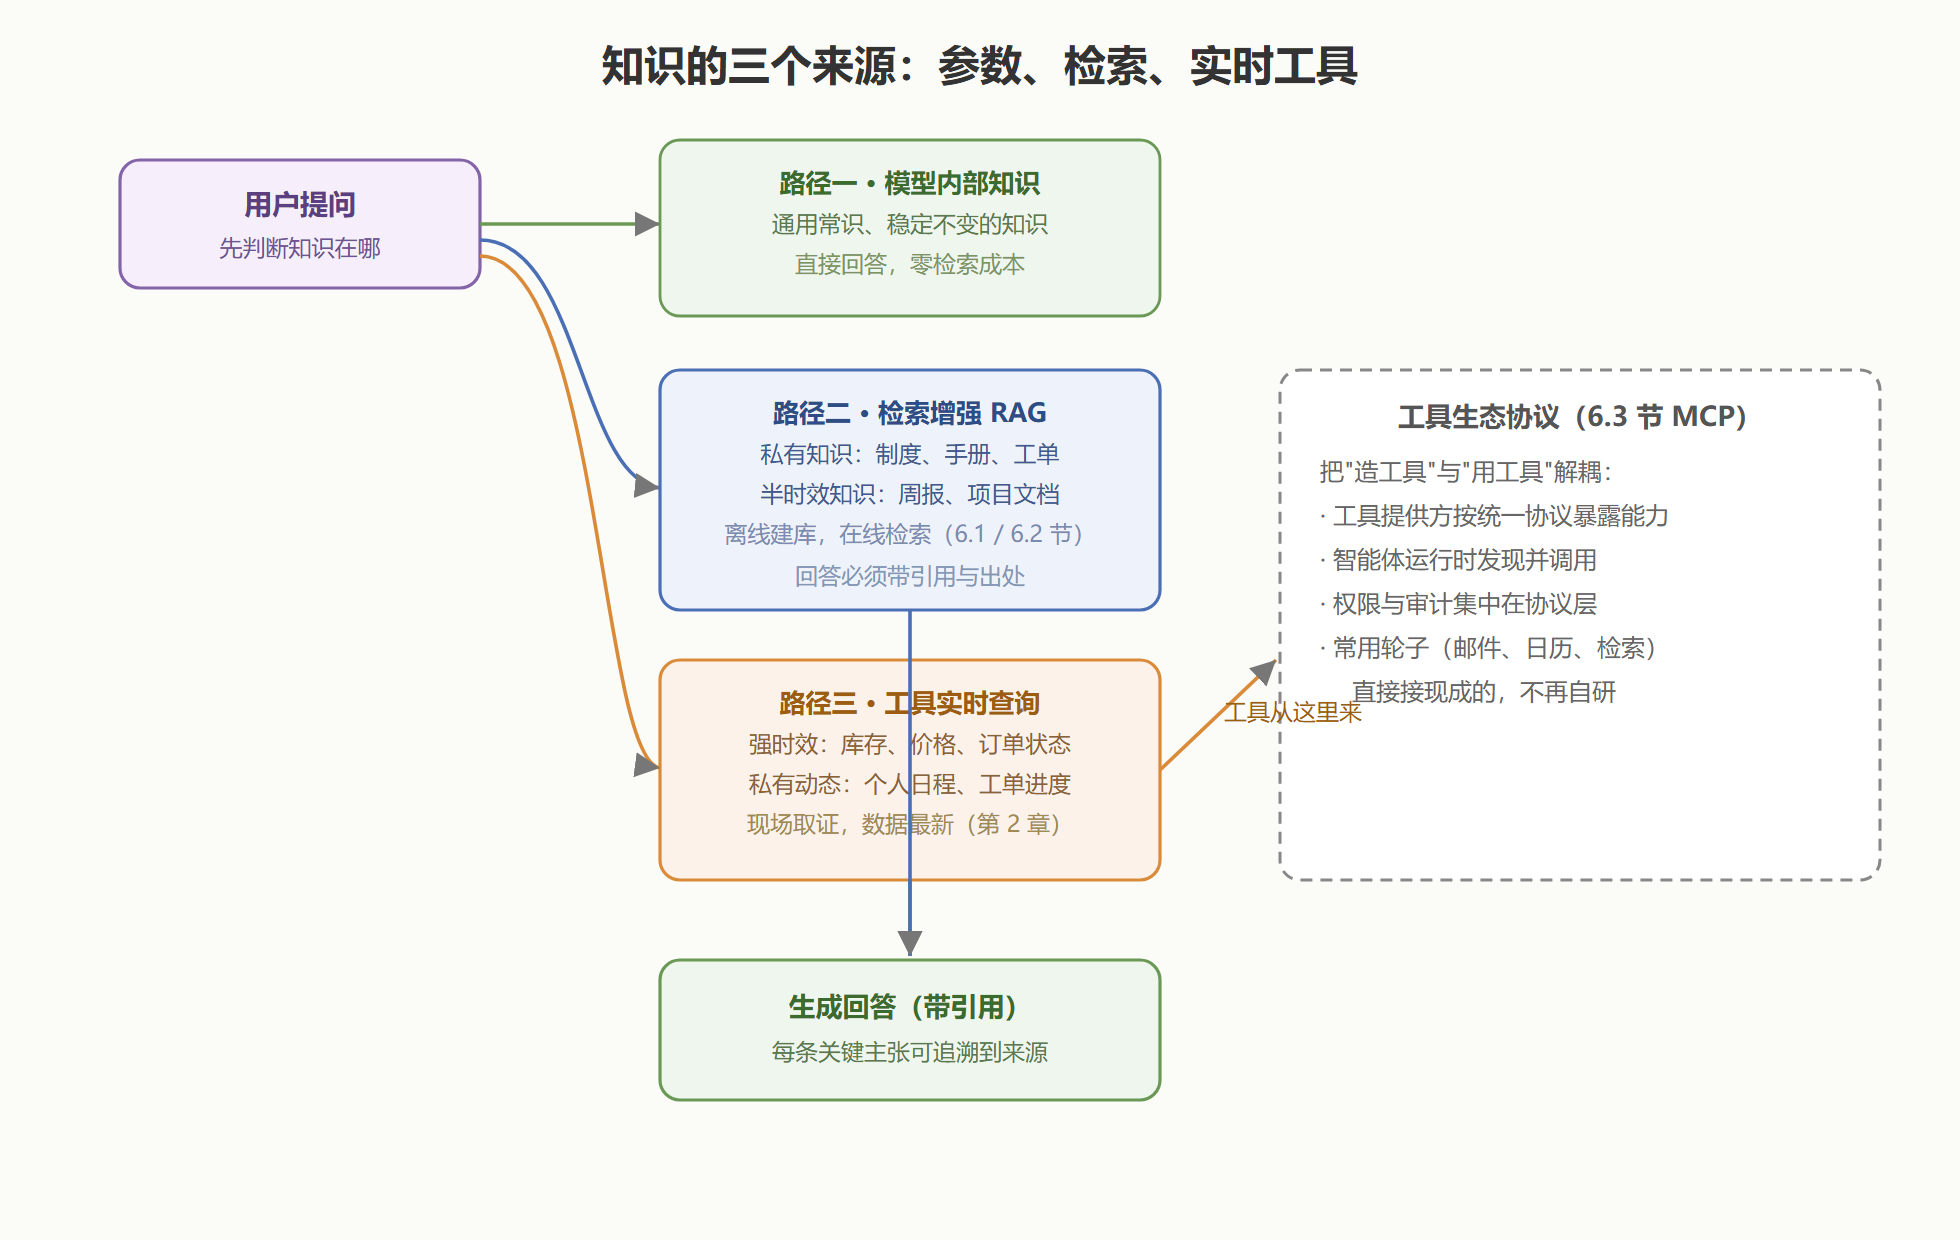
本章后半段处理另一个"接上世界"的问题:工具。前面各章的工具都是项目自研的,而查询订单、发邮件、读日历这类能力每个公司、每个项目都需要,重复造轮子的浪费肉眼可见。工具生态协议(以 MCP 为代表)要做的,就是把"造工具"和"用工具"解耦成两个市场。
本章全景
图:RAG 与工具的混合链路——三种知识来源各走各的门
读完能解决什么
- 能为一个知识问答需求选择正确路径:内部知识直接答、私有知识走 RAG、实时数据走工具,并说清误选的后果。
- 能搭建一条带引用的 RAG 链路,并对分块、top_k、重排等参数给出有依据的初始值与调优方法。
- 能判断"该进检索库还是该进模型权重"——微调与 RAG 的分工边界,避免用错重型方案。
- 能理解工具生态协议(MCP)解决的问题,决定哪些工具自研、哪些直接接入。
各节怎么分工
| 节 | 回答的问题 | 关键产出 |
|---|---|---|
| 6.1 RAG 原理 | 检索增强的链路与适用边界 | 最小 RAG 实现与路径判断 |
| 6.2 RAG 工程参数 | 检索质量怎么用参数管理 | 参数症状对照表与调参方法 |
| 6.3 工具生态与 MCP | 工具轮子怎么不重复造 | MCP 工具定义与接入决策 |
先决条件
- 读完第 3 章 3.2 节:向量库、嵌入、top_k 的概念本章直接复用,只是对象从"记忆"换成"知识"。
- 读完第 2 章 2.2 节:工具调用的协议是理解 MCP 的前置。
往下走到哪
见识接上了,能力接上了,剩下的问题是"怎么证明它靠谱、怎么保证它不出事"——第 7 章的评测与护栏,是敢把智能体放上产线的最后一道关卡。
建库前的三问
投入 RAG 建设之前,三个问题值得先答,答案决定投入的规模与形态。
一问:知识是否已经"库化"? 大量组织的真实困境不在检索技术,而在知识本身散落在个人电脑、聊天记录与离职员工的脑袋里。建 RAG 的第一步往往是知识治理——统一存储、明确责任人、建立更新流程。检索技术再好,喂进去的是陈旧的散稿,产出的只能是精致的过时答案。
二问:用户的问题是否"可检索"? 有些需求看似问答,实则是多步业务操作("帮我把这个口径的数据重新拉一遍"),RAG 只能回答其中"查"的部分。把问答需求与操作需求在入口处分流,检索库的定位才清晰。
三问:错误答案的代价有多高? 决定引用验真的投入级别——代价高的场景(合规、医疗、财务)需要 6.1 节的完整引用链加第 7 章的验真闸,代价低的场景(内部 FAQ)可以从简。RAG 的投入弹性极大,按答错的风险定规格,是最不容易后悔的预算原则。