2.1 加法秘密分享:一人一半
2.1 加法秘密分享:一人一半
本节摘要:加法秘密分享把数值 x 拆成随机数 r 和 x-r 两片,两方各持一片,任何单片都与 x 统计无关;加法与数乘在份额上直接进行。本节给出模运算下的完整拆分演算、均匀性论证、十行 Python 实现与"线性运算免费"的边界。
核心概念
拆一个数,最要紧的是拆出来的每一片必须"什么都不透露"。随手把 4257 拆成 4000 和 257 显然不合格。加法秘密分享的拆法是:在模 p 的整数环上(比如取素数 p),生成一个均匀随机的 r,令两片分别为 r 和 (x - r) mod p。爱丽丝拿第一片,鲍伯拿第二片。单看爱丽丝手里的 r——它就是从 0 到 p-1 里随便抽的,跟 x 是多少毫无关系;鲍伯那片同理,因为减去一个均匀随机数之后结果依然均匀随机。这叫完美保密:不是"很难推",是"信息量为零"。
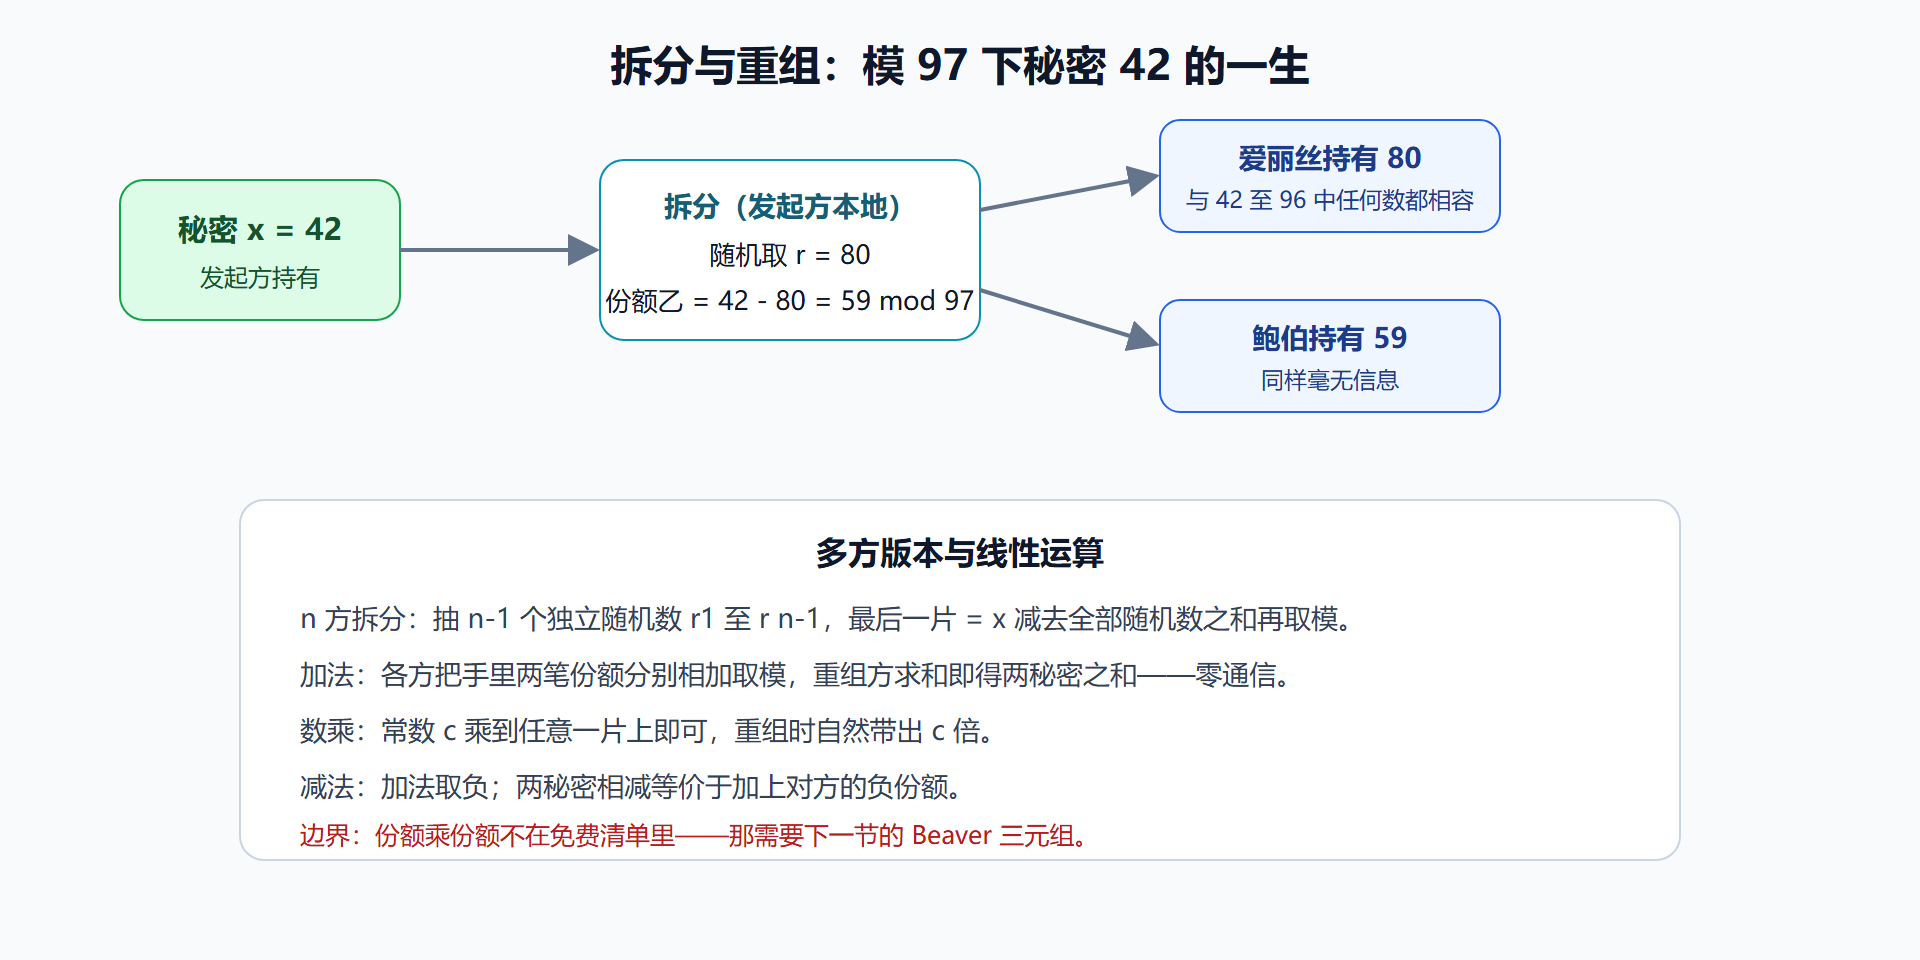
重组简单得不能再简单:两片相加取模。上一次演算,取 p = 97,秘密 x = 42。掷骰子得 r = 80,则另一片 = (42 - 80) mod 97 = (-38) mod 97 = 59。于是爱丽丝拿 80,鲍伯拿 59。验证:(80 + 59) mod 97 = 139 mod 97 = 42。而无论 x 是 42 还是 43 还是 96,爱丽丝手里是 80 的概率都一样是 1/97——她的 80 什么也没说。
图:加法秘密分享的拆分与重组
动手演练:十行 Python
概念代码把拆分、重组、加法一次跑通。把下面的逻辑放进任何支持模运算的环境都能验证:
P = 97 # 用小素数演示;生产系统用 2**64 或大素数域 def share(x, n=2): # 拆分:前 n-1 片随机,最后一片兜底 from secrets import randbelow pieces = [randbelow(P) for _ in range(n - 1)] last = (x - sum(pieces)) % P return pieces + [last] def combine(pieces): return sum(pieces) % P a, b = share(42) # 例:a=80, b=59(随机,每次不同) assert combine([a, b]) == 42 c, d = share(13) # 另一个秘密的份额 # 份额上加法 = 秘密加法:combine([a+c, b+d]) == 42+13 assert combine([(a + c) % P, (b + d) % P]) == (42 + 13) % P
会话输出形如:拆分 42 得到 80 与 59,重组回到 42;两份秘密的份额分别相加后重组得到 55。注意每次拆分的份额都不同——随机性就是保密性本身。
工程实践要点
为什么生产系统偏爱模 2 的 64 次方而不是素数域? 因为 64 位机器的整数溢出天然就是模 2^64 运算,加法零成本;SPDZ 系协议大量采用这种环。代价是环上没有完整的除法,涉及除法的计算要绕道。素数域则换来完整的域运算能力。选环还是选域,是每个框架的核心参数(第 6 章框架选型还会见到它)。
开放(reconstruct to public)与重组的区别。 协议里常说"开放某个值":各方把该值的份额广播出去、各自求和。开放的结果对所有人都可见,它本身就是协议泄露预算的一部分——好的协议严格控制开放次数与开放内容。新手最常见的错误是把不该开放的中间份额开放了,比如把 x 的份额开放后又开放 y 的份额,等于把 x、y 明文都交了出去。份额一旦开放,秘密即告死。
⚠️ 常见坑:多次拆分同一秘密时,每次的随机数必须独立。若两次拆分用了同一个 r,两次份额相减立刻消去随机性,直接得到两次秘密之差。随机数质量不行,整套密码学等于白搭。
本节要点:加法分享的保密性来自均匀随机掩码;线性运算(加、减、数乘)在份额上零通信完成;乘法不在线性运算清单里,这正是下一节要解决的问题。
拆分方案的变体与它们的脾气
加法分享有两个常见变体值得认识。多方拆分:n 方场景抽 n 减 1 个随机数、最后一片兜底,重组时全员到齐;它的安全模型是"任意 n 减 1 方合谋仍零信息",但可用性是全有全无——任何一方缺席数据就不可用。异或拆分:把模 p 加法换成按位异或,专供比特级计算(第 4 章 GMW 的地基);它在硬件上最便宜,异或是逻辑运算里成本最低的一种,但拿不到算术乘法的语义。
两个变体共享同一条安全论证:份额的唯一随机来源决定保密强度。亲手做一次分布检验,看看"单片均匀"在统计上长什么样:
from collections import Counter from secrets import randbelow P = 97 cnt = Counter() for trial in range(97000): x = trial % P # 轮换不同秘密 a = randbelow(P) b = (x - a) % P cnt[a] += 1 # 只观察甲方拿到的份额分布 print(min(cnt.values()), max(cnt.values())) # 各取值出现次数都紧贴 1000 上下
会话输出两个几乎相等的数:无论秘密怎么轮换,甲方份额在每个取值上的出现频率几乎相同——这就是"看了等于没看"的统计含义。
开放操作的纪律
协议里的"开放"指把某个值的份额广播重组为明文,它是泄露预算的记账单位。三条纪律值得写进团队规范:开放哪些值在设计期定死,运行期不许临时追加;开放顺序影响可推导关系,后开放的值可能帮助解读先开放的值;调试模式的"顺手打印中间份额"必须与生产代码物理隔离,历史上不止一个系统栽在调试打印忘了关。
从一次性拆分到长期保管
本节的演算都是"拆一次、算一次、开一次"的短周期场景,但加法分享同样服务于长期保管需求,只是要多考虑三件事。份额的备份悖论:加法分享缺一份即不可恢复,长期保管要么接受这个风险,要么对每份份额再做门限备份——工程上常见的形态是"逻辑上加法分享、物理上每份份额用 Shamir 存三份"。份额的轮换周期:保管越久,单点失窃的概率越高,定期重拆(重新随机化份额而不改变秘密本身)能把已泄露份额的价值清零,重拆协议本身又是一套多方交互。持有人的生命周期:机构人员流动、系统退役都会造成"份额还在、持有人已不在"的孤儿份额,治理流程要先行。
这三件事没有一件是数学问题,全是工程与治理问题,但它们决定了"拆开保管"这个想法能否真正落地。密码学论文负责证明拆法可行,工程手册负责让拆法活过十年——这本教程希望你在两个世界都能站立。
一个收尾的练习建议:把本节的十行 Python 抄下来跑一遍,然后把 P 换成 2 的 32 次方再跑一遍,观察份额与重组仍然正确——你会直观体会到"代数结构与参数无关"这句话的分量。后面所有章节的协议,都会先在小参数下讲结构,再到大参数下讲性能,路数与这次练习完全相同。