3.3 一张与门的混淆表:字节级拆解
3.3 一张与门的混淆表:字节级拆解
本节摘要:上一节讲了混淆表的原理,本节把它拆到字节:标准混淆表每扇与门 64 字节、Free-XOR 下 32 字节、半门优化约 48 比特密文加一枚标签、异或门 0 字节。字节从哪来、省在哪、为什么乱码行必须"长得像真行"——一次算清。
核心概念
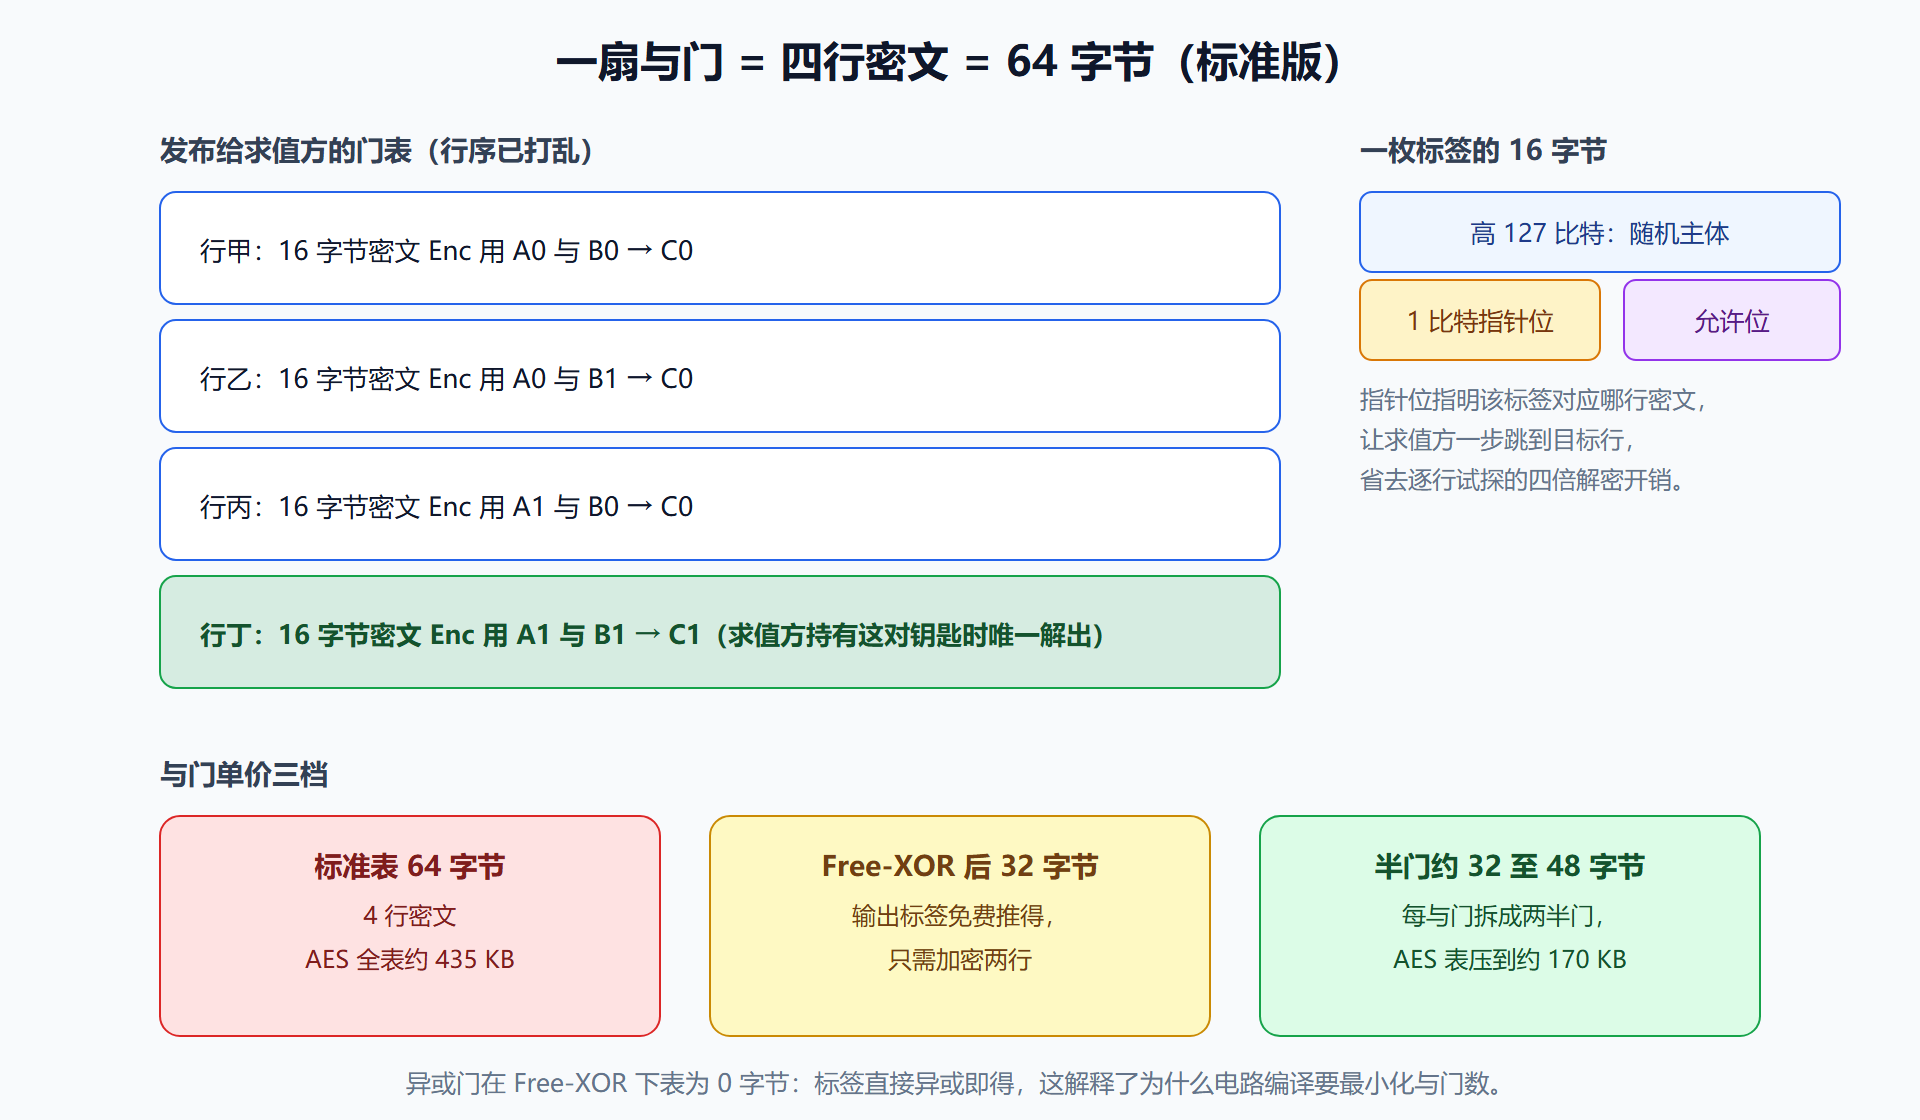
先算最朴素版本的账。一扇二输入门有四行真值表,每行要把一枚 128 比特(16 字节)的输出标签加密后传输,于是每扇与门 4 行 × 16 字节 = 64 字节。除了密文本身,每条密文还要携带输入标签的"取行指引"——即用到的两枚输入标签各带 1 比特的指针位(point-and-permit 技术),一般打包在标签的最低比特上,不额外占传输量。别忘了输入侧:每根电路输入线要向求值方交付一枚 16 字节标签,输出侧同理。所以一张电路的总通信量有个简洁公式:
总字节 ≈ 16 × (4 × 与门数 + 输入线数 + 输出线数)
拿真实函数感受量级:AES-128 的混淆电路约 6800 扇与门(总门数三万余扇,其余多为异或门),标准混淆表传 AES 一次就是 6800 × 64 字节 ≈ 435 KB,加上标签约 440 KB。百万富翁的 32 位比较电路只有几十扇与门,几 KB 搞定。电路一大,64 字节每门的单价就很贵——这就是为什么 3.4 节的优化族谱是 GC 工程化的主战场。
图:与门混淆表的字节布局
为什么乱码行必须乱得像样
求值方拿到门表会逐行试解:与钥匙匹配的那行解出合法标签,其余三行吐出"乱码"。安全性的微妙之处在于:求值方必须无法区分"我解错了"和"这行本来就不是给我的"。实现上靠两点:其一,对称加密的输出在错误钥匙下呈现均匀随机的伪标签;其二,3.2 节演示代码里"拿全表查合法性"的做法不可用——那等于给求值方一张验钞机,能探测行与标签的关系。工业方案(点旁路)把每枚标签的最低位设为 1,解密结果最低位是 0 才算成功,用 1 比特的代价比换掉整个查找表。这类"逐比特设计"正是混淆电路工程与教科书描述的最大差异。
动手演练:算一算你的函数要传多少
def gc_communication(and_gates, xor_gates, inputs, outputs, mode="point_permit"): """粗算混淆电路通信量(字节)。Free-XOR 下与门 2 行、异或门 0 行。""" rows = {"point_permit": 4, "free_xor": 2, "half_gates": 2}[mode] gate_bytes = rows * 16 total = and_gates * gate_bytes + (inputs + outputs) * 16 return total print(gc_communication(6800, 25000, 128, 128, "point_permit")) # 约 440 KB print(gc_communication(6800, 25000, 128, 128, "free_xor")) # 约 224 KB print(gc_communication(90, 70, 64, 2, "free_xor")) # 32 位比较两方合计约 3 KB
会话输出三行:440448、224256、3072。同样是 AES,换档直接省一半带宽;百万富翁级别的小电路则任何档位都是毫秒级负担——优化在"大电路高频调用"场景才显威力。
⚠️ 常见坑:把行序打乱当成可有可无。若密文行按真值表顺序排列,行号本身就泄露输出值分布(与门的输出 1 只在末行)。打乱行序、配指针位是标准动作,不是可选项。
本节要点:与门表单价三档 64B、32B、半门更省;AES 全表从 440 KB 压到 170 KB;乱码的"像样程度"与指针位设计是安全的细节所在。下一节把优化背后的代数原理讲透。
更多构件的体积账
把 16 字节乘法推广成一张"构件价目表",设计电路时心算就有依据。或门与非门:或门与与门同价(Free-XOR 下 32 字节),非门可以免费实现(输出标签把语义对调,靠选择比特 lambda 技巧,与 BMR 的思想同源)。多路选择器(mux):两选一约两扇与门加一扇异或门,约 80 字节,它是"分支展开"的执行者,规则引擎类电路的成本大头常在 mux。32 位加法器:按进位链约一百扇与门,三千字节上下;乘法则贵一个量级,数百扇与门起。比较器:约几十扇与门、几 KB——百万富翁问题的完整交付成本就在这个量级,一封邮件都装不满。
价目表的用法是反过来的:先定预算(比如本次任务总通信不超过 10 MB),再倒推电路规模上限(约 30 万扇与门),最后用这个上限去约束算法设计。通信预算驱动电路设计,是把 MPC 项目从"跑不通"带到"跑得体面"最有效的一条纪律。
从价目表到电路审计
有了字节级视角,你可以对任何一份混淆电路实现做"查账式审计",重点查四处。查行数:与门表是否两行(Free-XOR 生效的标志),若还是四行,要么没开优化、要么实现有误——两者都要问清楚。查指针位:标签最低位是否嵌入指针,求值方是否做到了每门单次解密;四重试探解密的实现意味着点旁路缺失,性能与安全双输。查随机源:标签生成与全局偏移 R 是否来自密码学安全随机数,rand 函数生成的标签等于门表裸奔。查输出映射时机:映射表是否严格在求值完成后发送,提前发送是 3.2 节讲过的致命伤。
这份审计清单的价值超出查错本身:它演示了"字节级理解"的回报——只有知道每个字节是什么的人,才有资格判断实现是否可信。这也是本教程坚持拆到字节的原因:混淆电路的抽象层次已经低到不能再低,从这里往下全是工程,往上全是应用,字节层是两者的合同边界。
顺手把账再往前推一步:既然每字节都有价,电路就有"编译器"——把高级语言程序翻译成优化电路的工具链,其输出质量(门数、深度)直接决定协议成本。第 6 章讲框架时会回看这个角色,届时你会发现选择框架很大程度就是在选择编译器的优化水平。
一道字节账的验算题
留一道可动手的验算题巩固字节账。某联合规则引擎的电路含与门 4000 扇、异或门 16000 扇、输入线 256 根、输出线 4 根,采用 Free-XOR 加行削减方案。请先自己算总通信量,再对答案:与门部分 4000 乘 32 字节等于 128 KB,输入输出标签 260 乘 16 字节约 4.2 KB,合计约 132 KB;若开恶意安全走 cut-and-choose 复制 40 份,门表部分乘 40 约 5.1 MB。两问的差距直观展示了恶意安全的价签,也解释了为什么大电路的恶意安全实现几乎都绑定半门优化——先压单价,再乘复制数,这是唯一划算的顺序。能独立算对这两问,本章的字节级视角就已经真正属于你了。