4.4 采样规划:RRT 与 PRM
4.4 采样规划:RRT 与 PRM
本节摘要:栅格搜索在六维以上的 C-space 里必然被维度灾难淹没——格子数指数爆炸。采样规划不铺格子,改成随机撒点建树(RRT)或建路网(PRM),用概率完备替代确定最优。本节讲清两者机制、RRT* 的改进原理与采样数怎么定。
A* 突然失效的那一刻
把第 4.2 节的 A* 搬到六轴机械臂上做无碰撞规划:C-space 是 6 维,每维只取 50 个离散值,格子数就是 50⁶ ≈ 156 亿——内存装不下,搜也搜不完。维度每加一,格子数乘 50,这就是维度灾难的算术。出路是换范式:别再枚举所有格子,只去"问"空间里有代表性的地方。随机撒点、够用就收,这就是采样规划。它放弃了两样东西:确定性(同一次规划跑两遍结果不同)与最优性(RRT 只保证概率完备——撒点次数趋于无穷时找到解的概率趋于 1)——换来在高维空间里"仍然能解"。
RRT:一棵向自由空间生长的树
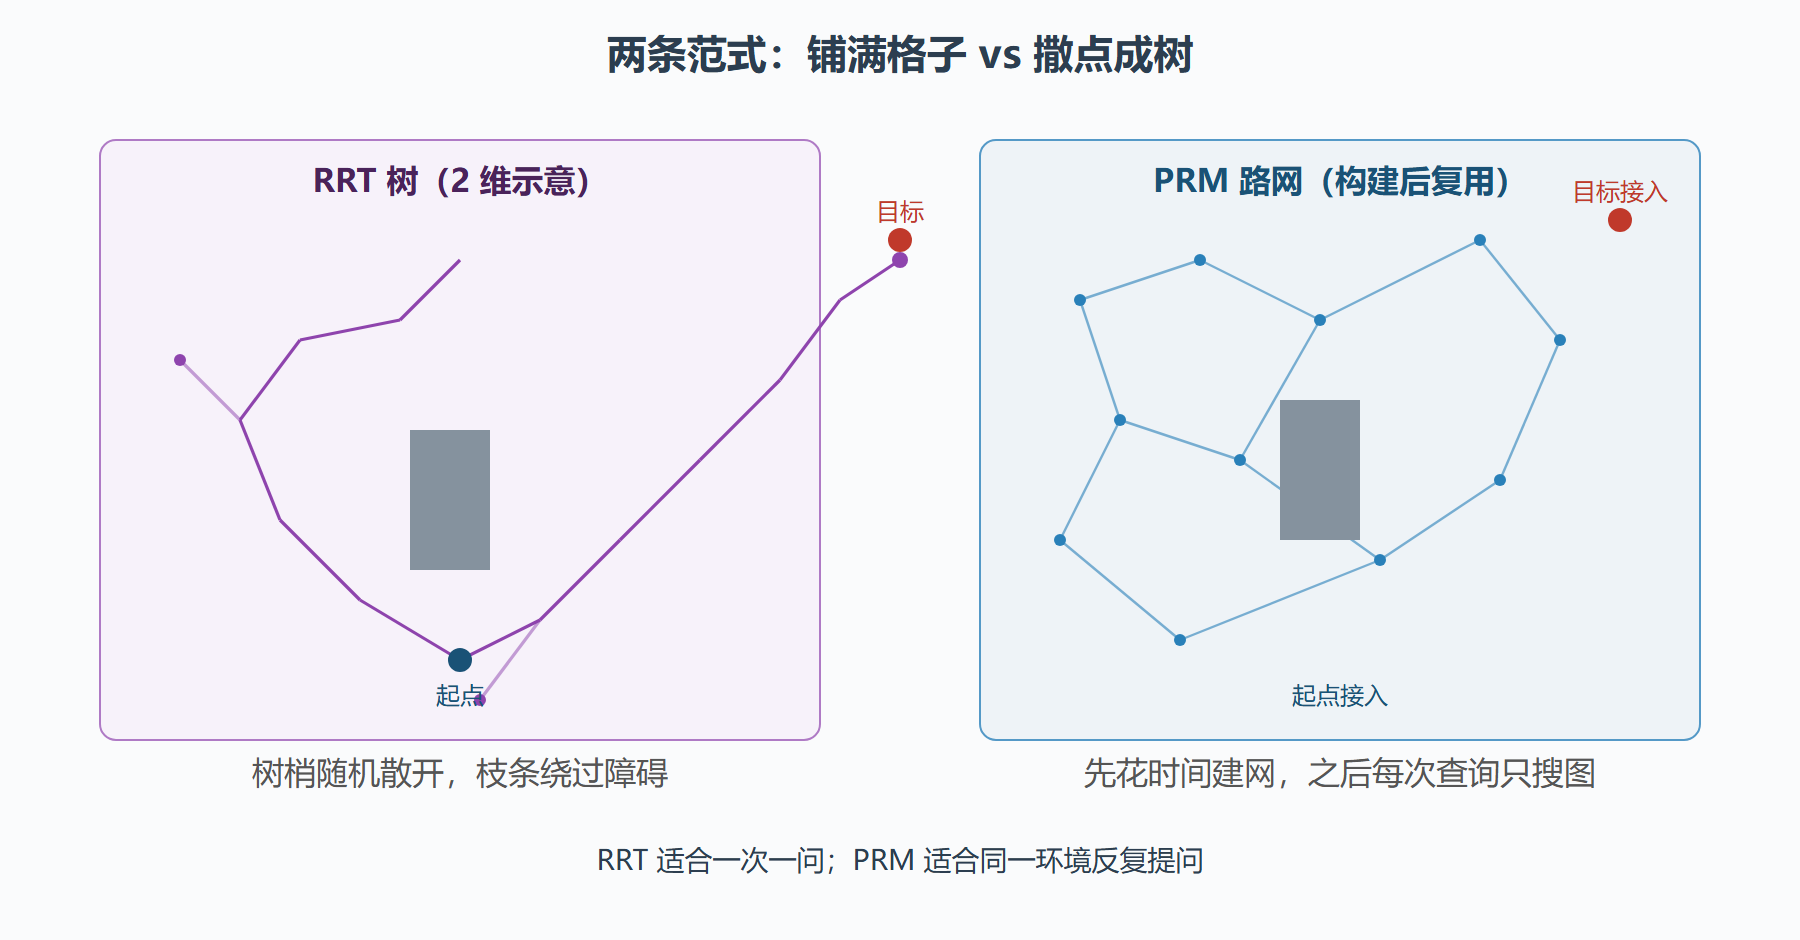
快速探索随机树(RRT)的循环只有四步,每一桶随机点都被树"吸"走一次:
def rrt_step(tree, c_free, goal, step=0.3, p_goal=0.05, rng=None): """单步扩张:教学版,c_free(q) 为碰撞检查""" rng = rng or np.random.default_rng() # 1. 采样:小概率直接取目标(引导),否则均匀随机 q_rand = goal if rng.random() < p_goal else c_free.sample() # 2. 找树上离它最近的节点 q_near = tree.nearest(q_rand) # 3. 向采样点走固定步长 direction = q_rand - q_near q_new = q_near + direction / np.linalg.norm(direction) * step if not c_free(q_new): # 4. 碰撞则丢弃 return None tree.add(q_new, parent=q_near) return q_new
四步里藏着采样规划的全部性格。"最近邻"步骤要求 C-space 定义距离度量——直接用关节角欧氏距离是错的:肩关节转 10 度与腕关节转 10 度对应的末端位移天差地别,工程上用雅可比加权或任务空间距离。"步长"是碰撞检查精度与树的扩张速度的交换旋钮:步长大检查少但容易跳过窄缝。目标偏置 p_goal(常用 5%)是效率的关键旋钮:纯随机树要很久才撞上目标邻域,加偏置后向目标方向引流,但太高(>15%)树退化成"一根竹竿",绕障能力丧失。
图:栅格搜索与采样树在同一环境的形态
RRT*:把"能到"升级成"越走越优"
RRT 找到的是"随便哪条路"——先到的枝条霸占通路,哪怕绕了大弯。RRT*(RRT-star)在扩张时加两步"择优":新节点入树时不选最近节点为父,而是在半径 r 的邻域内选"经由它到达新节点代价最小"的节点;随后再做重布线(rewire)——邻域内若有节点经新节点中转更省,就换父。每一步扩张都在顺手优化已有树。代价是每步从 O(log n) 涨到 O(n·log n),换来的回报有理论保证:解的代价随采样数增加渐近收敛到最优。数字感受:某 6 维规划任务,RRT 首个解代价约 1.8 倍最优,继续采样 10 秒后 RRT* 收敛到 1.2 倍以内,而 RRT 停留在首解不再改进。
PRM 与两个家族的选择
**PRM(概率路线图)*分两阶段:构建阶段在自由空间撒 N 个样本(典型 1000–5000),互相连接成路网;查询阶段把起终点接入网内,跑一遍 Dijkstra/A。同一环境反复查询(仓库固定布局、每天数千单)时,构建成本摊到每次查询近乎为零,这是 PRM 的主场;环境多变或只查一次,RRT 系按需生长更划算。
采样数的量级参考:二维至四维、简单障碍,1000 样本足够;六维带窄通道,要靠"高斯采样"或"桥测试采样"这类偏置采样专门轰击窄区域——均匀采样几乎永远撒不进窄门,这是采样规划在窄通道上的著名软肋。
⚠️ 常见坑:随机种子不固定导致联调复现失败。采样规划的非确定性会传染给整个系统测试——开发期固定种子,验收期再放开做多次统计。
本节要点
- 维度是分水岭:栅格搜索被指数爆炸锁死在低维,采样规划以概率完备换取高维可用性。
- RRT 四步循环里,距离度量、步长、目标偏置是三大工程旋钮;偏置过高树变竹竿。
- RRT* 用邻域择优与重布线换渐近最优,采样越久解越好;PRM 按构建-查询两阶段服务反复查询场景。
- 窄通道是采样法软肋,均匀采样几乎撒不进去,需偏置采样补救。
Informed RRT*:把采样"关进"有用区域
RRT* 收敛慢的一个原因显而易见:一旦找到一条初始路径,继续改进只需要在这条路径附近的"椭球区域"内采样——超出椭球的采样对改进无效。Informed RRT* 正是这么做的:以起终点为焦点、当前最优代价决定椭球形状,采样只落在椭球内。数字感受:某七维规划任务,普通 RRT* 采样两万次后的代价水平,Informed 版本五千次即达到。同族改进还有 Batch Informed(每批采样集中处理重布线,减少邻域查询次数),工程上常组合使用。这类改进没有改变"渐近最优"的理论性质,只是把收敛的常数项压低——理论保证与工程效率在此兼得。
碰撞检查:被忽视的算力大头
采样规划的运行时间八成耗在碰撞检查上,优化它收益最大。三层加速从便宜到贵:包围盒预筛——先用机器人的包围球与障碍包围盒做粗判,绝大多数采样在球面级别即被排除;层级检查——机器人与障碍各自用简化模型(凸包、体素金字塔)先查粗层,通过再查精细层;惰性碰撞检查——树的扩张先按"乐观"处理(不检查直接连),路径搜通后回头统一验证,失败的边再删除重搜(RRT-Connect 的经典手法)。三招叠加,六维规划的单次查询时间常能压掉一个数量级,而且完全不改变算法的完备性质。
问题:采样规划的结果每次都不一样,怎么验收
把"随机"纳入验收流程而不是回避它。规范做法:固定一组有代表性的起终点对(覆盖直行、绕障、窄门、奇异区),每对跑 N 次(典型 50 次)固定统计指标——成功率、代价均值与最大值、耗时分布。验收标准写在统计量上(比如成功率不低于 98%、代价不超过最优估计的 1.3 倍),而不是单次结果。开发期固定随机种子只为了调试可复现,验收期必须放开种子做统计——两者目的不同,不可混用。这套流程把随机算法的"不确定性"从风险转化为可量化的工程指标。