1.4 覆盖度与测序量估算:30x 是怎么算出来的
1.4 覆盖度与测序量估算:30x 是怎么算出来的
本节摘要:覆盖度决定结论的可信度,也决定预算。本节讲清覆盖度的定义、Lander-Waterman 模型如何把覆盖度翻译成"盲点概率",并给出常见项目的推荐覆盖度与下机数据量的完整估算过程。
先把术语掰开
覆盖度有两个容易被混用的含义。单碱基覆盖深度:某个位点被多少条独立读长覆盖,是随机变量;平均覆盖度:总碱基量除以基因组大小,是实验设计参数。"30x" 指后者——全基因组平均被盖了 30 层。注意平均数会掩盖局部:由于测序是随机采样,实际深度在均值附近呈泊松分布,有的位置 45 层,有的位置 18 层,还有极少数位置为零层(盲点)。
另一个常被误读的词是"覆盖度 95%":它不是说每个碱基都被盖到,而是说基因组 95% 的区域至少被一条读长覆盖,剩下的 5% 是盲点。基因组里那些高 GC、高度重复的区域最难测到,它们恰恰是盲点的主要来源。
Lander-Waterman:把运气算成公式
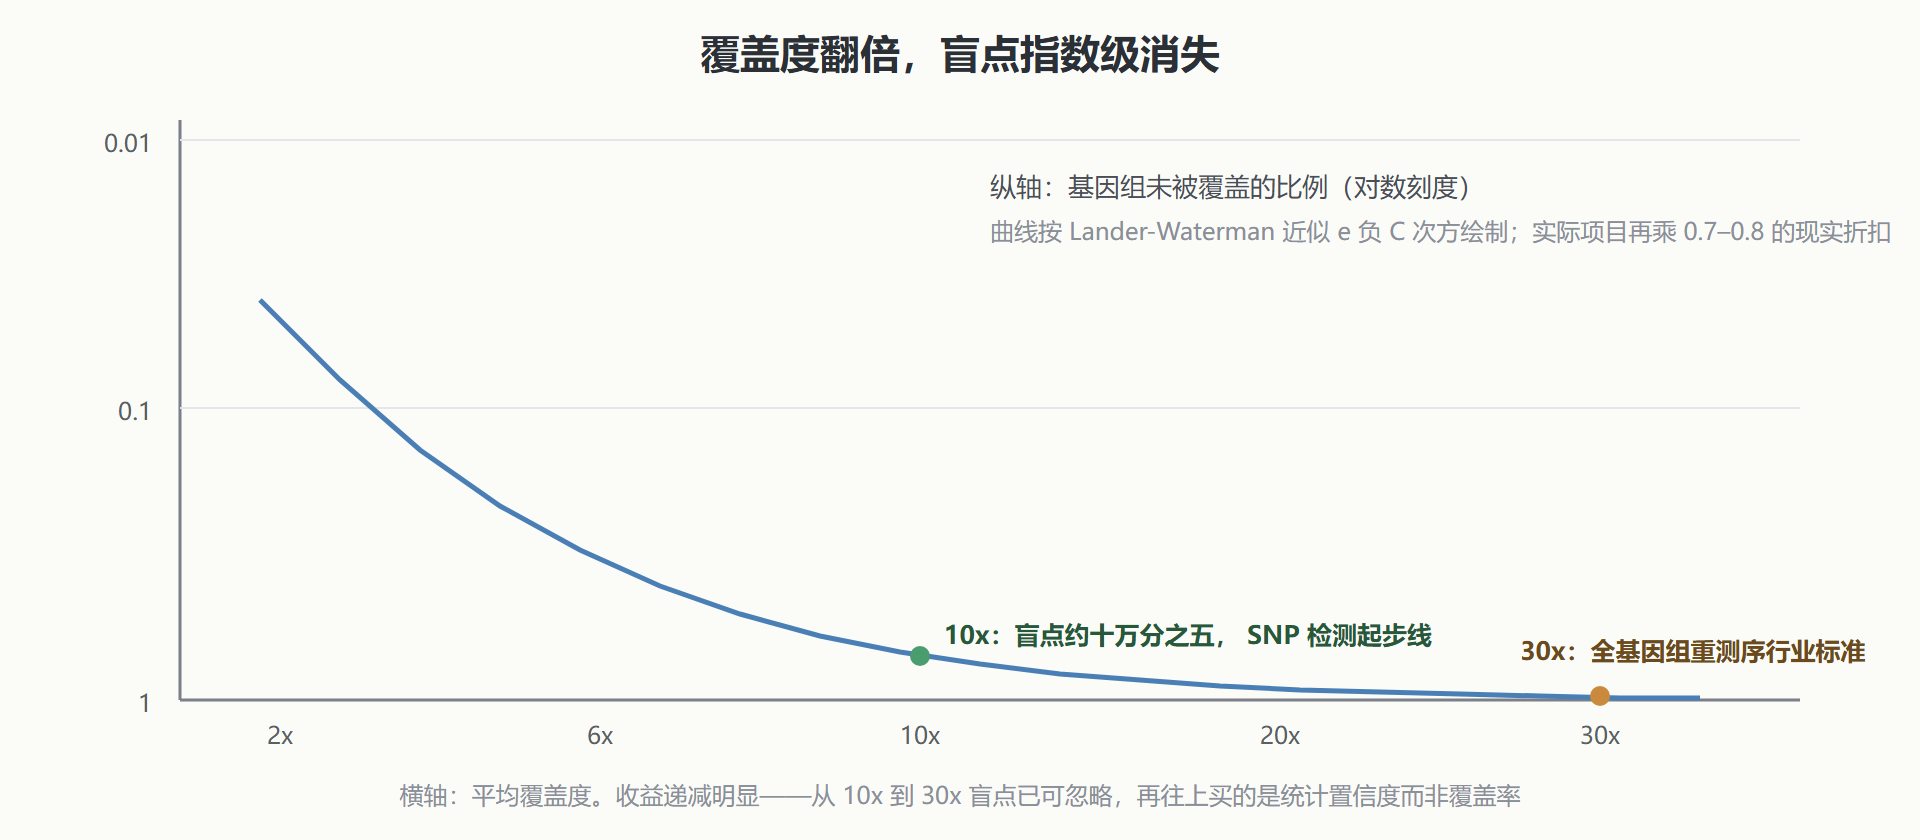
1998 年之前这个模型就建立了(Lander 与 Waterman 在人类基因组计划早期提出),它回答的问题很直接:以随机位置、长度 L 的读长覆盖大小为 G 的基因组,读到平均 C 倍覆盖时,某个位置完全没被覆盖的概率有多大。盲点比例近似等于 e 的负 C 次方:
- C = 5x 时,盲点约 e⁻⁵ ≈ 0.7%;
- C = 10x 时,约 e⁻¹⁰ ≈ 0.005%;
- C = 30x 时,理论盲点已低于亿分之一。
理论公式之外还有现实修正:偏 GC 偏好、重复序列无法唯一定位、mapping 过滤损失,这些都会让有效覆盖低于名义覆盖。工程上的经验是把理论值乘以 0.7 到 0.8 的折扣再去对照需求。这就是全基因组重测序默认 30x、外显子组 100x 以上、临床检测动辄 500x 的由来——不是拍脑袋,而是给"多数表决"留出足够的票数。
图:覆盖度与盲点、可信度的关系曲线
完整估算一次:肿瘤全外显子组项目
把公式用起来。设目标:肿瘤-正常配对全外显子组测序(WES),外显子区约 36 MB(3600 万碱基),要求肿瘤样本有效覆盖 120x。估算顺序如下。
第一步,名义数据量:36 MB × 120 = 4.32 G bp 覆盖外显子区。第二步,回补捕获效率:探针杂交捕获不可能只抓外显子,脱靶加上捕获效率 70% 计,实际需要下机 4.32 / 0.7 ≈ 6.2 G bp。第三步,回补质控损失:过滤低质量读长约损失 10%,需 6.2 / 0.9 ≈ 6.9 G bp。第四步,换算成读长条数:150 bp 双端读长一条贡献 300 bp,约 6.9 G / 300 ≈ 2300 万对读长,对应约 7 GB 的 FASTQ(压缩后)。第五步,换算成订单语言:常见 NovaSeq 通道产量除一下就知道几个样本能拼一个通道,这也是测序公司报价的底层逻辑。
def reads_needed(genome_mb, target_x, capture_eff=1.0, qc_pass=0.9, read_len=150, paired=True): """估算达到目标覆盖度所需的双端读长对数与 FASTQ 体量""" bases = genome_mb * 1e6 * target_x / capture_eff / qc_pass pairs = bases / (read_len * (2 if paired else 1)) return int(pairs), round(bases / 1e9, 2) # (读长对数, Gbp) print(reads_needed(3600, 120, capture_eff=0.7)) # 外显子组 120x print(reads_needed(3000, 30)) # 人类全基因组 30x # 输出: # (34285714, 10.29) # (300000000, 90.0)
常见项目速查与误读
| 项目类型 | 常规覆盖度 | 理由 |
|---|---|---|
| 全基因组重测序(人) | 30x | SNP 检测的精度与成本平衡点 |
| 全外显子组 | 100–150x | 捕获后有效深度打折,需预补 |
| 肿瘤体细胞变异 | 肿瘤 150x / 正常 60x 以上 | 要在杂合肿瘤细胞里抓低频突变 |
| 转录组 RNA-seq | 每样本 20–50 M 对读长 | 按"条数"而非"x"计,服务于定量 |
| 宏基因组 | 每样本 5–10 G bp | 物种组成估计比单点精度更稀缺 |
| 基因组从头组装 | HiFi 25–30x | 高一致读长比超深更值钱 |
两个高频误读顺带纠正。其一,"测得越深结果越好"只在一定范围内成立:30x 到 60x 对 SNP 检测的增益已经很小,多出来的钱不如换平台或加样本量。其二,RNA-seq 没有"基因组覆盖度"的概念——转录组是动态集合,它的深度指标是比对到基因区的读长条数与基因表达量的饱和曲线,2.6 节展开。
实测覆盖度:名义之外的另一本账
实验做完后要回答的是另一面:实际测到的覆盖度如何、分布是否均匀。工具层面一条命令就能拿到逐碱基深度,再算几项汇总指标:
# 逐碱基深度(BAM 需先排序与建索引) samtools depth -a sample.sorted.bam > depth.txt awk '{s+=$3; if($3>=30) c++} END{print "平均深度:", s/NR; print "≥30x 比例:", c/NR}' depth.txt # 覆盖均匀度常用指标:深度中位数/平均值,以及DepthofCoverage的分位数曲线
判读时盯三处。平均深度与订单名义值的差距过大(比如只拿到名义的六成),先看比对率与重复比例——损耗大头常在这里。深度分布的断层(部分染色体整体偏浅)指向拷贝数异常或捕获偏差。局部极端堆积(平均值正常但少数位置深出百倍)通常是重复序列或引物伪影,变异检测会过滤它们,但定量类分析要另行处理。这几项检查做完,你对"这份数据能支撑什么强度的结论"就有了量化底气——这正是第 2 章所有下游分析前应有的健康证明。
覆盖度的两条口径陷阱
谈覆盖度还有两个口径问题,合同与报告里经常打架。其一是"原始数据量"与"唯一比对数据量":测序公司按下机碱基量交付,而你能用的只有比对到基因组的部分——重复读长、低质量读长、未比对读长都要扣除,签合同时应约定按比对后口径验收,或至少注明名义深度的折扣预期。其二是"全基因组平均"与"目标区域覆盖":外显子组项目的名义深度算在捕获区上,捕获区外的测序量是"陪跑"的;看覆盖报告要盯目标区间的 20x 覆盖比例(外显子组通常要求 95% 以上),而不是笼统的平均值。
统计口径之外还有一个生物口径:肿瘤样本的覆盖度要求还叠加了纯度与倍性——肿瘤细胞只占样本的一部分、基因组倍性又不是整齐的两倍,同样 150x 的名义深度摊到肿瘤细胞的等位基因上可能只有几十倍。这就是临床样本报告里必须同时给出肿瘤纯度与有效深度的原因:覆盖度从来不是一个数字,而是一组口径明确的数字。
到这里,第 1 章的问题——数据长什么样——已经有了完整答案:FASTQ 容器、质量标尺、读长尺度、覆盖深度。第 2 章开始动手加工这些数据。