1.3 读长对照:短读长与长读长各适合什么问题
1.3 读长对照:短读长与长读长各适合什么问题
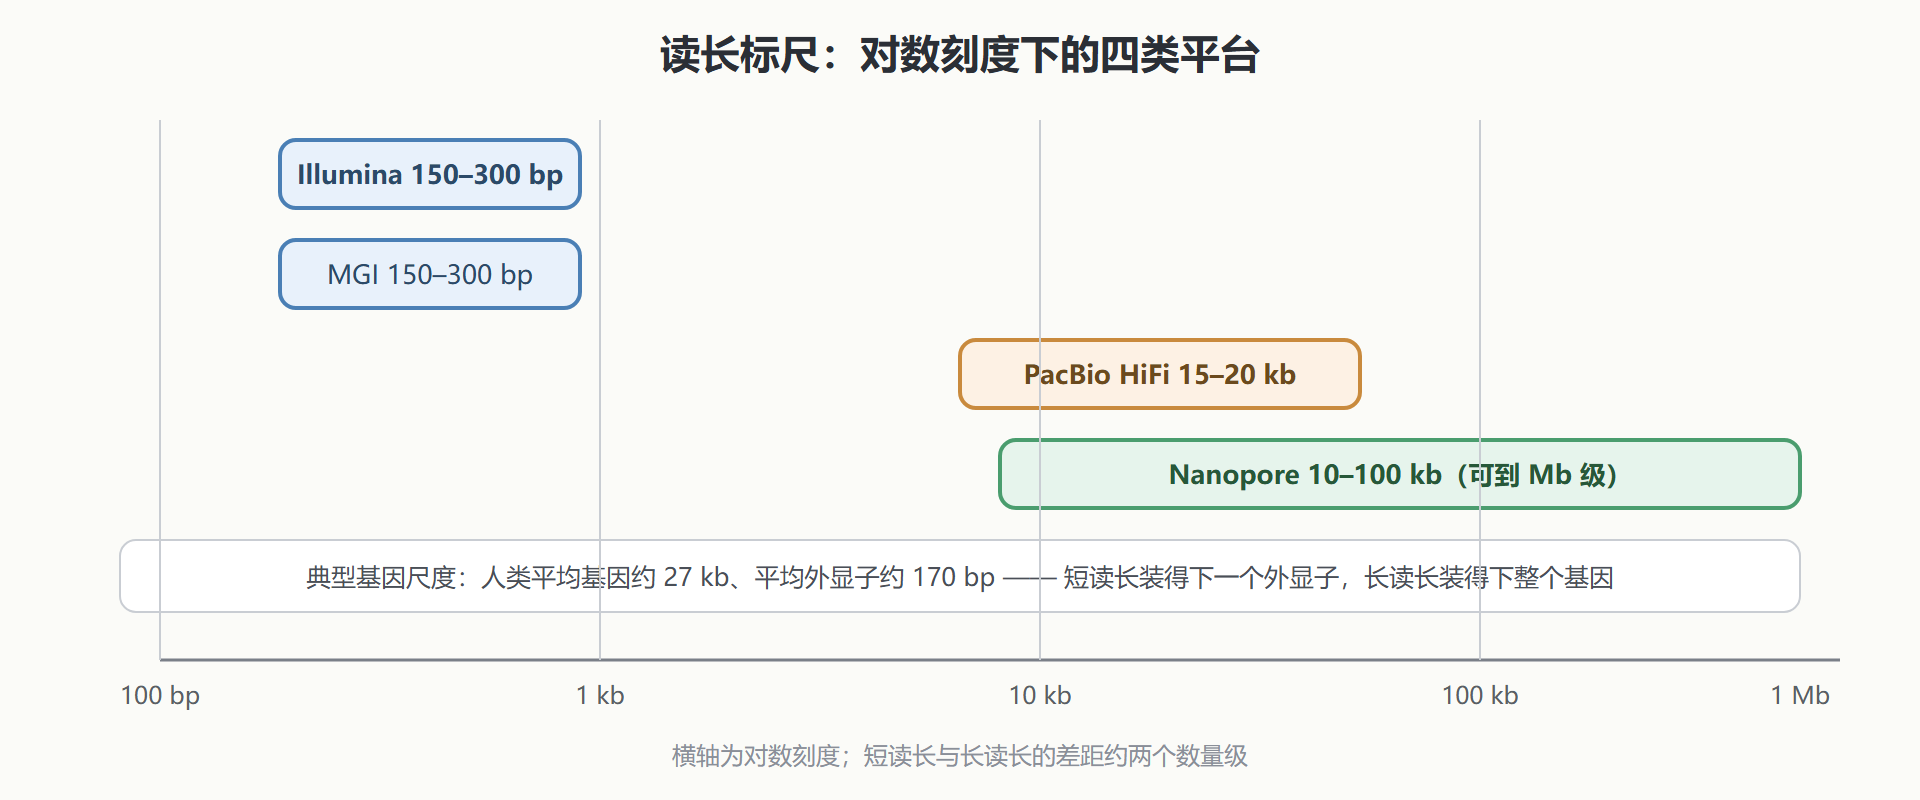
本节摘要:Illumina 短读长 150–300 bp,Nanopore 长读长 10–100 kb,两者相差两个数量级。本节用同一份基因组做参照,对比主流平台的读长、准确率与成本结构,并给出按问题类型选平台的决策依据。
用一把尺子量所有平台
把读长放到人类基因组的尺度上看,短读长是什么概念:基因组 30 亿对碱基,150 bp 的读长相当于全书 30 亿个字母里每次抄 150 个。要靠这些碎片还原全书,靠的是天文数字的碎片叠加覆盖。长读长则相当于每次抄上万到上万个字母,一个读长就能横跨普通基因的完整结构。
| 平台 | 典型读长 | 单碱基准确率 | 优势 | 主要短板 |
|---|---|---|---|---|
| Illumina NovaSeq | 150–300 bp(双端) | 99.9%(Q30 以上为主) | 通量巨大、碱基最便宜 | 跨不过重复序列 |
| MGI DNBSEQ | 150–300 bp | 99.9% | 国产替代、成本相近 | 生态略小 |
| PacBio HiFi | 15–20 kb | 99.9%(环化一致序列) | 长读长与高精度兼得 | 单位数据成本高 |
| Oxford Nanopore | 10–100 kb 甚至更长 | 97%–99%(依赖模型版本) | 实时读取、超长读长、便携 | 单碱基错误率偏高 |
注意 PacBio HiFi 是个特例:它把同一种分子环化反复测很多轮,再用一致序列把随机错误抵消,于是同时拿到长读长与 Q30 级精度——代价是原始数据量消耗很大。
图:四类平台的读长标尺对照
各自擅长的问题
短读长的强项是大深度、高精度、低成本。全基因组重测序找 SNP、转录组定量、宏基因组物种丰度,这些场景需要的是对每个位点的反复确认,而不是单条读长看得多远——30x 覆盖意味着基因组每个位置平均被 30 条独立读长印证过,随机错误被多数表决淹没。这就是 Illumina 至今占据绝大多数产量的原因。
长读长的强项是跨越障碍。基因组的重复序列、结构变异、复杂区域,短读长读不完整、拼不回去:一个 5 kb 的转座子插进基因组,150 bp 的读长只能看到它的边缘;一条 20 kb 的 Nanopore 读长能从侧翼一路读穿插入片段本身。基因组组装(T2T 端粒到端粒的完整图谱)、罕见病里的复杂结构变异、微生物的完整质粒识别,都是长读长的主场。此外 Nanopore 直接测原始 DNA,还能识别碱基修饰(如 5mC 甲基化),这是短读长需要额外建库才能做的事。
转录组里两者的分工也很清晰:短读长测断裂的 cDNA 片段,适合定量;长读长能读通整条 mRNA 异构体,适合搞清一个基因到底产生了哪几种剪接形式。不少大型项目干脆双平台并行——短读长负责精度,长读长负责结构,最后互为校验。
用三个问题决定选型
选平台本质是三个问题的答案。要找的东西有多大:点突变和小 indel,短读长足够;大于读长的结构变异、重复扩增病(如脆性 X 综合征的 CGG 重复),必须长读长。要多少深度:需要上百倍深度定量(转录组、液态活检),短读长的单碱基成本优势碾压;组装新物种只需 30x 左右的高质量长读长。要不要实时:Nanopore 是唯一能边测边出结果的平台,现场流行病学调查(疫情溯源、口岸检测)里这一条就能一锤定音。
预算有限时还有一个混合策略值得记住:用 Nanopore 测 20x 铺出骨架,再用 Illumina 补 30x 修正碱基级错误,总成本往往低于单一 PacBio HiFi 方案。组装领域这套"长读长搭骨架、短读长抛光"的做法已经非常成熟。
一笔具体的账:三个真实项目的选型推演
把选型逻辑落成三笔账。项目一是人群 SNP 普筛:五千个样本、每人 30x 全基因组,结论只需要点变异——Illumina 短读长是唯一现实解,长读长的单价撑不起这个规模。项目二是罕见病疑难病例:家系里临床外显子组无发现,怀疑大片段重排或重复扩增——加测一个 Nanopore 或 HiFi 样本(10x 到 20x 足够),直接读穿候选区域的断裂点,这步的钱花在刀刃上。项目三是新测序的药用真菌基因组:高重复、基因组长、杂合——HiFi 25x 加 Hi-C 挂载做染色体级组装,短读长哪怕 100x 也只能拼出碎片化的草图。
预算谈判时有一个实用的表述方式:把需求翻译成"数据量 × 单价 × 交付指标"三项。短读长的单价按每 Gbp 计,长读长常按流动池或芯片次数计——计价单位不同,直接比单价会误导,按项目总产出折算才有可比性。另外别忘了隐藏成本:长读长的计算分析更重(组装耗时、内存需求高),短读长项目的存储与传输费用在大队列里也不可小觑。
| 项目形态 | 推荐平台 | 深度 | 理由 |
|---|---|---|---|
| 大队列 SNP 普筛 | Illumina/MGI | 30x | 单价最低、精度最高 |
| 罕见病疑难 | 短读长加长读长补充 | 30x 加 10–20x | 断裂点直读 |
| 新物种基因组组装 | PacBio HiFi 加 Hi-C | 25–30x | 长且准,可挂染色体 |
| 现场病原监测 | Nanopore | 视样本 | 实时出结果、设备便携 |
| 转录本异构体分析 | Nanopore cDNA/direct RNA | 每样本数百万条 | 全长异构体直读 |
选型的最后一条经验是:先问交付物,再问平台。要的是变异列表、完整基因组、转录本全景还是实时预警?交付物倒推数据形态,数据形态倒推平台——顺序反过来(先看平台再凑需求)是预算超支的开端。
长读长数据的独特噪声形态
长读长不只是"读得长",它的数据形态也自成一派,直接套用短读长的质控与分析习惯会出问题。错误模式上,Nanopore 的错误以 indel 为主(尤其在同聚物区,一段连续相同碱基的个数容易数错),而 Illumina 的错误以替换为主——这对下游影响巨大:SNP 检测对替换敏感,indel 检测对同聚物区天生脆弱,两家的误差谱刚好互补,这也是混合策略有效的根本原因。质量分布上,长读长的碱基质量整体偏低且尾部拖得长,按短读长习惯"剪掉低质量尾"会把读长剪没——长读长的质控更多是整条过滤而非修剪。
读长的分布还带有人为选择性:越长的片段越脆弱,上机前的操作(移液、震荡)都会折断 DNA 分子,所以长读长项目对样本处理的要求近乎苛刻——高分子量 DNA 的提取是整个流程里最娇气的环节,很多"读长不够长"的项目,问题出在提取而不是仪器。规划长读长项目时,样本处理的预算与培训要提前排进计划。
读长与平台定了,接下来还有一笔账要算:测多深才算够——这就是覆盖度的问题,也是下一节的主题。