5.5 共享记忆块与多智能体协作
5.5 共享记忆块与多智能体协作
本节摘要:记忆块的共享机制让多个智能体读写同一份记忆:项目状态块挂在团队智能体之间,一处更新、处处可见。本节讲清共享块的创建与挂载、多智能体协作的典型拓扑,以及共享带来的写入冲突与权限治理问题。读完本节,你能搭建一个小型智能体协作组,并守住共享记忆的边界。
当记忆需要跨智能体流动
单智能体的记忆再好,也解决不了一类问题:同一份事实,多个智能体各记各的。项目里同时跑着三个助手——日程助理记了"发布日改到下周五",汇报助理的记录还是"下周一",客服助理压根不知道有变更。用户对任何一个发问都可能得到不一致的答案。问题的本质不是哪个智能体记错了,而是"发布日"这个事实被复制成了三份私有认知,副本之间没有同步机制。
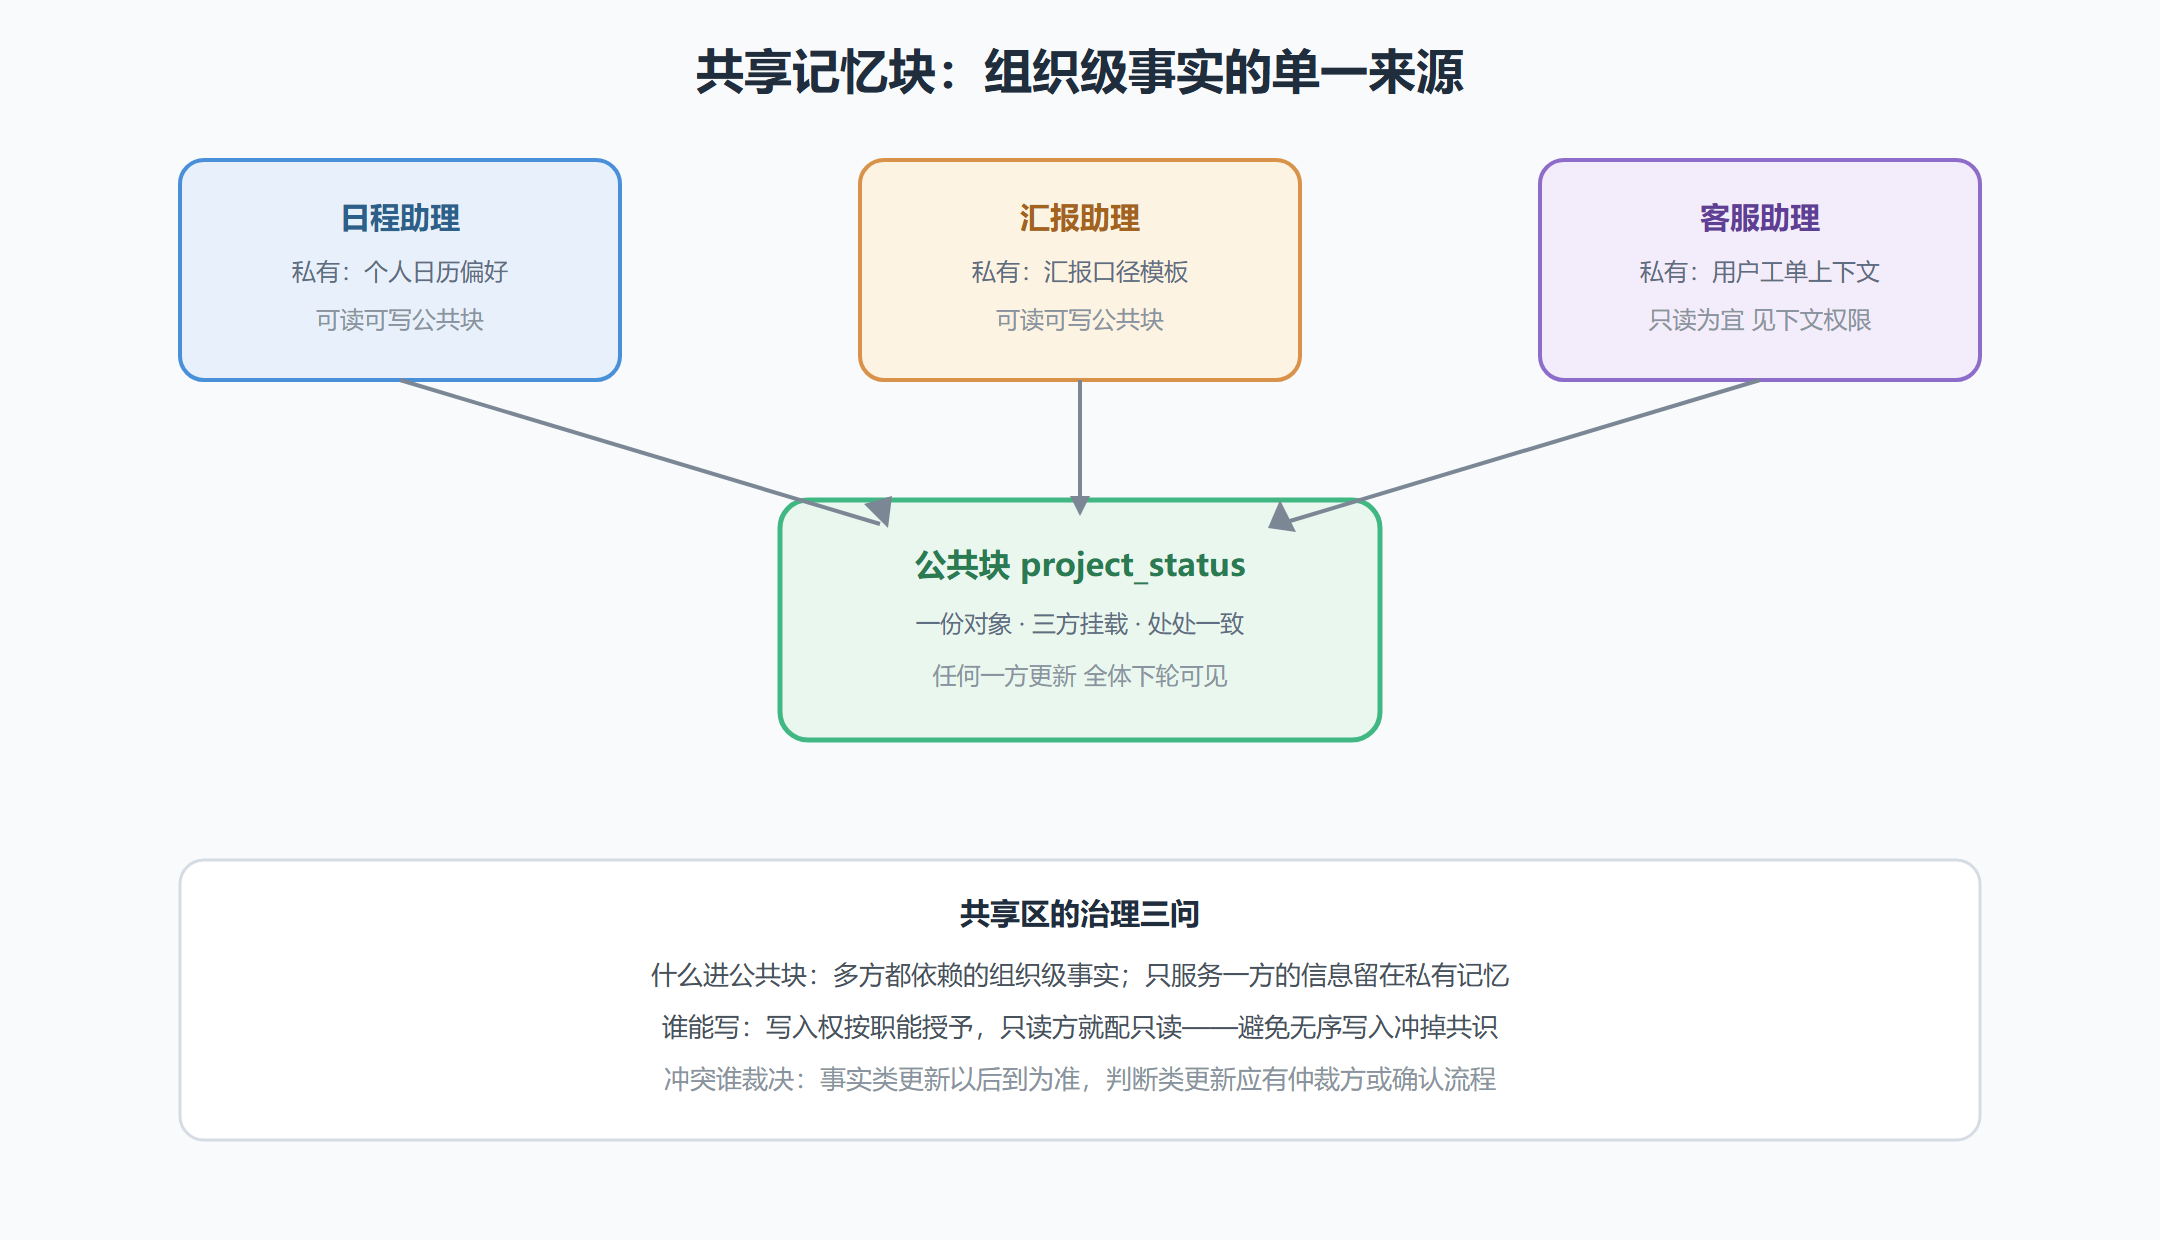
共享记忆块给出的解法干脆利落:把这类组织级事实从各智能体的私有记忆里抽出来,放进一个被多方挂载的公共块。块只有一份,谁更新都是更新这一份,所有挂载者在下一轮推理时自动看到新值。副本同步问题在结构上消失了——这正是 2.2 节"记忆块是一等公民"的群体级延伸:块不仅能被模型改写,还能被多个智能体共同持有。
共享块的创建与挂载
机制上,共享块就是一个独立创建的记忆块对象,创建后挂载到需要的智能体上。挂载同一块的多个智能体,读写的是同一个对象:
from letta_client import Letta client = Letta(base_url="http://localhost:8283") # 先创建独立的公共块:一份团队事实源 project_block = client.blocks.create( label="project_status", value="发布窗口:下周五。灰度范围:百分之十用户。", limit=5000, ) # 三个智能体都挂载这个块:此后读写的是同一份 for spec in [ ("schedule_assistant", "你是日程助理,发布相关安排以 project_status 块为准。"), ("report_assistant", "你是汇报助理,进度汇报以 project_status 块为准。"), ("support_assistant", "你是客服助理,用户询问发布计划时查 project_status 块。"), ]: agent = client.agents.create( name=spec[0], memory_blocks=[ {"label": "persona", "value": spec[1]}, {"label": "human", "value": "团队成员。"}, ], model="openai/gpt-4o-mini", embedding="openai/text-embedding-3-small", ) # 把公共块挂载进该智能体 client.agents.blocks.attach(agent_id=agent.id, block_id=project_block.id)
注意每个 persona 里的那句话:"以 project_status 块为准"。共享块解决的是"看到同一份",但优先引用它是行为习惯,要靠 persona 引导养成。不写这句,模型可能继续用私有记忆里的旧印象作答——机制给了同一份事实,策略才保证它被采用。
代码里还有一个细节值得单独解释:块是先独立创建、后挂载进智能体的。这个顺序不是语法要求,而是设计自由——你可以创建一个空白的公共块,先在三个智能体上线运行后,再决定往里面放什么;也可以把已经运行多日的某智能体的私有块"升级"为共享块,让它的既有内容瞬间对全体挂载方可见。共享关系的建立是运行时的操作,不需要重建任何智能体——这让协作结构可以跟着团队的实际需要逐步生长,而不是一上来就画好组织架构图。
图 5-3 共享记忆协作拓扑:一份事实,多方持挂
协作拓扑的两种基本形态
共享块撑起的最简协作有两类拓扑,复杂协作都是它们的组合。星型拓扑:一个协调者智能体挂全部业务块,若干执行者各挂自己需要的块,协调者拆解任务、分派执行、汇总结果。管线拓扑:智能体按流程接力——调研员把结论写入公共块,撰写者从块里读取并产出草稿,审校者再读取草稿块的修订记录。两种形态里,公共块都扮演"智能体之间的通信介质":与其让智能体互发消息各自转述,不如让它们读写同一份结构化记忆,转述失真从源头消除。
选择拓扑的判断依据是协作的方向性:多方围绕同一事实协同(项目状态、团队口径),用星型;流程有先后接力的顺序(调研到撰写到审校),用管线。拿不准时从星型起步——它更接近人对团队的直觉,调试也直观。
无论哪种拓扑,都建议给协作组配一个最小验证剧本:三个典型场景(正常流转、边界情况、故意注入一条坏信息),每次调整拓扑或权限后完整跑一遍。多智能体系统的行为组合数是乘法级的——三个智能体各自的记忆状态、两两之间的共享关系,人脑穷举不过来,剧本是你唯一可靠的回归手段。5.1 节的"验证起点"是个体纪律,这里是群体纪律,逻辑一脉相承。
共享的代价:写入冲突与权限治理
共享的代价在写入端。多个智能体都能写同一块时,两类事故高发:覆盖事故——甲刚更新的事实被乙用旧认知覆盖回去;杂讯事故——各方按自己的格式往块里塞信息,公共块迅速变成无人能读的杂物间。治理的手段在拓扑图下方已经列出,落到工程上就是三条纪律:
- 最小共享:公共块只放多方确实都依赖的事实,数量宜少、职责宜专——一个团队两三个公共块是好状态,十几个说明职责没想清。
- 写入权限收窄:客服类智能体对公共块只读;写入权授予唯一职能方(如日程助理管发布窗口)。权限的粒度按"谁能改哪一块"设计,而不是"谁能访问哪个智能体"。
- 格式先行:公共块创建时就放一条格式示例(同 5.1 节的冷启动原则),后续写入自动对齐;定期巡视公共块的内容质量,杂讯及时清出。
⚠️ 共享块的变更是群体事件:一处修改,所有挂载方的行为基线同时改变。上线前务必在测试环境验证"改这一块,三个智能体各自会有什么反应"——这在私有记忆时代是个体事件,共享之后就是系统事件了。
关于共享记忆的常见疑问
问:两个智能体能直接对话吗? 在共享块之外,智能体还可以把彼此当作工具调用——甲智能体在推理中向乙智能体发问并拿到回答。这与共享块互补:块适合"沉淀共识",互调适合"现场咨询"。多数协作场景两者结合:结论进块,疑难互调。
问:共享块的更新会让所有挂载方立刻改变行为吗? 下一轮生效,且是"群体生效"——这正是它威力大的原因,也是它危险的原因。一次误更新会同时污染所有挂载方的认知,所以本节才坚持"写入权收窄加变更前整体验证"。共享是放大器:放大的既是正确的共识,也是错误的笔误。
问:智能体数量多了以后,共享块会乱吗? 会,如果照单全挂。挂载数量本身要克制:一个公共块的挂载方越多,写入协调成本越高。智能体群从几个长到几十个时,公共块的治理(谁写、什么格式、何时清)应该先于数量扩张就位——治理能力是扩容的前置条件,不是事后补丁。
本节要点回顾
- 问题本质:组织级事实被复制成多份私有认知,副本失同步是协作混乱的根源。
- 共享机制:独立创建公共块、多方挂载读写同一对象,副本同步问题在结构上消失。
- 策略配套:persona 写明"以公共块为准",机制与习惯缺一不可。
- 两种拓扑:星型适合围绕同一事实协同,管线适合流程接力,公共块是智能体间的通信介质。
- 治理三纪律:最小共享、写入权收窄、格式先行;共享块的变更是群体事件,须整体验证。
下一节直面进化失控的那一面:当记忆越积越多、新旧认知打架,治理手册如何让进化保持健康。