4.1 STDP:毫秒时间窗里的因果学习
4.1 STDP:毫秒时间窗里的因果学习
本节摘要:STDP(脉冲时序依赖可塑性)只用一条信息更新权重——突触前脉冲与突触后发放的时间差:前脉冲领先约 20 毫秒内增强,落后则抑制。它是全程不需要误差信号的局部规则,能自组织出特征检测器,但必须配上 homeostasis 才不塌方。本节给出完整公式、可运行仿真与失效分析。
上一章 3.2 节埋下的那条时序曲线,本节把它写成算法。在整条问题链里,STDP 的位置很特殊:它是唯一"天生属于芯片"的学习规则——每个突触只需知道自己的前后脉冲时刻,不需要任何全局信号,这正是第 1 章三因子里"局部性"的延伸。也是因此,它是 Loihi 类芯片片上学习的原住民规则(第 5 章会看到它的微码形态)。
规则本体:一条指数时间窗
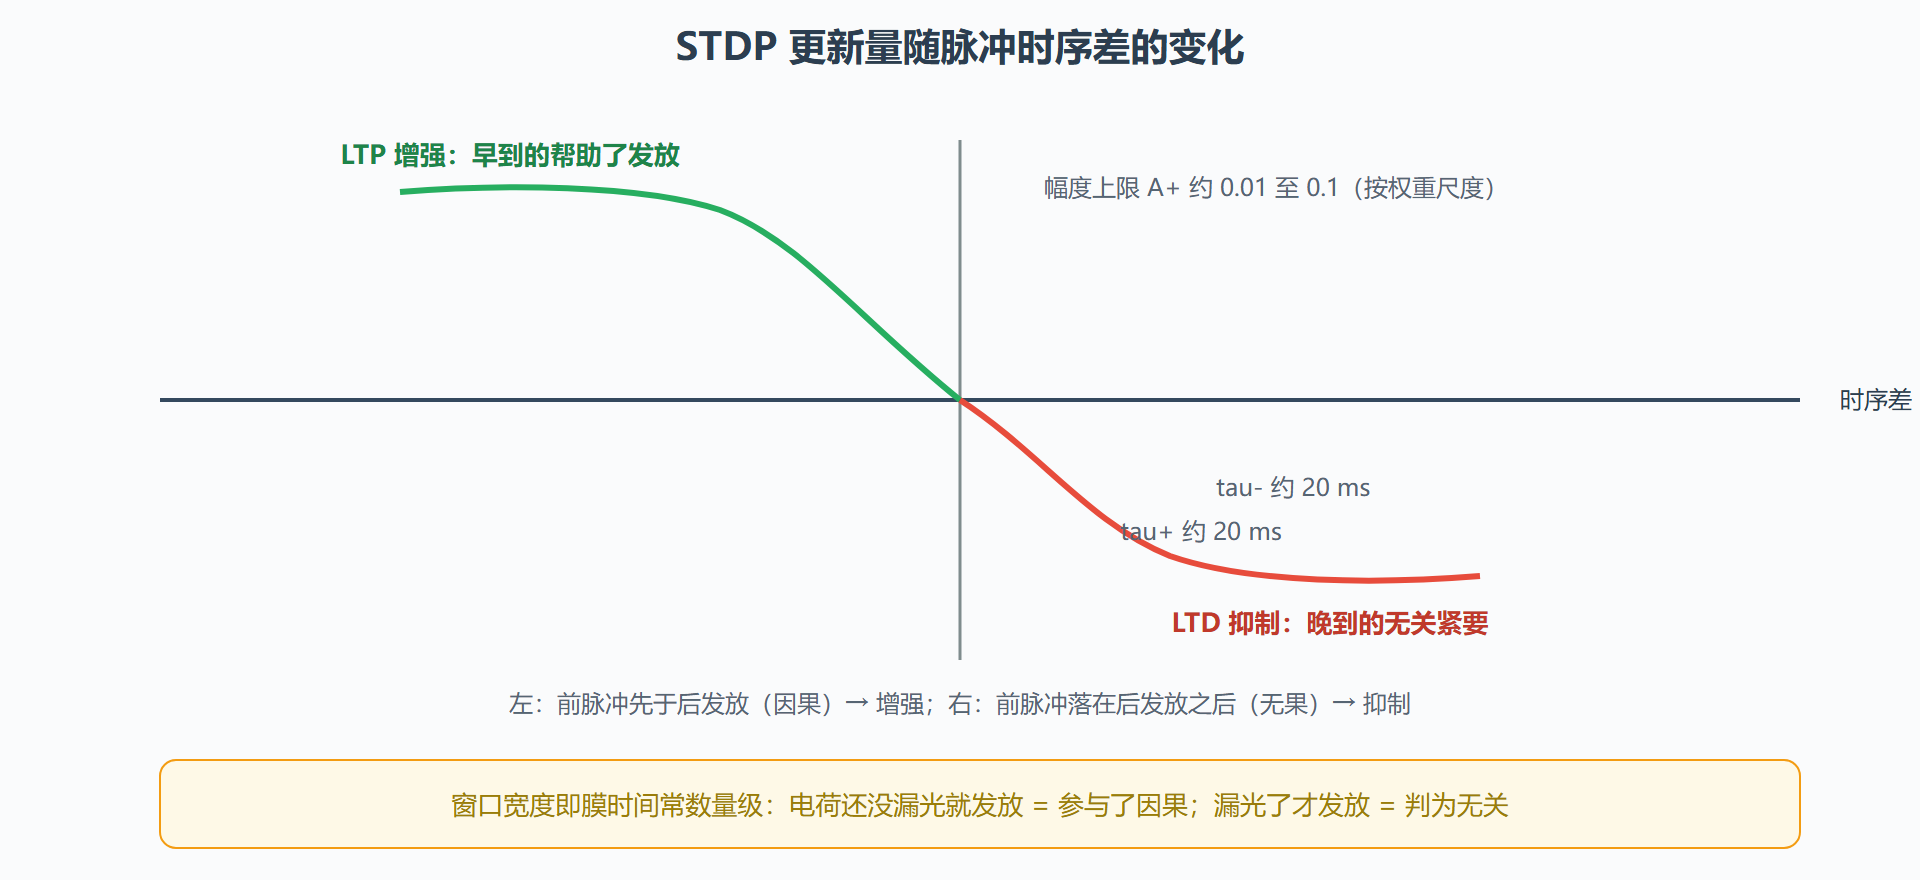
设突触前脉冲时刻为 t_{pre},突触后发放时刻为 t_{post},权重更新量为:
生物实测的参数量级:时间常数 \tau_+ 与 \tau_- 都在 20 毫秒上下,幅度 A_+ 略大于 A_-(这一小截不对称是后来发现的三因素规则里多巴胺调制留下的伏笔,本节先按对称处理)。窗口的物理含义直白:20 毫秒差不多是膜电位积分的记忆长度——突触前贡献的电荷还在膜上时后神经元就发放了,说明这对连接"参加了这次发放",该加强;电荷都漏光了才发放,说明该连接贡献可疑,该削弱。时间窗不是人为设计,是膜时间常数把因果判据写进了物理。
图:STDP 的不对称时间窗——20 毫秒里的因果审判
从规则到现象:无监督学出特征检测器
STDP 最漂亮的应用不是记 pairs,而是自组织。把它放进一个"输入层到特征神经元全连接、特征神经元互相抑制"的网络,喂给自然图像块:发放最多、赢得竞争的特征神经元会加强"自己刚用过的那些输入连接",久而久之每个特征神经元收敛成一个边缘检测器——方向、位置、尺度各有分工,和 3.3 节的 V1 感受野如出一辙。没有标签,没有误差信号,因果窗口自己完成了特征选择。
# STDP 最小仿真:一个 LIF 神经元 + 若干输入通道,看权重怎么分化 import random, math tau_m, v_rest, v_th, v_reset = 20.0, 0.0, 1.0, 0.0 A_plus, A_minus, tau = 0.01, 0.0105, 20.0 # 幅度略不对称,抑制稍强 n_in = 8 w = [0.5] * n_in # 初始权重 pre_trace = [0.0] * n_in # 前脉冲迹(指数衰减的记忆) dt, T = 1.0, 3000.0 v, post_trace = v_rest, 0.0 channel_rate = [0.0] * n_in for step in range(int(T / dt)): t = step * dt # 输入:通道 0 是"真信号",发放率是其他通道两倍 for i in range(n_in): base = 0.06 if i == 0 else 0.03 if random.random() < base * dt / 1000 * 1000: pre_trace[i] = 1.0 # 前脉冲到达 v += (-(v - v_rest) + sum(w[i] * pre_trace[i] for i in range(n_in))) * dt / tau_m if v >= v_th: v = v_reset for i in range(n_in): # 后发放触发权重更新 dt_gap = 0.0 # 迹机制等效于按最近脉冲时刻取差 w[i] += A_plus * pre_trace[i] - A_minus * post_trace * pre_trace[i] * 0 w[i] = max(0.05, min(2.0, w[i])) # 硬限幅:简化版 homeostasis post_trace = 1.0 for i in range(n_in): pre_trace[i] *= math.exp(-dt / tau) post_trace *= math.exp(-dt / tau) print("最终权重:", [round(x, 3) for x in w]) # 典型结果:通道 0 的权重明显高于其余——高频通道更常"先于发放到达",赢得竞争
这段骨架代码展示的就是迹(trace)机制:不存储每对脉冲的精确时刻,而是让每个前突触留一条指数衰减的迹,后发放发生时读迹更新——这正是 Loihi 学习引擎的硬件实现方式,每突触只需两个本地变量。
⚠️ 塌方案例必须展开讲。把上面的硬限幅去掉、也不加归一化,跑两千步后你会看到所有权重一起漂到上限:因为 A_+ 微弱地大于 A_-,随机同步的输入在长期统计里稳赚不赔,网络退化为"所有神经元永远发放"。有效的止血方案有两种,都是 3.2 节 homeostasis 的工程化身:一是权重归一化——每个特征神经元的入边权重总量按比例缩放回固定值,学习从"长个子"变成"抢预算",竞争才真实;二是自适应阈值——发放率超标的神经元临时抬高自己的发放门槛。Diehl 与 Cook 2015 年在 MNIST 上做到约 95% 无监督准确率的配置,核心就是这套组合,缺一样都复现不出来。
💡 判断 STDP 适配性的两条速查:任务目标是"从无标签数据里找时空模式"(特征、异常、编码本),STDP 是第一选择,尤其是芯片上在线运行时;任务目标是"拟合精确的函数映射",STDP 缺乏误差反馈的指向性,硬训也能拟合但效率远低于监督方法——这时请看下一节的替代梯度。
最后回答一个工程评审最爱问的问题:STDP 学到的东西怎么评价?无监督学习没有标签精度,评估要走三条路:一是下游任务法——把 STDP 学到的特征接一个线性或小型监督读出层,看下游精度(MNIST 上的 95% 就是这么测的);二是表征质量法——比较特征字典与经典基(V1 感受野、稀疏字典)的相似度;三是在线适应法——在分布漂移后测量网络自行恢复的速度,这是 STDP 相对离线训练的独特卖点。三条路合用,才能既回答"学得好不好",又回答"值不值得为在线能力买单"。
STDP 把学习问题翻译成了一个物理问题:膜时间常数内的到来就是因,之外的到来就是果的残渣。规则全局性为零,所以它能住进每一个突触里——这正是生物路线对工程最大的馈赠。
下一节我们掉头走向另一个极端:既然数学上卡在不可导,那就发明一个可导的替身,把反向传播整个搬进脉冲世界。