4.2 替代梯度:让不可导的脉冲可训练
4.2 替代梯度:让不可导的脉冲可训练
本节摘要:替代梯度(surrogate gradient)用一处"作弊"解锁了 SNN 的监督训练:前向传播用真实的阈值发放,反向传播用一个平滑函数代替阈值的导数。配合时间维度的 BPTT,SNN 在静态与事件数据集上的精度追平了同规模 ANN。本节讲清这不对称为什么合法、梯度函数怎么选、训练的显存代价怎么控。
STDP 的局部性令人赞叹,但要逼近深度学习的精度,监督信号绕不开。4.1 提到 SNN 直接监督训练的拦路虎是阈值的零梯度,本节正面解决它。这条路线目前的地位需要先说清:2019 年前后 Neftci 等人的综述把它定形,此后图像、语音、事件视觉的主要精度纪录几乎都由它创造——它是今天"想要 SNN 精度"的默认答案,也是下一章任何芯片部署工作流的上游。
问题的数学形状:断点在阈值处
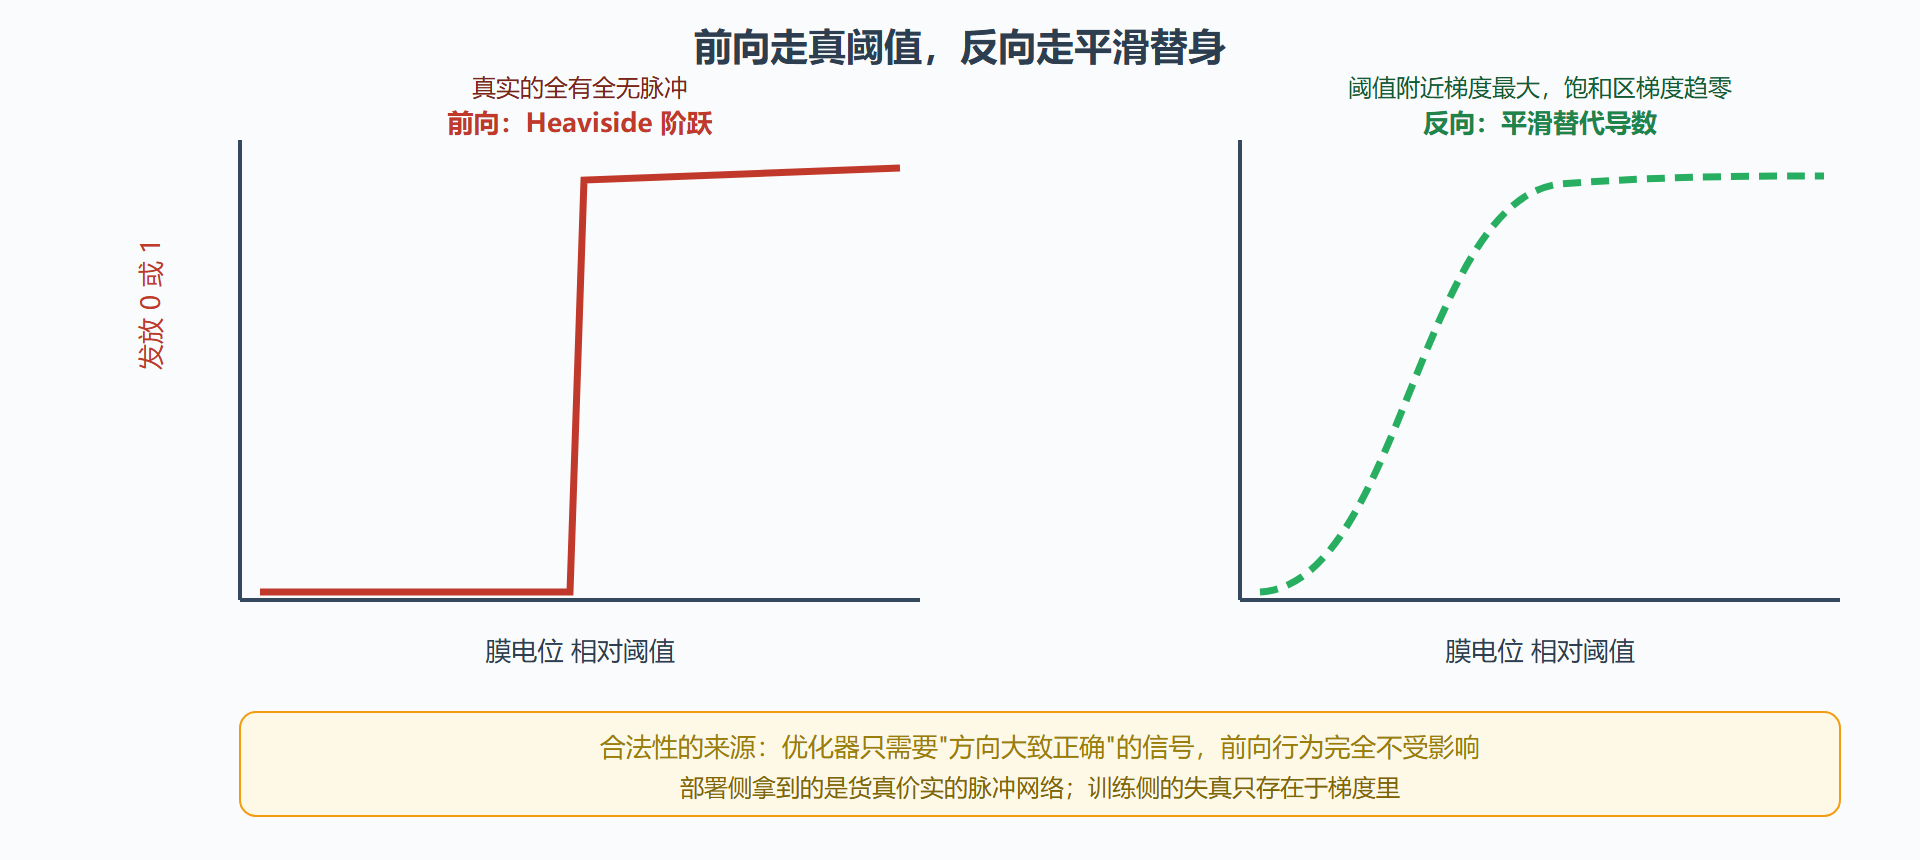
LIF 神经元的发放可以写成 S[t] = \Theta(U[t] - V_{th}),\Theta 是 Heaviside 阶跃函数:膜电位越过阈值输出 1,否则输出 0。它的导数除一个测度为零的点外处处为零——而链式法则需要的恰恰是导数。两条路都试过:把发放当随机过程(对发放率求梯度),信号估计方差大到训不动深层;把网络建成发放率的确定函数,又丢掉了时间维度,等于回到 ANN。
替代梯度的想法干脆利落:前向照旧用阶跃(脉冲保持全有全无,硬件友好性一点不丢),反向时假装 \Theta 是某个平滑函数 \sigma,比如快速 sigmoid 或者反正切:
膜电位恰在阈值附近时梯度大(发放与否对膜电位变化敏感),远离阈值时梯度小(多刺激一点也改变不了决定)——这个形状和真实情况的直觉一致,所以它不是乱凑,是一个"有物理品味"的近似。
为什么"作弊"合法
有人会问:反向梯度明明是假的,训练凭什么收敛?答案要从梯度下降的本质找:训练只需要每一步给权重一个"大致指向误差下降方向"的信号,不需要精确梯度。深度学习本身满是这类近似——ReLU 在零点也没梯度,Dropout 扰动了前向,都无碍收敛。替代梯度引入的是一种系统性的"梯度侧失真":它在阈值附近高估、在饱和区低估敏感度,但极性(正负号)大体正确。对优化器来说,够用了。经验上,训练后网络的实际发放行为与前向定义完全一致,部署侧没有任何"作弊残留"。
代价在训练侧。脉冲网络沿时间展开,BPTT 要把每个时间步的膜电位、突触迹都存下来算梯度:时间步 T、隐层 N 的显存占用正比于 T×N,比同规模 ANN 高一个量级。实用对策有三:截断 BPTT(只回传最近 20 至 50 步)、用 2 至 5 个时间步的极短窗配合高发放率(静态图像任务已验证够用)、以及梯度检查点换算力。还有一个工程要害:膜电位要加可学习的下界或用 soft reset——硬复位会让某些神经元的膜电位长期卡在死区,梯度彻底断流,这是新手训练 SNN 最常见的翻车点。
# PyTorch 口味的替代梯度最小骨架:一个可训练的 LIF 层 import torch, torch.nn as nn class SpikeFn(torch.autograd.Function): @staticmethod def forward(ctx, u, thresh, alpha): ctx.save_for_backward(u - thresh) # 保存膜电位与阈值之差 ctx.alpha = alpha return (u >= thresh).float() # 前向:硬阈值,真实的脉冲 @staticmethod def backward(ctx, grad_out): (x,) = ctx.saved_tensors return grad_out / (1 + ctx.alpha * x.abs()).pow(2) * 1.0, None, None # 反向:快速 sigmoid 的导数——替代梯度就藏在这一行 class LIFLayer(nn.Module): def __init__(self, n_in, n_out, tau=20.0, thresh=1.0): super().__init__() self.w = nn.Linear(n_in, n_out) self.tau, self.thresh, self.alpha = tau, thresh, 2.0 def forward(self, x_seq): # x_seq: 时间 x 批 x 通道 v = torch.zeros(x_seq.shape[1], self.w.out_features) spikes_all = [] for step in x_seq: # 沿时间步循环:BPTT 的开销所在 v = v * (1 - 1.0 / self.tau) + self.w(step) s = SpikeFn.apply(v, self.thresh, self.alpha) v = v * (1 - s.float()) # soft reset:防死区的关键 spikes_all.append(s) return torch.stack(spikes_all) # 训练循环与普通网络无异:loss 反传时 SpikeFn.backward 提供替代梯度
这个骨架可以直接加一层输出、接交叉熵去训 MNIST:几个时间步、全连接两层,CPU 几分钟能到 97% 以上量级;换成卷积结构与标准超参,社区复现的精度普遍在 99% 上下,与同规模 ANN 相当。
与 STDP 不是替代关系
本节开头说过 4.2 与 4.1 是谈判的两个极端,收尾时把两者的分工说透。STDP 训练发生在目标硬件上、学习是运行时行为(部署即学习);替代梯度训练发生在 GPU 集群上、学习是出厂行为(部署只推理)。能耗账要算总账:GPU 训练一次的能耗可能抵得上芯片推理数月,但摊到每个部署端点后,依然远低于"每台设备各自在线学习"的方案。所以真实系统的常见形态是混合:特征层用替代梯度离线训好,输出层或适应层留 STDP 片上微调——第 7 章的机器人案例用的正是这个套路。
图:替代梯度与前向-反向不对称示意
💡 实操参数速查:替代函数的陡峭系数 alpha 从 1 到 5 起步,训练不稳先调它;时间步 5 步配静态图像、20 步配语音或事件流、50 步封顶;学习率比同规模 ANN 小一半左右通常更稳;输出层建议直接累积膜电位读数而不是脉冲计数,收敛更快。
替代梯度没有消灭不可导,只是给优化器递了一副有度数但没配准的眼镜——世界照样看得分清方向。SNN 监督训练的可用性,就是从这副眼镜开始的。
下一节补完地图的最后两块:手里已有训练好的 ANN 怎么办,以及想在线学习又嫌反向传播太重怎么办。