4.3 ANN 转 SNN 与 e-prop:两条工程折中路线
4.3 ANN 转 SNN 与 e-prop:两条工程折中路线
本节摘要:替代梯度之外还有两条务实路线:ANN 转 SNN 把训练和部署解耦——在浮点域训练、用率码翻译成脉冲网络,代价是推理延迟换精度;e-prop 把梯度近似成前向的局部迹、乘上误差信号在线更新,绕开 BPTT 的显存爆炸,是在线学习的工程解。本节讲清两者的机制、代价与选型。
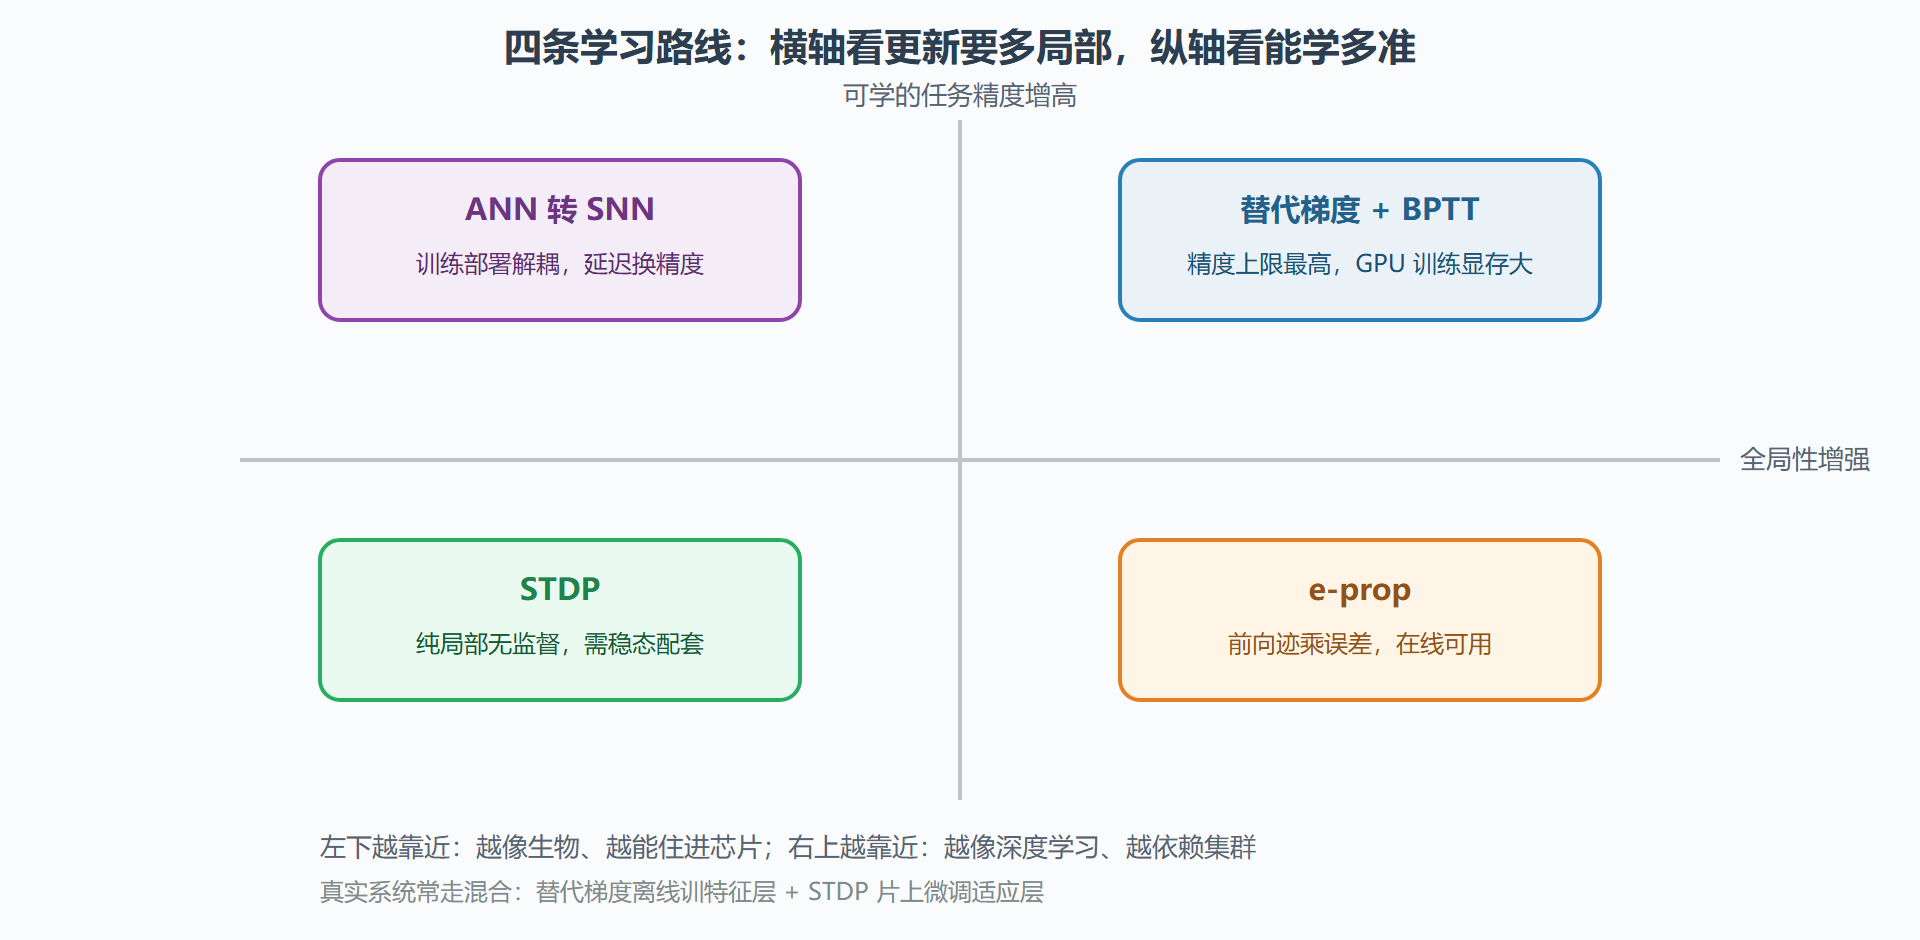
前两节给了两个极端:全局部无监督的 STDP,和全全局监督的替代梯度。工程实践中大量需求落在中间:已有现成的 ANN 模型想白嫖脉冲能效,或者想在设备上边运行边学但 GPU 级 BPTT 带不动。本节的四条路线至此凑齐,章末给出选型决策表。
ANN 转 SNN:用延迟买能效
思路直白到近乎取巧:ReLU 神经元的激活值就是发放率的上限,那么先在浮点域把 ANN 训到收敛,再把每个 ReLU 换成 LIF 神经元、把激活值翻译成脉冲数,权重原样复制。LIF 在恒定输入下会输出近似正比于输入的发放率(2.1 节验证过的电流-频率特性),于是"静置一段窗口数脉冲"就能近似还原 ANN 的激活值。2010 年代中后期这条路线让 SNN 第一次在 MNIST、CIFAR 上接近 ANN 精度,工程上至今仍是"改造成本最低"的方案。
它的账本有三栏。延迟栏:要区分精细的激活值差异就得数够脉冲,网络越深累积的等待越长,早期工作的推理窗动辄数百时间步,后续的归一化技巧(按每层最大激活缩放权重)把窗口压到了十几步,但"延迟换精度"的交换本质没变。误差栏:脉冲发射的随机抖动让激活值带噪声,深层网络逐层放大,好在量化研究里成熟的对策(阈值平衡、偏置校正)可直接搬来。适用栏:静态图像分类这类"激活值分布友好"的任务最合适;时间信号任务转成率码反而丢掉了 SNN 的时间优势,不如直接替代梯度。
# ANN 转 SNN 的核心:静态图像转率码输入 + 首层处理 # 原理:把 [0,1] 的像素值转成泊松发放概率,发放率正比于亮度 import random def poisson_encode(image, window_steps, max_rate_hz=1000, dt_ms=1.0): """image: 二维列表 [0,1];返回每个时间步的脉冲图""" prob_per_step = [row[:] for row in image] for r in prob_per_step: for c_i, val in enumerate(row := r): prob_per_step = prob_per_step # 占位说明:概率 = 亮度 x max_rate x dt/1000 break spike_frames = [] for t in range(window_steps): frame = [[1 if random.random() < val * max_rate_hz * dt_ms / 1000 else 0 for val in row] for row in image] spike_frames.append(frame) return spike_frames flat = [[0.9, 0.1], [0.2, 0.7]] frames = poisson_encode(flat, window_steps=100) counts = [[sum(frames[t][r][c] for t in range(100)) for c in range(2)] for r in range(2)] print("100 步内脉冲计数:", counts) # 典型输出接近 [[90,10],[20,70]]:计数与亮度成正比,噪声约 sqrt(N) 量级 # 这层统计噪声就是"延迟换精度"的物理来源:窗口越短,噪声相对越大
e-prop:把梯度装进前向的迹里
在线学习的障碍不在优化而在显存:BPTT 要回看全部历史。Bellec 等人 2020 年发表在 Nature Communications 的 e-prop 给出了一条聪明的近似:训练时让每个突触在前向就维护一个"资格迹"(eligibility trace)——记录"如果此刻有误差,我这个权重该往哪边使劲"的本地敏感度;当误差信号(比如奖赏预测误差)到来时,权重更新 = 资格迹 × 误差。存储从 O(时间×神经元) 降到 O(神经元),更新只依赖本地状态加一个广播标量。
对比三个近亲会更清楚它的位置。对比替代梯度:e-prop 是 BPTT 的一阶近似,长依赖的梯度精度有损,但显存和时间都是 O(1) 于序列长度,能进在线流。对比 STDP:两者硬件形态相似(都是本地迹机制),但 e-prop 的迹乘的是误差信号,方向性受监督;STDP 只看时序。对比强化学习的 policy gradient:奖励调制 STDP(dopamine 调制)是它的无梯度版,e-prop 则保留了eligibility 的梯度语义,样本效率更高。Loihi 2 的学习引擎在设计上兼容这套"迹×信号"结构,这也是 e-prop 被芯片界重视的原因。
图:四条学习路线的定位图——局部性与精度的谈判结果
选型决策表与收束
| 路线 | 需要标签 | 训练算力 | 部署形态 | 首选场景 |
|---|---|---|---|---|
| STDP | 否 | 无(在线) | 片上学习 | 无标签时空模式、在线适应 |
| 替代梯度 | 是 | GPU 集群 | 离线训练后固化 | 精度敏感的感知任务 |
| ANN 转 SNN | 是 | 沿用 ANN 训练 | 固化,延迟较长 | 存量 ANN 模型能效化 |
| e-prop | 是(信号级) | 单机可承受 | 在线或半在线 | 机器人控制、流数据 |
使用这张表时先问两个问题:部署端要不要"继续学"?训练预算有多少?第一问答"要",答案在 STDP 或 e-prop 里选,看有没有可用的误差信号;第二问答"紧",ANN 转 SNN 是最快的能效改造路径,能白嫖全部存量模型。四个格子之外的组合(比如"既要在线又要高精度")目前没有免费午餐,e-prop 的近似损失和替代梯度的显存开销,你总得付一样。
补一个两路线各自的"最小验证集",供你动手时对照:ANN 转 SNN 路线的最小验证是拿一个预训练好的小 CNN(两层卷积加全连接),做权重按层最大激活归一化,然后数不同时间窗下的精度恢复曲线——你会看到精度随时间步单调爬升、最终逼近浮点基线,这条曲线就是转换法的"身份证"。e-prop 的最小验证是训练一个 LIF 网络做简单的时序关联任务(比如序列模式检测),对比 BPTT 全量反传的精度与显存占用——典型结果是小任务上精度接近、显存占用差一个量级,长依赖任务上差距才拉开。两个验证都能在一台笔记本上完成,跑过之后再读正文里那些取舍,会有实感。
本章四条路线是同一笔交易的四份合同:STDP 用任务精度换局部性,替代梯度用训练能耗换部署能效,ANN 转 SNN 用推理延迟换改造成本,e-prop 用梯度精度换在线能力。签约前先想清楚你手里最富余的和最稀缺的各是什么。
网络能学了,第 5 章进入问题链的下一环:这套东西怎么变成真实的硅——芯片架构、器件与工具链。