7.4 怎么评估一个 SNN:基准指标与功耗实测
7.4 怎么评估一个 SNN:基准指标与功耗实测
本节摘要:SNN 评估的最大陷阱是口径错配:精度和 ANN 可比,延迟、功耗、稀疏度的统计边界却各说各话。本节给出四维评估体系(精度、延迟、功耗、稀疏度),逐维列出标准口径、常用数据集和常见注水手法,最后合成一张审查清单。
前三节看了很多数字,本节教你审视数字。这一节的位置在全书几乎最靠后,但它可能是你最先用上的——第一次向领导汇报 SNN 选型、第一次审一篇投稿、第一次比对两颗芯片,你需要的都是本节这套清单。
维度一:精度——口径对齐才有可比性
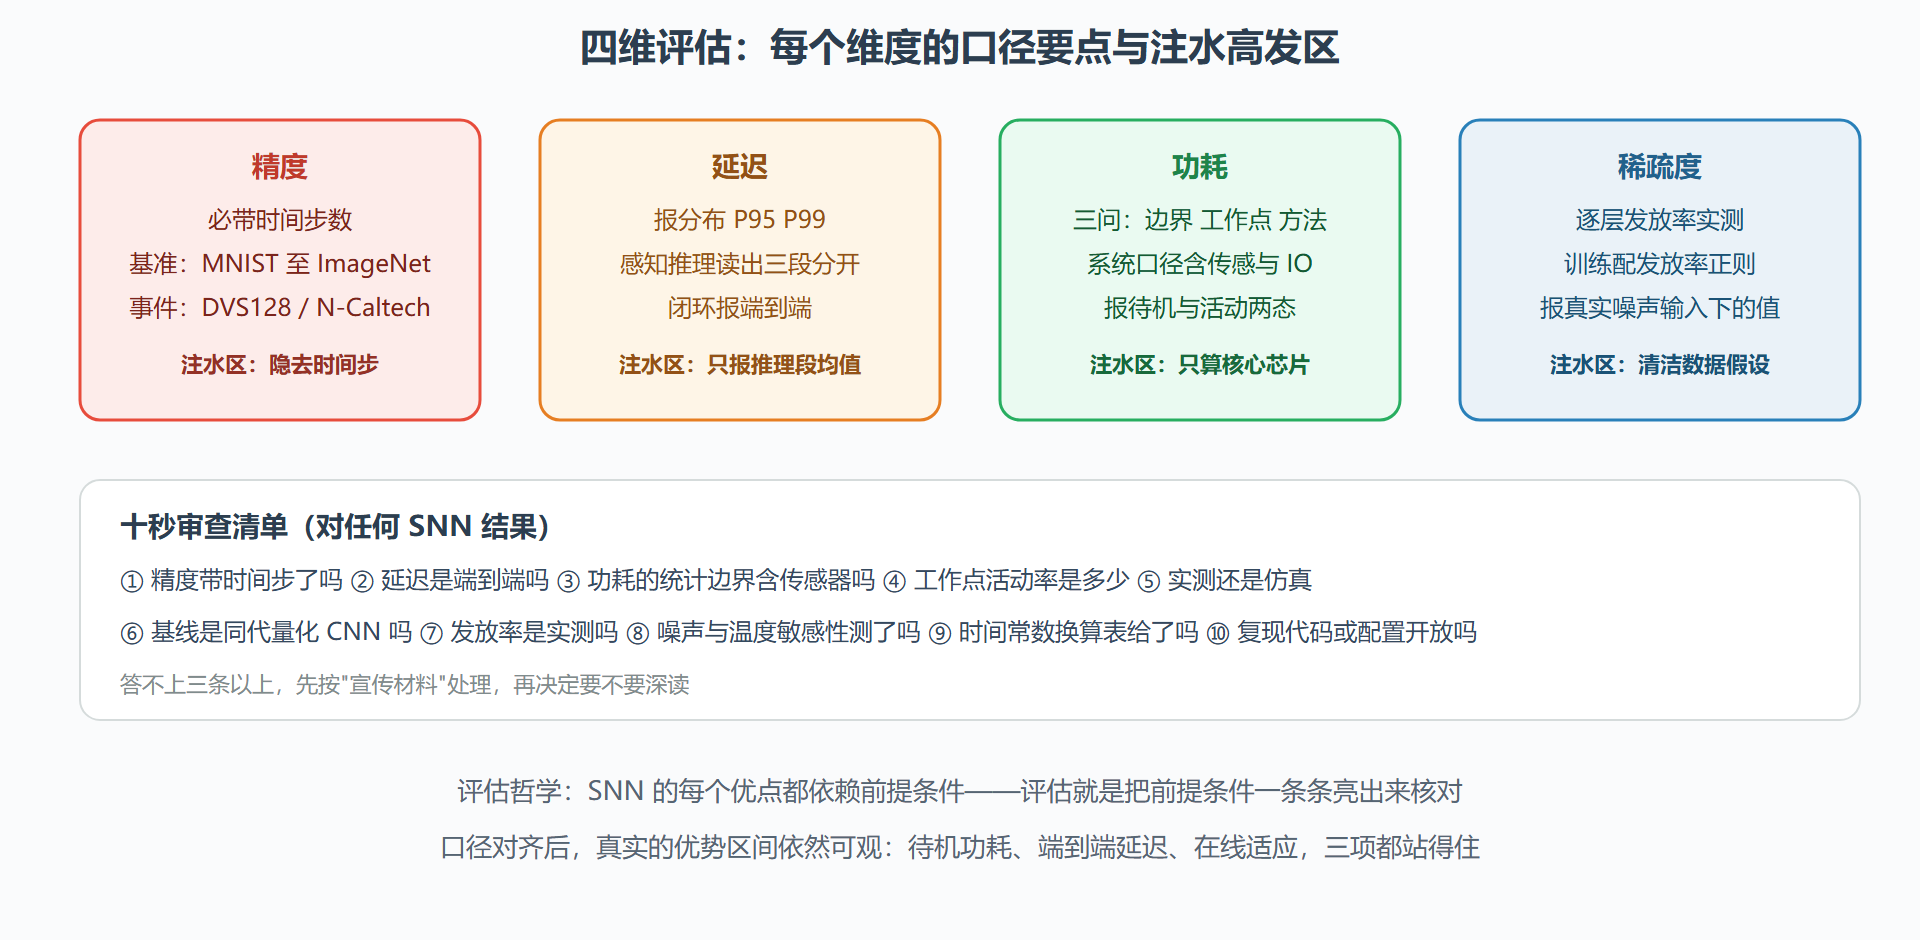
精度评估与深度学习同构(Top-1/Top-5、事件数据的准确率),常用基准:静态图像 MNIST、CIFAR10/100、ImageNet;事件流数据 DVS128 Gesture(手势,12 类)、N-MNIST、N-Caltech101、DSEC(驾驶场景)。两点口径须知:第一,SNN 的精度依赖时间步数,报精度必须带时间步——"CIFAR10 上 97%"和"97% 用了 50 时间步"是两句话,前者单独出现基本可以判定为隐瞒;第二,转换法(4.3)的结果要报延迟换算,替代梯度法要报时间步,两者精度相近时延迟可能差数倍。
维度二:延迟——绝对值和分位数都要
SNN 的延迟有三层:感知延迟(事件相机微秒级,帧相机一个帧周期)、推理延迟(网络展开的时间步数乘时间步长)、读出延迟(TTFS 可提前终止,率码要等满窗)。审查要点:闭环系统报的是端到端还是只有推理段?7.2 节的四旋翼案例里,感知段差异(33 毫秒对 1.5 毫秒)比推理段还大——只报推理延迟的对比是残缺的。规范做法是报分布(中位数与 P95/P99),因为事件系统的延迟随场景活动率波动,单点均值掩盖尾延迟。
维度三:功耗——统计边界是生死线
功耗注水是本领域重灾区,四种手法要认识。手法一,只算芯片不算系统:传感器、ADC、时钟、存储在系统功耗里占大头,只报芯片核心数字能"省"出数倍。手法二,只算活动功耗不算待机:神经形态方案的优势场景恰恰在待机(静默近零),把待机排除后反而抹平了优势——手法二比手法一少见但更隐蔽。手法三,斜率对比:拿本方案的甜区峰值效率对基线的平均功耗。手法四,仿真能耗当实测:门级仿真或解析模型的数字(pJ 每突触事件)直接和整板实测并排放。审查口诀:问全三样——统计边界(什么算进去了)、工作点(活动率多少)、测量方法(实测还是模型)。
# 一张标准化的功耗对账表:把两份宣传数字翻译回可比口径 def normalize_power_claim(chip_pj_per_op, ops_per_s, include_sensor_mw=0, include_io_mw=0, duty_cycle=1.0, label=""): core_mw = chip_pj_per_op * ops_per_s / 1e9 # pJ x ops/s = nW,换 mW total_mw = (core_mw + include_sensor_mw + include_io_mw) * duty_cycle print(f"{label}: 核心估算 {core_mw:.2f} mW, 系统口径 {total_mw:.2f} mW") return total_mw # 场景:静态为主的监控,工作占空比 5% normalize_power_claim(26, 50e6, 0.8, 0.5, 0.05, "芯片A 宣传口径") # 只给了核心 normalize_power_claim(8, 20e6, 2.0, 1.0, 0.05, "芯片B 系统口径") # 同一场景下,只看"每运算皮焦"会得出 A 更优; # 补全传感器与 IO 后 B 反而更低——口径不同,结论翻转
维度四:稀疏度——能效声明的前提变量
SNN 的能效正比于脉冲稀疏度(1.3 节三因子),所以任何能效数字都隐含一个活动率假设。审查要点:每层发放率是多少(健康范围随层而异,输入层由编码方式决定,隐层常见在百分之几量级)?发放率是实测还是假设?有没有发放率正则化(训练时约束发放数,否则推理时发放率可能漂到很高)?一个常见的隐蔽问题:在清洁数据集上校准的发放率,到了含噪的真实输入上翻倍以上——能效声明跟着翻车。
图:SNN 四维评估雷达与注水高发区
把清单用回全册
用这套清单回看前文的所有数字:TrueNorth 的 26 皮焦耳(含路由与突触的系统级芯片内口径,工艺 28 纳米)、Hala Point 的 8 皮焦耳(系统级均摊)、事件相机的毫瓦级(含像素阵列的实测口径)——各自边界不同,直接横比会出错,放进同一张对账表才能比。这也是本章真正的交付物:不是告诉你哪个数字最大,而是给你一张能自己填的对账表。第 8 章讨论冷启动路线图时,"先做对账再选平台"会作为第一条原则出现。
再给一个"自评"的最小实验设计,你可以在自己的项目里直接执行:选三个工作点做三角测量。工作点一是最差情况(最高活动率输入),验证延迟与功耗的上界不破预算;工作点二是典型情况(目标场景的平均活动率),这是产品规格书的基准点;工作点三是待机情况(近零活动),验证常开功耗的承诺。三点各跑十分钟、各记录四维数据,一张 A4 纸就能装下——但它足以回答"这个系统在真实负载下的行为画像"。多数失败的评估不是因为测得太少,而是因为只测了最好看的那一点。
组织层面补一句:评估数字要"带日期带版本"。SNN 系统的每一个数字都绑定特定的阈值标定、模型版本、传感器批次与固件版本——同一系统三个月后的复测数字不同是常态而非异常。把"数字的元数据"(版本、环境、标定日期)与数字本身一起记录,评估才具有工程意义上的可追溯性,这也是后面第 8 章三阶段路线图里交付物的一部分。
基准数据的最后一个使用要点:区分"模型级"与"系统级"的排行。学术榜单上的精度对比基本是模型级的(网络结构加训练配方),而你的产品决策需要的是系统级的(传感器加网络加芯片加功耗预算),两者的冠军经常不是同一家——模型级最优的网络可能映射损耗惨重,系统级最优的方案可能精度只排中游。务实的做法是建立自己的"系统级小榜单":固定你的传感器与目标硬件,把候选网络各跑一遍四维清单,用加权得分排序。这个榜单的准确度远高于任何公开排行,因为它的每一行都是你自己的工作点。
评估的本质是前提条件的核对:SNN 的每一项优势都挂在条件上——活动率、时间步、统计边界。清单不是怀疑一切,是把信任建立在可核对的地方。
下一章是全册的落点:如果你想真刀真枪进场,三个月、六个月、十八个月分别该做什么,哪些坑已经有人替你踩过。