1.1 词法分析:把字符流切成记号
1.1 词法分析:把字符流切成记号
本节摘要:词法分析(Lexical Analysis,也叫扫描 Scanning)把源代码的原始字符流切分成有意义的记号(Token),是编译器的第一道工序。本节讲清三件事:为什么不能直接拿字符串去解析、扫描器如何用有限状态自动机的思路逐字符识别记号、以及手写扫描器时最常踩的三个坑(最长匹配、关键字与标识符的区分、注释与空白处理)。它是后续一切分析的地基——语法树是建在记号流上的,不是建在字符流上的。
本节是全册的起点:语法分析(下一节)消费的输入不是字符而是记号,所以必须先把"切记号"这件事讲透。理解了本节,你会发现词法分析几乎是编译器里唯一可以完全"机械化"理解的环节。
一、为什么不直接解析字符串
假设要判断 x10 >= y 是不是一条合法的赋值或比较语句。如果直接在字符上做语法分析,每条文法规则都要先处理"标识符由哪些字符组成""数字到哪一位结束"这类琐碎问题,核心的语法结构反而被淹没。更麻烦的是 x10 到底是标识符 x10 还是标识符 x 后跟数字 10?这类"切分"问题如果在每条规则里都判断一次,解析器会重复劳动到无法维护。
词法分析把这一切一次解决:读入字符流,按规则切出一段段"已经确认无法再切分"的单元,每个单元附带类别。x10 被整体判定为一个 IDENT(标识符),后续语法分析拿到的是现成结论,不用再关心字符细节。切的单位叫记号,通常用"类别 + 值"二元组表示:
输入: int main() { return 42; } 输出记号流: KEYWORD(int) IDENT(main) LPAREN RPAREN LBRACE KEYWORD(return) NUMBER(42) SEMICOLON RBRACE
记号的类别集合是编译器前端的"词汇表",常见的有:关键字(KEYWORD)、标识符(IDENT)、整型/浮点字面量(NUMBER)、字符串字面量(STRING)、运算符(OP)、标点(LPAREN、SEMICOLON 等),以及一个特殊成员——EOF,用来告诉语法分析"后面没有了"。
二、扫描器核心:边前进边猜
识别记号的算法骨架出奇地简单:从当前位置开始,能多吞一个字符就多吞一个,直到再吞就"出格"为止,然后把最后确认合法的位置作为记号终点。这就是最长匹配原则。看一个手写扫描器的核心循环(C 风格伪码,可直译成任何语言):
Token next_token() { skip_space_and_comments(); // 空白与注释不产生记号 if (is_eof()) return mk(EOF, ""); int c = peek(); // 看但不吃 if (is_alpha(c) || c == '_') return read_word(); // 标识符或关键字 if (is_digit(c)) return read_number(); // 数字字面量 if (c == '"') return read_string(); // 字符串字面量 return read_op_or_punct(); // 运算符与标点 } Token read_word() { int start = pos; while (is_alnum(peek()) || peek() == '_') advance(); // 切完再查关键字表:先当标识符读,再一锤定音 char *text = slice(start, pos); if (keyword_lookup(text)) return mk(KEYWORD, text); return mk(IDENT, text); }
两个设计决策值得咀嚼。其一,read_word 先按标识符读完,再查关键字表——而不是为每个关键字写一条独立分支。这样 if0 会被正确识别为标识符(它读到底都不停),而不是 if 加一个 0。其二,read_number 遇到 123abc 这类输入不该无声吞掉,应当报错:数字后面紧贴字母在主流语言里都是非法字面量,扫描阶段就拒绝它比留给语法阶段干净。
三、为什么"正则就够":自动机视角
词法规则有一个共同的数学特征:识别它们只需要有限的状态和"看一个字符决定往哪走"的转移。标识符 = "字母或下划线开头,后面跟字母数字下划线";整数字面量 = "数字串,可带下划线分隔"。这类模式全部可以写成正则表达式,而每个正则都存在等价的有限状态自动机(DFA)。扫描器在运行时做的事,就是沿着自动机走:每吞一个字符转移一次状态,走进死路就回退到最后一个接受态。
图:识别标识符与整数的有限状态自动机
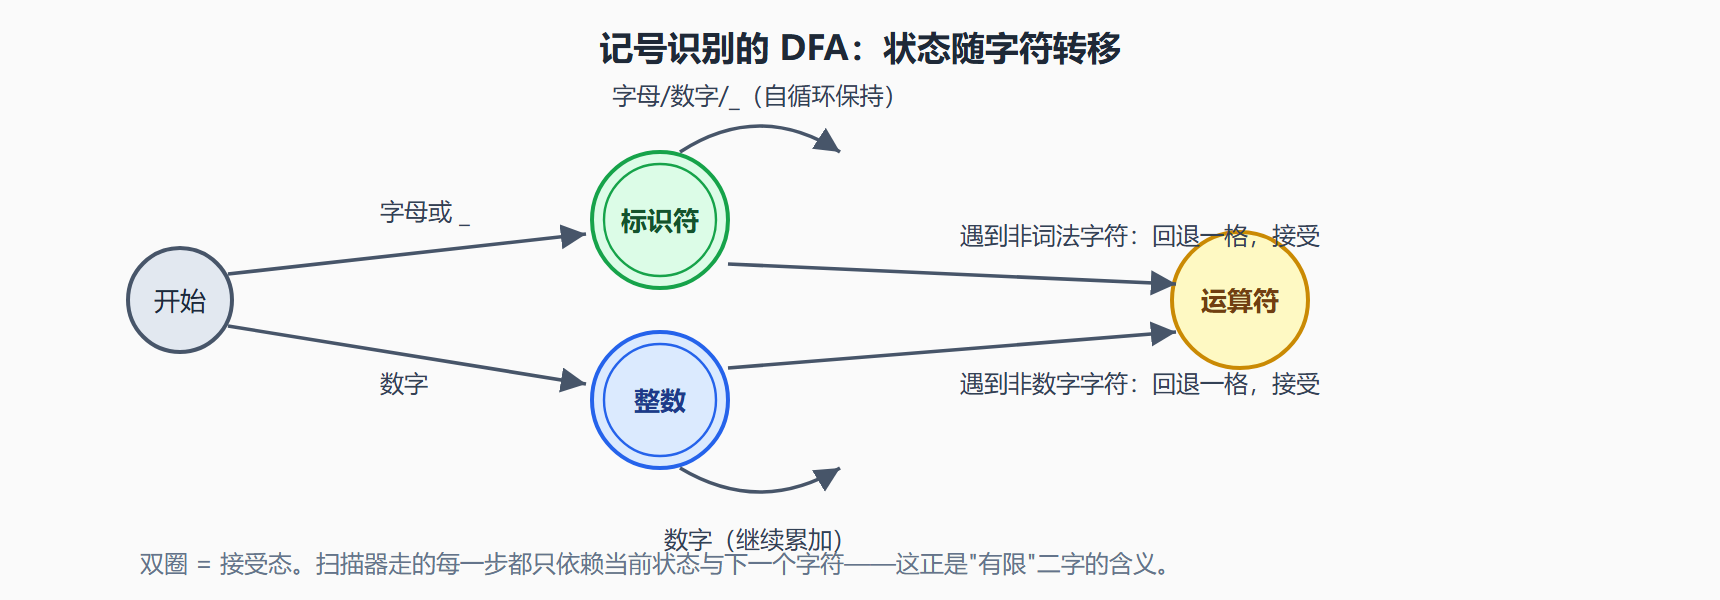
自动机视角解释了两个工程事实:第一,为什么手写扫描器几乎总是比"正则库 + 逐条尝试"快——手写版把所有规则的自动机合并成一次遍历;第二,为什么词法分析的时间复杂度严格线性——每个字符至多被看两遍(一次前进、一次回退),输入规模翻倍耗时翻倍。
四、工程实践中的坑
⚠️ 最长匹配与
>=:若扫描器见>就急着急"大于",>=会被切成GT和ASSIGN两个记号,if (a >= b)立刻变成语法错误。正确做法是在接受>后继续试探=。所有复合运算符(==、<<=、->)都是这条原则的受益者。
💡 关键字为什么不是语法问题:
if和x99的字符形态完全一样(都是"字母开头字母数字结尾"),区别纯粹是查表结果。把关键字的判定放在词法层一锤定音,语法文法就能干净地写stmt → if ( expr ) stmt,而不用在每条规则里排除"这个标识符恰好叫 if"。
注释处理是个隐蔽的深水区。块注释 /* ... */ 需要扫描器维护一个"在注释内"的隐式状态,嵌套与否(标准 C 不支持嵌套)直接影响状态机画法;行注释要正确处理文件末尾没有换行的情况。这些分支个个简单,但漏一个就是真实编译器里出现过的 bug。做练习时建议给自己的扫描器准备这几组考题:a/**/b(应切成两个标识符)、a//b(行注释吃到行尾)、"abc\"def"(转义引号不能终止字符串)。
本节要点回顾:
- 记号 = 类别 + 值:词法分析的产出是记号流,字符细节到此为止,不再向上渗透;
- 最长匹配:回退到最后一个接受态,保证
>=不被腰斩; - 关键字查表判定:与标识符共用一套识别逻辑,读完后一锤定音;
- 线性复杂度:DFA 保证每个字符至多看两遍,词法分析不构成编译瓶颈;
- 空白与注释不产记号,但处理它们的代码往往是扫描器里最容易出错的部分。
下一节把这些记号当成珍珠,讨论怎么串成树——语法分析登场。