1.2 语法分析:从记号流到语法树
1.2 语法分析:从记号流到语法树
本节摘要:语法分析(Parsing)把线性的记号流组织成树形结构——语法树(AST),让"谁和谁结合"显式地出现在结构里。本节用最常见的递归下降法手写一个四则运算解析器,展示运算符优先级如何被编码成函数调用层次,再给出语法树的样子与它在后续编译阶段的命运。语法分析是前端与语义分析的交界:树一旦建好,字符、记号这些"表面形式"的历史使命就完成了。
承接上一节:记号流解决了"程序由哪些原子单元组成",但 a + b * c 里加号两边到底是 a 和 b,还是 a 和 b * c?这个结合关系问题由语法分析回答。它也是本册知识链条上真正的起点——第3章把语法树拍平成三地址码时,靠的正是树所携带的结构信息。
从一段代码说起:优先级藏在函数层次里
考虑四则运算文法。直接把"表达式"写成一条规则 expr → expr + expr | expr * expr | 数字 会产生歧义:同一句话能推出两棵不同的树。经典解法是把优先级编码成文法层次——低优先级运算符在上层:
expr → term ( PLUS term )* // 加减层:最低优先级 term → factor ( STAR factor )* // 乘除层:更高优先级 factor → NUMBER | LPAREN expr RPAREN
把它直译成递归下降解析器,只有几十行:
// 每个非终结符对应一个函数;parse_X 的职责是: // 消耗若干记号,返回以 X 为根的子树 Ast *parse_expr() { Ast *node = parse_term(); while (match(PLUS) || match(MINUS)) { Token op = prev(); Ast *rhs = parse_term(); // 注意:右边是 term 不是 expr node = new_binary(op, node, rhs); } return node; } Ast *parse_term() { Ast *node = parse_factor(); while (match(STAR) || match(SLASH)) { Token op = prev(); Ast *rhs = parse_factor(); node = new_binary(op, node, rhs); } return node; } Ast *parse_factor() { if (match(NUMBER)) return new_num(prev()); if (match(LPAREN)) { Ast *e = parse_expr(); // 括号递归回顶层 expect(RPAREN); return e; } error("unexpected token"); }
优先级不再是一条条判别规则,而是调用层次本身:parse_expr 里乘法子树由 parse_term 整体返回,加号想左右逢源也插不进乘法的内部。左结合则由 while 循环实现——1 - 2 - 3 会逐步长成 (1-2)-3,而不是 1-(2-3)。
二、语法树长什么样
对 2 + 3 * 4,上述解析器建出的树是:
图:表达式 2 + 3 * 4 的语法树
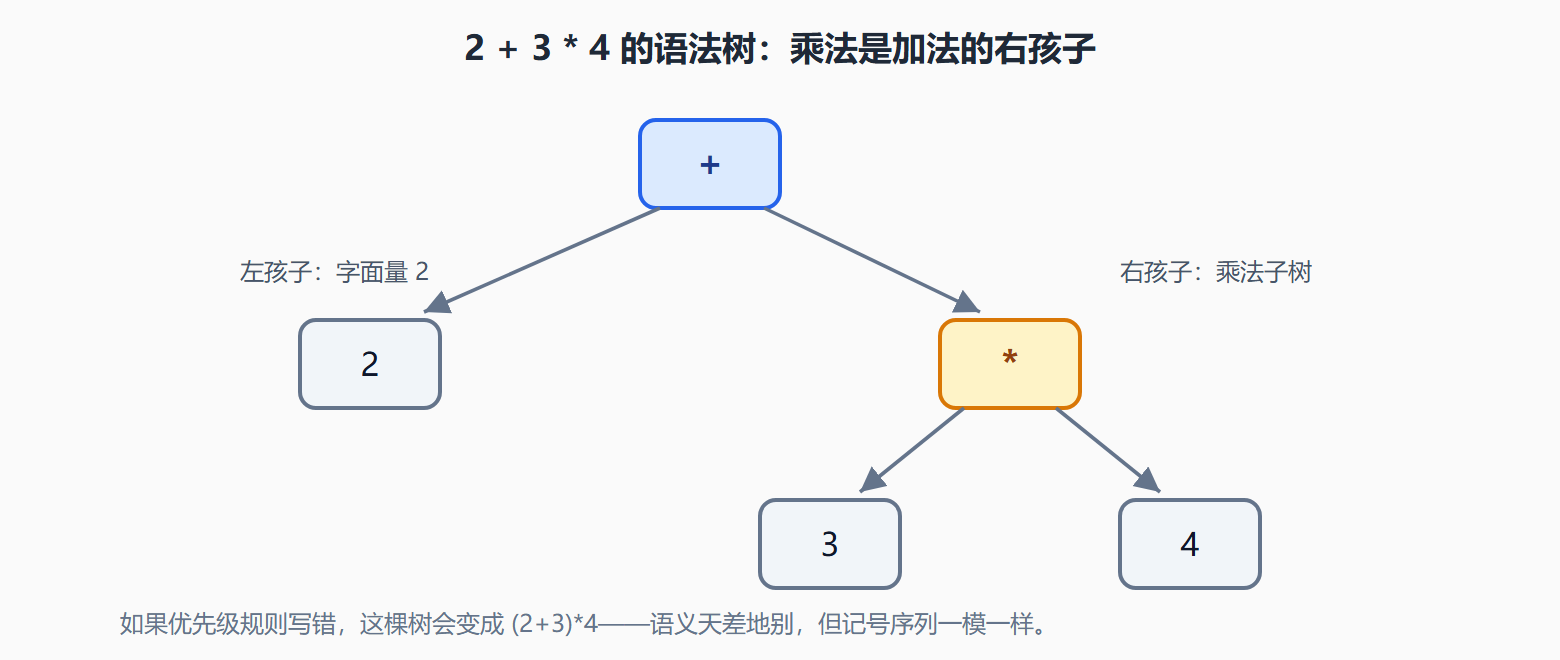
树的价值在于把"计算顺序"从约定变成了结构:想先算什么,看树就行。后序遍历这棵树(访问孩子再访问自己)恰好得到 2 3 4 * +——逆波兰表示,这正是下一章三地址码的雏形。语法树不是给读者看的装饰品,它是语义分析的工作对象:类型检查在树上自底向上推导每个节点的类型,符号表查询发生在每个标识符叶子上。
三、自上而下与自下而上:两大流派
递归下降属于自上而下(LL)一派:从根出发,"预测"下一个结构该是什么。它的对立面是自下而上(LR)一派:从记号出发,"归约"出更大的结构。工程上的分野大致如下:
| 维度 | 递归下降(LL) | 表驱动(LR/LALR) |
|---|---|---|
| 代码形态 | 手写函数,可读性高 | 生成器产出状态表 |
| 错误提示 | 精准,可在任意点定制 | 相对机械 |
| 文法限制 | 需消除左递归、提取左公因子 | 能吃下更大的文法类 |
| 代表 | Clang、Go、V8 的 JS 解析 | 旧版 GCC(Bison)、Rust 早期 |
💡 手写递归下降在今天的主流编译器里占上风,原因不在理论而在工程:错误恢复和语言演进(往文法里加一条规则)在手写代码里是局部修改,在生成器文法里则牵一发动全身。
分析过程中的一个通用概念值得记住:当前面对的记号叫向前看记号(lookahead)。LL(1) 表示只需一个向前看记号就能唯一确定走哪条产生式;不够用时就得多看几个(LL(k))或改用 LR。上一节的词法扫描器配合本节的解析器,前端"结构还原"的使命就完成了——但此刻程序里还有大量问题没有答案:x 是什么类型?这个函数名指向哪个定义?这就是第2章语义分析与符号表的舞台。
本节要点回顾:
- 语法分析回答结合关系:把记号流变成树,让"谁和谁结合"成为显式结构;
- 优先级编码为文法层次,左结合用循环实现;
- 递归下降 = 文法规则直译成函数,主流编译器的首选方案;
- 语法树是后续一切分析的载体,后序遍历即得到计算序列。
追问三则
问:递归下降会不会栈溢出? 会。表达式嵌套一层就是一层函数调用,机器生成的深嵌套代码能把调用栈打穿。把左递归改写成循环只是第一步,彻底的办法是把递归下降的"隐式调用栈"换成显式的堆栈数据结构——这就是表驱动分析器的实质:逻辑等价,栈在堆上,深度随内存不随调用栈。
问:文法有二义怎么办? if a then if b then x else y 里 else 归属谁,文法本身答不了。两条路:改文法,用成对结构把"悬空 else"消掉;或写死一条消歧规则——else 贴近最近的未配对 if。主流语言选后者:文法保留可读性,歧义在实现层裁决。这也提醒我们,语法树的形状由文法与消歧规则共同决定,同一份代码在不同语言里可能长出不同的树。
问:语法错误报在哪里才算报得准? 递归下降的天赋是错误位置天然精确——每个分析函数知道"我在等什么",失配即报,且可在任意函数里定制提示。再进阶一步是错误恢复:失配后同步到分号或右括号再继续分析,让一次编译报出十处错误而不是一处。错误恢复的友好程度,正是手写分析器在工业界经久不衰的工程理由之一。