2.1 语义分析:类型检查与语义约束
2.1 语义分析:类型检查与语义约束
本节摘要:语义分析在语法树之上核对程序的含义规则:类型是否匹配、名字是否已声明、函数调用参数是否对得上、break 是否出现在循环里。这些规则统称静态语义——编译期就能裁决的"说得通"问题。本节以类型检查为主线,讲清自底向上推导类型的过程、隐式转换的插入时机,以及语义检查器如何组织错误恢复。本节承上(消费第1章的语法树)启下(产出的标注树直接喂给第3章的 IR 生成)。
本节在知识链上的位置:语法树解决"结构",本节解决"含义"。没有这一步就生成 IR,相当于不看红绿灯直接起步——程序可能根本跑不起来,而错误被推迟到了最不该暴露的地方(运行时甚至机器码层面)。
一、语义检查都在查什么
把一门真实语言的语义规则摊开,大致落在四个筐里:
- 类型规则:运算数的类型必须匹配(
int + int合法,int + struct非法)、赋值两侧相容、函数实参与形参匹配; - 声明规则:先声明后使用、同一作用域不重复声明、必须 return 的路径真的有 return;
- 上下文规则:
break只能出现在循环或 switch 内、this只能出现在成员函数里、常量表达式里不能有函数调用; - 确定性规则:switch 的 case 值不重复、位域宽度非负——这类"编译期能算出来的必须无歧义"的约束。
这些检查的载体是同一个:带着语义动作遍历语法树。每个树节点定义"我的合法输入类型组合是什么、我的结果类型是什么",检查器自底向上算一遍。
二、类型检查:一次自底向上的递归
表达式 1 + 2.0 * 3 的检查过程值得完整走一遍。乘法优先:2.0 * 3 的两个操作数类型分别是 float 和 int,语言规则允许 mixed arithmetic 并规定"低精度向高精度提升",于是在 int 那边插入一个转换节点,结果类型 float。然后加法:左侧 int、右侧 float,同理插入转换,结果 float。整棵树检查完,每个节点都盖上类型戳:
(+ float) ← 结果类型:float / \ (int→float) (* float) ← 插入的隐式转换节点 | / \ (int 1) (float 2.0) (int→float) | (int 3)
实现上就是给每种节点写一个 type_of 函数:
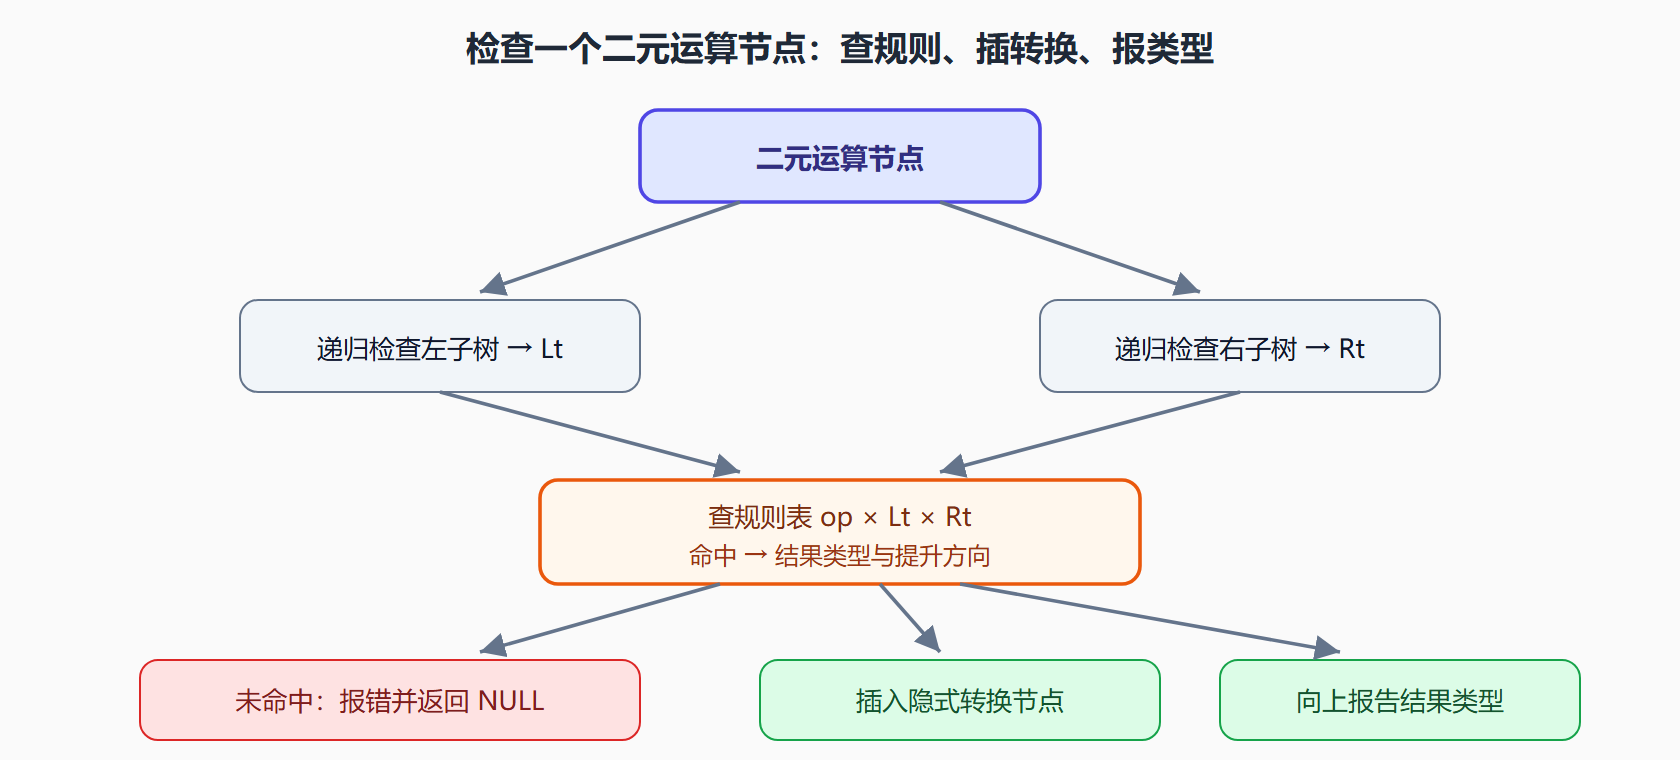
Type *check_binary(BinaryExpr *e) { Type *lt = check_expr(e->lhs); // 先检查左子树 Type *rt = check_expr(e->rhs); // 再检查右子树 if (!lt || !rt) return NULL; // 子树已报错,不再连锁报错 const OpRule *rule = op_rules_lookup(e->op, lt, rt); if (!rule) { diag_error(e->pos, "运算符不支持类型组合 %s 与 %s", type_name(lt), type_name(rt)); return NULL; } if (rule->promote_lhs) e->lhs = wrap_cast(rule->promote_lhs, e->lhs); if (rule->promote_rhs) e->rhs = wrap_cast(rule->promote_rhs, e->rhs); return rule->result; // 本节点类型上报给父亲 }
三个工程细节藏在这几行里。第一,隐式转换是"插入节点"而不是"改标注":转换本身成了树的一部分,IR 生成阶段会把它翻译成真实的转换指令——隐式转换从不免费。第二,错误去重:子树报过错的节点返回 NULL,父节点看到 NULL 不再报新错,否则一个拼写错误能刷出满屏连锁错误。第三,位置信息随身携带:每个节点记着它在源码中的行列号,报错时才能指到行。
图:类型检查器的决策路径
三、静态语义的边界:编译器不包办一切
语义检查有个容易误解的地方:它不是万能错误过滤器。int a[10]; a[999] = 1 的越界(数字写在下标里)理论上编译期可见,但 int a[n]; a[i] = 1 一旦下标来自运行期输入,静态分析就无能为力了。语言设计的取舍在于:把哪些规则放进编译期强制(换来更早的错误暴露和更强的优化前提,比如"类型确定则指令确定"),哪些留给运行时(换来灵活性)。C 选择几乎全静态、零运行时检查;Java 反向操作,数组每次访问都带边界检查,但 JIT 能在证明安全后把检查消掉——那是第8章 JIT 的话题。
⚠️ 语义分析最容易漏的不是类型错误,而是"看似无害的沉默接受":未初始化就使用的变量、有符号溢出、指针类型的双关转换。合格的编译器把这些做进警告体系(如未初始化警告、整数溢出警告),严格的构建再把警告升级为错误。IR 生成之后,这类信息只剩第4章数据流分析还能追回一部分——这也是为什么"未定义变量的使用"在 IR 层面要靠活性分析兜底。
本节要点回顾:
- 静态语义 = 编译期可裁决的含义规则:类型、声明、上下文、确定性四个筐;
- 类型检查是自底向上的递归标注,规则表驱动,隐式转换以节点形式插入语法树;
- 错误处理讲策略:子树出错不再连锁报错、位置信息全程携带、警告体系承接灰色地带;
- 语义分析是 IR 生成的直接前置:每个节点的类型决定生成的指令形态。
下一节把镜头对准类型检查身后那本"名字账簿"——符号表。没有它,"这个 x 是哪个 x"都答不上来,类型检查寸步难行。
再进一步:类型信息的余热
类型检查的价值不止于"报错"。检查过程中推导出的类型,会作为标注固化在语法树上,随后走进 IR——它的余热贯穿整个编译器。三个去向值得点名。其一,指令选择靠它:int 加法与 double 加法在目标机上是指令不同的两类操作,第6章的模式表按类型分派。其二,优化靠它:i32 与 i64 的溢出行为不同,强度削减(第5章)在窄类型上要额外证明不回绕才敢化简。其三,内存布局靠它:结构体的字段偏移、数组步长,全部由类型计算——没有这些,a[i] 的地址算式无从生成。
一个职业习惯建议:读一门新语言,先读它的类型强制规则表(什么能隐式转、什么必须显式转、什么直接禁止)。这张表几乎决定了该语言所有"莫名奇妙"的编译错误与所有隐蔽的类型漏洞,比读语法手册有效得多。