2.2 符号表设计与作用域管理
2.2 符号表设计与作用域管理
本节摘要:符号表(Symbol Table)是编译器记录"名字 → 含义"映射的核心数据结构,作用域管理则回答"同一个名字在不同位置各指哪个声明"。本节给出符号表的经典实现——哈希表加上作用域栈,讲清进入/退出作用域时的压栈弹栈协议、名字解析的查找规则,以及标签、成员、宏这类"不规则名字"为什么要另立门户。这是语义分析一章的工程核心:类型检查的每一次询问都落在符号表的一次查询上。
上一节的类型检查器频繁发出"这个标识符是什么类型"的询问,本节专门回答这类询问怎么被高效、正确地满足。位置关系上,本节先于类型检查被执行使用:符号表通常在两遍里发挥作用——第一遍收集声明(把所有名字填进表),第二遍解析引用(每个使用点查表找绑定)。
一、作用域栈:核心机制
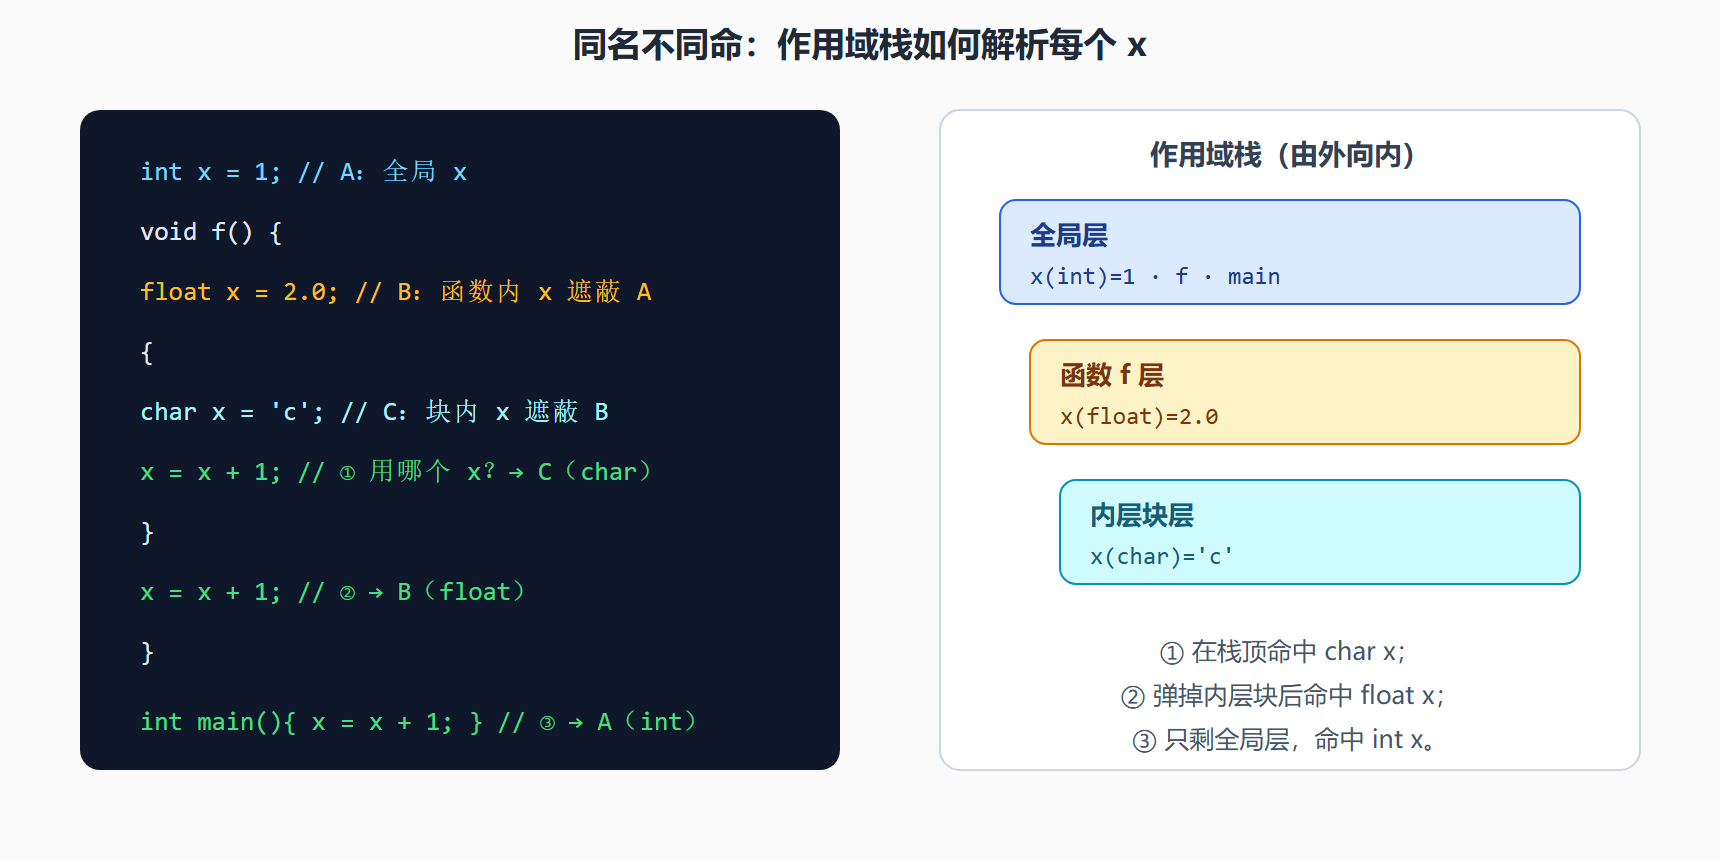
嵌套作用域的规则人尽皆知:内层声明遮蔽外层同名声明,退出作用域后遮蔽失效。把它翻译成数据结构,只需要一个栈,栈里每个元素是一个作用域的哈希表:
#define SCOPE_MAX 64 typedef struct Scope { HashTable *names; // 本作用域的名字 → 符号 struct Scope *parent; // 外层作用域 } Scope; static Scope *current; // 作用域栈顶 void enter_scope(void) { Scope *s = calloc(1, sizeof(Scope)); s->parent = current; current = s; // 压栈:进入一个块 } void exit_scope(void) { current = current->parent; // 弹栈:块的结束括号 } Symbol *lookup(const char *name) { for (Scope *s = current; s; s = s->parent) if (Sym *sym = ht_get(s->names, name)) return sym; // 由内向外,第一命中即所求 return NULL; // 报"未声明的标识符" } void declare(const char *name, Symbol *sym) { if (ht_get(current->names, name)) diag_error(sym->pos, "同一作用域重复声明 %s", name); ht_put(current->names, name, sym); }
四个要点。查找只沿 parent 链向外,永远不会向内——这是"先声明后使用 + 内层遮蔽外层"两条规则的直接编码。重复声明检查只看本层哈希表,外层有同名是合法的遮蔽而不是错误。弹栈即注销:退出作用域后名字自动失效,不需要显式删除。查表路径的长度就是作用域嵌套深度,真实程序很少超过十层,性能无忧。
图:嵌套作用域的解析过程
二、一遍收集,两遍各司其职
C 语言有个著名的设计(或者说历史包袱):函数内使用一个晚些声明的局部变量是非法的,但全局函数可以调用文件中在其后定义的函数。前者单遍扫描就能完成检查,后者必须先把整个文件的顶层声明收集进符号表。工程上统一采用两遍法:
第一遍(收集):遍历语法树,遇到声明就把名字填进当前作用域,不处理任何使用点。函数体内部的声明推迟到遍历该函数体时才入表。
第二遍(解析):再次遍历,遇到每个标识符的使用就执行 lookup,把找到的符号直接挂到语法树节点上(或替换成一个指向符号的指针)。
两遍之后,"名字"这个概念在编译器里的使命基本结束:IR 生成阶段拿到的是已经解引用的符号(含类型、存储类别、相对地址),不再需要按名字查表。这就是符号表信息可以被"固化"的含义——第3章的三地址码里你看不到任何查找动作,所有绑定都是现成结论。
💡 压栈弹栈还有个对偶用途:错误恢复。类型检查在函数体报错后,直接把作用域弹回到函数入口重新开始,可以把错误隔离在单个函数内,不让一个坏函数污染整个文件的检查。
三、不规则名字:另立门户的三张表
如果把所有名字都塞进同一个作用域栈,会立刻遇到规则冲突。以 C 为例:
| 名字种类 | 作用规则 | 为什么单独立表 |
|---|---|---|
| 普通标识符 | 逐层遮蔽 | 主表,见上文 |
| 结构体成员 | 跟随类型而非作用域 | s.field 的 field 由 s 的类型决定,与所在作用域无关 |
| 标号(label) | 函数级扁平,不可遮蔽 | goto 能跨块跳,块作用域规则完全不适用 |
| 宏 | 按处理顺序线性,无嵌套遮蔽 | 预处理器在语义分析之前已经跑完 |
成熟的编译器实现里,这些名字系统各自是一张独立的表,查找规则互不相同。强行合并的代价是:每次查找都要带上"我在找哪种名字"的标记,每条声明规则都要写特例——表结构本身失去不变量。这个经验值得推广:数据结构的设计服从作用域规则,而不是反过来。
本节要点回顾:
- 符号表 = 作用域栈 + 每层哈希表,压栈弹栈对应块的进出;
- 名字解析由内向外、第一命中即所求,重复声明只在本层检查;
- 两遍法:先全量收集声明,再解析使用点,解析结果固化到树节点;
- 不规则名字另立门户:成员、标号、宏各有各的作用域规则,别硬塞进主表;
- 符号表的终点是消失:绑定信息固化进 IR 后,名字查找便退出了编译舞台。
第3章正式进入本册核心:语法树在这趟旅程的终点,是被拍平成三地址码,再升华为 SSA——程序的"结构化表示"让位给"可优化的表示"。
变式演练:一个三层嵌套的手算
把解析规则跑一遍纸上练习。给定:
int x = 1; void f() { float x = 2.0; { char x = 'A'; use(x); } // 第三层 use(x); }
作用域栈的演化:进入文件层压入全局表(x: int);进入 f 压入函数层(x: float)——遮蔽全局;进入内层块再压一层(x: char)。use(x) 在第三层解析:由内向外第一命中是 char 版。内层块结束弹栈,第二个 use(x) 由外向内第一命中 float 版。注意两次 use 虽然长得一样,解析结果挂接的符号却不同——这正是"绑定信息固化到节点"的含义:解析完成后,每个 use 节点各带各的符号指针,此后编译器再也不问"这是哪个 x"。
延伸一个工程视角:为什么查找要"第一命中即停"而不是"报同名歧义错"?因为遮蔽正是程序员表达"我要另一个 x"的手段;把它当错误会废掉一层语言特性。但同层重复声明必须报错——遮蔽规则只在层与层之间生效,这是边界要拿捏准的地方。