3.1 三地址码与控制流图
3.1 三地址码与控制流图
本节摘要:三地址码(Three-Address Code,TAC)是中层 IR 最通行的形态:每条指令至多一个运算符、至多三个操作数(两个源、一个目标),复杂表达式被拆成一串临时值上的简单步骤。把三地址码按"直线执行、单进单出"聚成基本块,再按跳转关系连边,就得到控制流图(CFG)——后续所有分析与优化的地形图。本节给出从源代码到 CFG 的完整翻译示例,并解释基本块划分的两条规则。
本节在知识链上的位置:承接第1章的语法树与第2章的类型标注,把"树"变成"线性指令 + 图"。第4章的数据流分析、本章下一节的 SSA 构造,全都以 CFG 为舞台。
一、从表达式到指令:拆平的艺术
三地址码的核心约束是"一条指令只做一件事"。复合表达式 x = a * b + c * d 无法一步完成,于是引入临时变量:
// 源码: x = a * b + c * d; t1 = a * b t2 = c * d t3 = t1 + t2 x = t3
四条指令、每条一个运算符。临时变量 t1、t2 在源代码里根本不存在,它们是"拆平"过程的脚手架——也是优化的主要工作对象。常见的三地址码指令形态就这几类:
| 形态 | 示例 | 对应的源结构 |
|---|---|---|
| 二元运算 | t = x + y |
算术、比较、逻辑(非短路) |
| 一元运算 | t = -x |
取负、按位取反 |
| 拷贝 | x = y |
赋值、De-SSA 产生的拷贝 |
| 无条件跳转 | goto L |
break、循环回边 |
| 条件跳转 | if x < y goto L |
if、while 的判断 |
| 地址类 | t = x[i](展开为地址计算) |
数组、指针访问 |
| 过程类 | param x; call f, 1; t = ret |
函数调用 |
数组访问值得专门展开。a[i] = b 不是一条指令,而是"算地址 + 写内存"的组合(假设元素占 4 字节、a 的基址已解析):
// 源码: a[i] = b; t1 = i * 4 // 元素大小进入偏移 t2 = a + t1 // a 已是数组首地址 store t2, b // 写内存
为什么坚持一条指令一个运算符?因为优化的粒度就是指令:常量传播想替换的是"t = 2 * 3 里的乘法",死代码删除想删的是"目标从未被使用的某条指令"。允许复杂指令(如一条搞定 x[i] = y)会让每类优化都要先"拆解"再分析,等于把拆平的工作转嫁给每个优化器——不如在 IR 层一次性拆好。
二、控制流:跳转与基本块
直线代码之上要表达控制流。看一段带分支与循环的完整翻译(左侧源码,右侧三地址码):
sum = 0; L0: i = 0; sum = 0 while (i < n) { i = 0 if (i > 100) break; goto L2 sum = sum + i; L1: // while 体末尾 i = i + 1; t1 = i > 100 } if t1 goto L4 // break 跳出 L3: t2 = sum + i sum = t2 t3 = i + 1 i = t3 L2: t4 = i < n if t4 goto L3 // 回到循环体 L4: // 循环出口
这段线性代码怎么变成图?先按两条规则切出基本块:
- 切的头:任何跳转的目标标签处、以及条件/无条件跳转的下一条指令处,都要切开;
- 单进单出:块内代码从第一条执行到最后一条,中途不进也不出(跳转只能出现在块尾)。
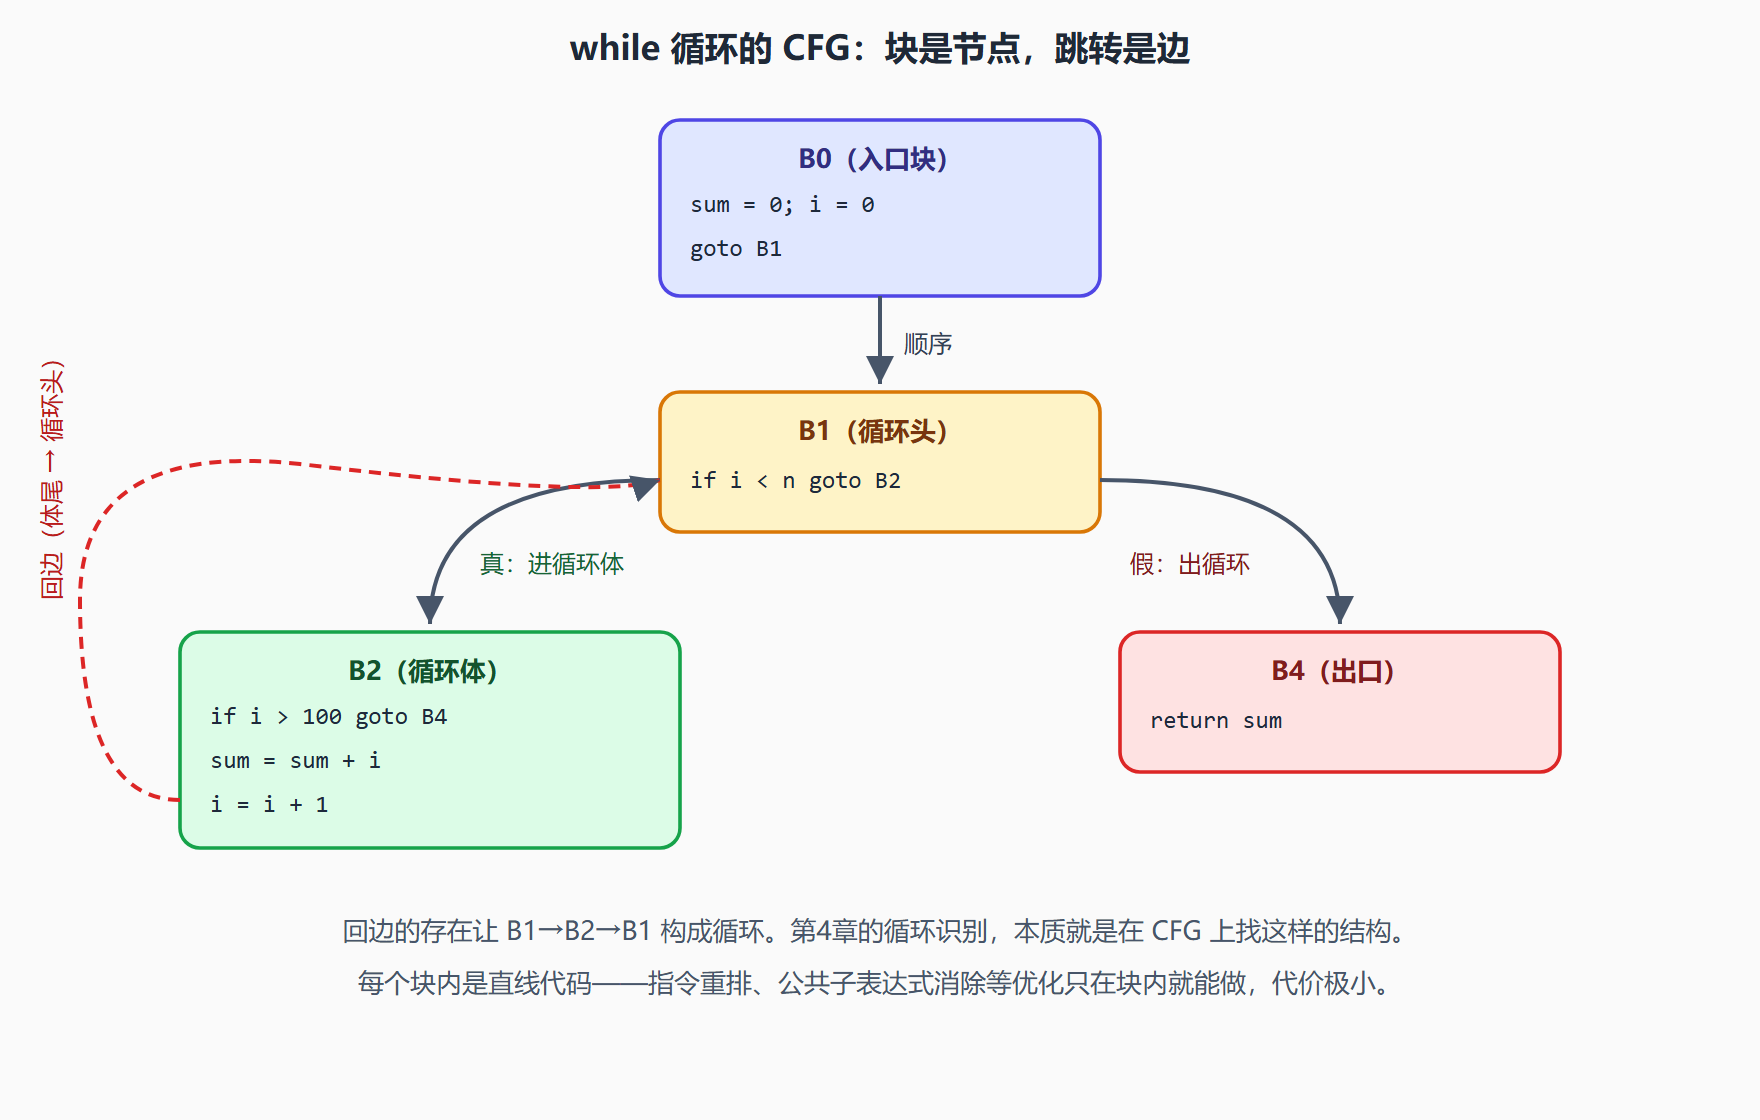
按此规则,上面的代码切成 5 个基本块:B0(L0 的两行赋值加 goto L2)、B1(循环判断 t4 = i < n)、B2(循环体:break 判断与求和自增,尾部 goto L3——实际实现中 L3 标签可消除,B2 尾部直接跳回 L2)、B3(即 L2 标签所在的判断块,若与 B1 合并则为同一块)、B4(出口)。随后把块间的跳转连成边,得到 CFG。下图给出这份数据:
图:源码、三地址码与控制流图对照
三、为什么 CFG 是一切分析的地基
基本块给出"数据流是局部的"这一层:块内每条指令的目标可以立刻查到下一条指令是否使用(局部优化,第5章)。CFG 的边给出"控制从哪来"这一层:一个块可能执行到,前提是存在一条从入口到它的路径(可达性),且它的所有前驱路径上发生的定值都可能影响它(全局分析的前提)。
两个直接的推论。其一,块的粒度是优化的"免费午餐"边界——块内指令顺序重排不需要分析控制流,跨块重排则要证明两条路径等价。其二,CFG 是 SSA 构造的输入——下一节的 phi 函数插在哪里,完全由 CFG 的汇合结构决定。可以说中层 IR 的全部戏剧,都在"块"与"边"这张地形图上展开。
⚠️ 划分基本块时最常见的错误是漏掉"跳转指令的下一条指令处"。若
if x goto L后面直接跟着下一条指令而没切开,块就有了两个出口,单进单出被破坏,后续所有以"块"为单位的分析都会出错。实现时把"条件跳转的后继"也当作隐式标签处理,就不会漏。
本节要点回顾:
- 三地址码一条指令一个运算符,复杂表达式靠临时变量拆平,数组访问展开为地址计算;
- 基本块 = 单进单出的直线段,切分点在跳转目标与跳转后继两处;
- CFG = 基本块 + 控制边,回边标识循环结构;
- 块内局部、块间全局:优化的层次感由 CFG 的地形决定。
下一节在这个骨架上做一次深刻的改名运动:让每个变量只被赋值一次——SSA 登场。
常见问题三则
问:三地址码为什么偏偏是"三"个地址? 两个操作数加一个目标,恰好覆盖"读两个值、算一下、写一个地方"的最小完整单元。二元运算降级成单目(t = -x)或无操作(t = 5)都自然;反过来允许四地址、五地址,就要回答"多出来的操作数怎么求值、按什么顺序"——那已经不是表示,是半个调度问题。KISS 原则在 IR 设计上的一次经典胜利。
问:临时变量的爆炸式增长怎么办? 表达式越复杂,t1, t2, t3… 越多,看似浪费。实际上临时的生命周期极短(往往几条指令内就被消费),寄存器分配(第6章)会大量复用同一个物理寄存器;SSA(下一节起)更是要求每次赋值都起新名字——名字数量从来不是成本,名字的存活重叠度才是。初学时担心"名字太多",是在担心一个分配器会替你解决的问题。
问:goto 怎么变成 CFG? 直接跳转(goto L)把当前块终结、与 L 所在块连一条边,机械但直接。条件跳转(if c goto L)产生两条出边:跳转目标一条、顺序后继一条。间接跳转(函数指针、switch 跳表)最麻烦——目标不唯一,要么枚举所有可能目标连多条边(保守但分析友好),要么把未知目标塞给运行期(分析直接放弃该块的精度)。switch 通常被降级成跳转表加间接跳转,或一串条件比较——两种形态的 CFG 长相完全不同,后续分析的成本也不同。