3.2 SSA 的核心概念与属性
3.2 SSA 的核心概念与属性
本节摘要:静态单赋值形式(Static Single Assignment,SSA)规定:每个变量在整段 IR 中只被赋值一次,后续使用引用这唯一的定义;若控制流在某点汇合且不同路径带来不同版本,则插入 phi 函数按到达路径仲裁取值。这个约束把"定义-使用"关系从需要分析的隐式信息变成名字本身携带的显式信息。本节给出 SSA 的定义、用 if-else 与循环两个示例讲透 phi 的语义,并列出 SSA 为分析与优化带来的四项直接红利。
本节承接 3.1 的 CFG:SSA 不是另起炉灶的表示,而是"在三地址码上多守一条纪律"。理解 phi 的语义是本章其余各节的门票——3.3 讲它插在哪里,3.4 讲它插多少的取舍,3.5 讲它最后如何被消灭。
一、问题:重复赋值到底碍了什么事
普通三地址码里,变量像一只可以反复改写内容的盒子。x = 1; ... x = 2; y = x 中,y = x 用的是哪个 x?答案是"最近一次定值"——但"最近"在循环体里是个动态概念,第几圈就用第几圈的值。任何静态分析想回答"y 可能是什么",都得先做一遍"到达定值分析"(第4章的主题)把所有可能的来路枚举一遍。优化的每个角落都在重复这项劳动:常量传播、死代码删除、公共子表达式消除,无一例外。
SSA 的解法朴素而彻底:禁止改写。每次赋值都诞生一个新名字,旧名字永远指向旧值:
普通形式 SSA 形式 x = 1 x1 = 1 ... ... x = 2 x2 = 2 y = x y1 = x2 ← 用哪个 x?名字自己说了算
y1 = x2 无需任何分析即可确定数据来路。优化器由此获得一个前所未有的便利:值与名字一一对应,跟踪值就是跟踪名字。
二、汇合点上的仲裁者:phi 函数
改写禁令立刻撞上一个问题:两条路径给同一个逻辑变量赋了不同的值,汇合之后怎么办?
if (cond) x = 1; // 路径 A else x = 2; // 路径 B y = x; // 汇合点:x 是 1 还是 2?
SSA 的答案是插入 phi 函数——一条"按到来路径选值"的伪指令:
B0: if cond goto B1 else goto B2 B1: x1 = 1 goto B3 B2: x2 = 2 goto B3 B3: x3 = phi(x1 from B1, x2 from B2) ← 汇合点仲裁 y1 = x3
phi 的语义是运行期动作:执行到 B3 时,看控制流实际从哪条边来——从 B1 来取 x1,从 B2 来取 x2。注意三点。其一,phi 的参数个数等于前驱块个数,每个参数绑定一条具体的入边。其二,phi 可能级联:x3 之后若再有汇合,phi 的结果 x3 会作为上层 phi 的参数。其三,phi 是纯 IR 概念,真实机器没有这条指令——3.5 节的 De-SSA 会把它替换成实际的拷贝指令。
图:汇合点上的 phi 与循环回边的 phi
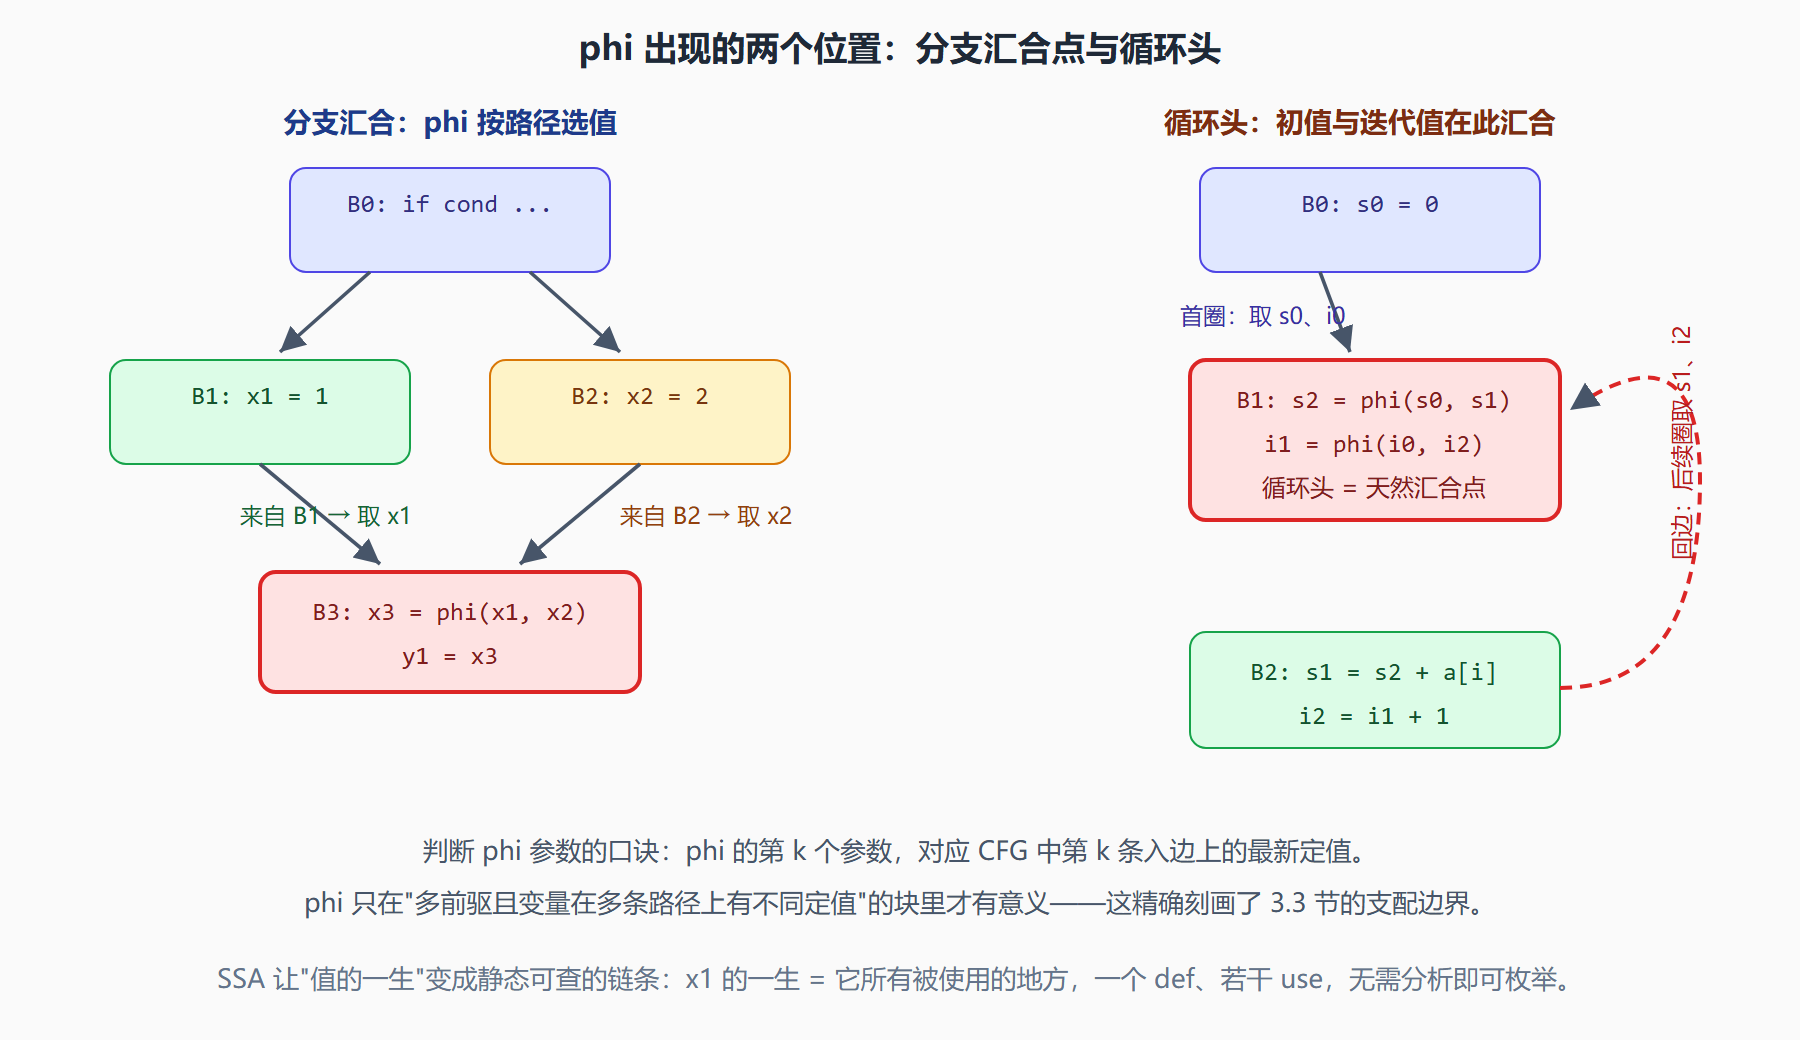
循环的例子更微妙:循环头 B1 有两个前驱(入口 B0 与体尾 B2),所以循环携带的每个变量在 B1 都需要一个 phi——首圈从入口取初值,后续圈从回边取迭代值。归纳变量 i 的 i1 = phi(i0, i2) 是 SSA 表达"随圈变化的变量"的标准姿势,第5章的归纳变量优化与强度削减全靠这个结构。
三、SSA 带来的四项直接红利
- use-def 链免费:每个名字唯一的定义,使用点直接引用定义点,def-use 与 use-def 双向均可 O(1) 挂接。常量传播从迭代求解退化为沿使用链的一趟传播。
- 死代码判定局部化:一个定义若没有任何使用者,它就是死代码——判定不需要任何全局信息。删除动作还可以级联:删掉定义后它的操作数使用数减一,可能连带死亡。
- 值编号天然成立:两条指令操作数名字相同即值相同,公共子表达式消除变成哈希查重(第5章 5.1 的示例)。
- 数据流方程稀疏化:第4章将看到,活跃变量这类"必须对每个程序点迭代求解"的问题,在 SSA 上可以化为"沿 use-def 图传播"的稀疏问题,复杂度从与程序点数成正比降到与真实依赖数成正比。
代价也要说清楚:SSA 是一种"面向优化"的表示,直接执行不了——phi 在真机上不存在,变量数目爆炸(每次自增都产生新名字)会让寄存器压力分析失真。所以完整旅程必然包含 3.5 节的 De-SSA:优化在 SSA 上做完,离开优化世界前还原成普通形式。
本节要点回顾:
- 单赋值纪律:每次赋值一个新名字,值与名字一一对应;
- phi 函数:按到来路径在汇合点仲裁取值,参数与前驱边一一对应;
- 循环头是天然汇合点:携带变量必配 phi,初值与迭代值两条来路;
- 四项红利:use-def 免费、死代码局部化、值编号成立、数据流稀疏化;
- SSA 是优化的语言,不是执行的语言,它的生命周期止于 De-SSA。
phi 应该插在哪些块?插少了分析不准,插多了浪费。下一节的支配边界给出精确答案。
回答三个疑问
问:SSA 与函数式语言里的不可变变量是一回事吗? 神似而不同。函数式的不可变是语义承诺——值真的终生不变,程序员可见;SSA 是表示技巧——把可变程序翻译成"每步一个新名字"的形式,源程序里变量照旧可变。有趣的是方向可以反过来:函数式语言编译到 SSA 几乎零摩擦(本来就单赋值),而 SSA 的成功也反过来影响了语言设计——现代语言越来越多地鼓励不可变风格,因为编译器最擅长的表示与之对齐。
问:版本号的长度有限制吗? %i 到 %i99999 只是记号,实现里根本不存"i + 版本号"这样的字符串——每个版本是独立的对象,靠 def-use 指针互联,"同名"只存在于调试打印里。所以名字长度不成问题,真正要留意的是上一段说的压力失真:版本一多,"同时活着的名字数"的直观估计容易失真,分配器(第6章)用活期分析来纠正这个错觉。
问: SSA 对调试是灾难吗? 对"看变量名设断点"的传统调试确实是——源码里的 i 在 IR 里是 %i、%i1、%i2 一串。工业解法是把源级变量名与版本值的映射存进调试元数据:每个 SSA 版本记录"我对应源码变量 i 的哪段区间"。优化越激进,映射越破碎,这是"调试版 vs 发行版"行为差异的技术根源,不是玄学。