1.2 手工调优的四道天花板
1.2 手工调优的四道天花板
本节摘要:把 1.1 节还原的日常痛点归纳为四道结构性天花板——脆弱性、不可迁移、无评估、难协作,并逐道分析其成因与代价。这四道天花板是理解 DSPy 全部设计的钥匙:三层抽象与编译器分别在拆除哪道墙,读完本章再往后看会一清二楚。
一、第一道天花板:脆弱性
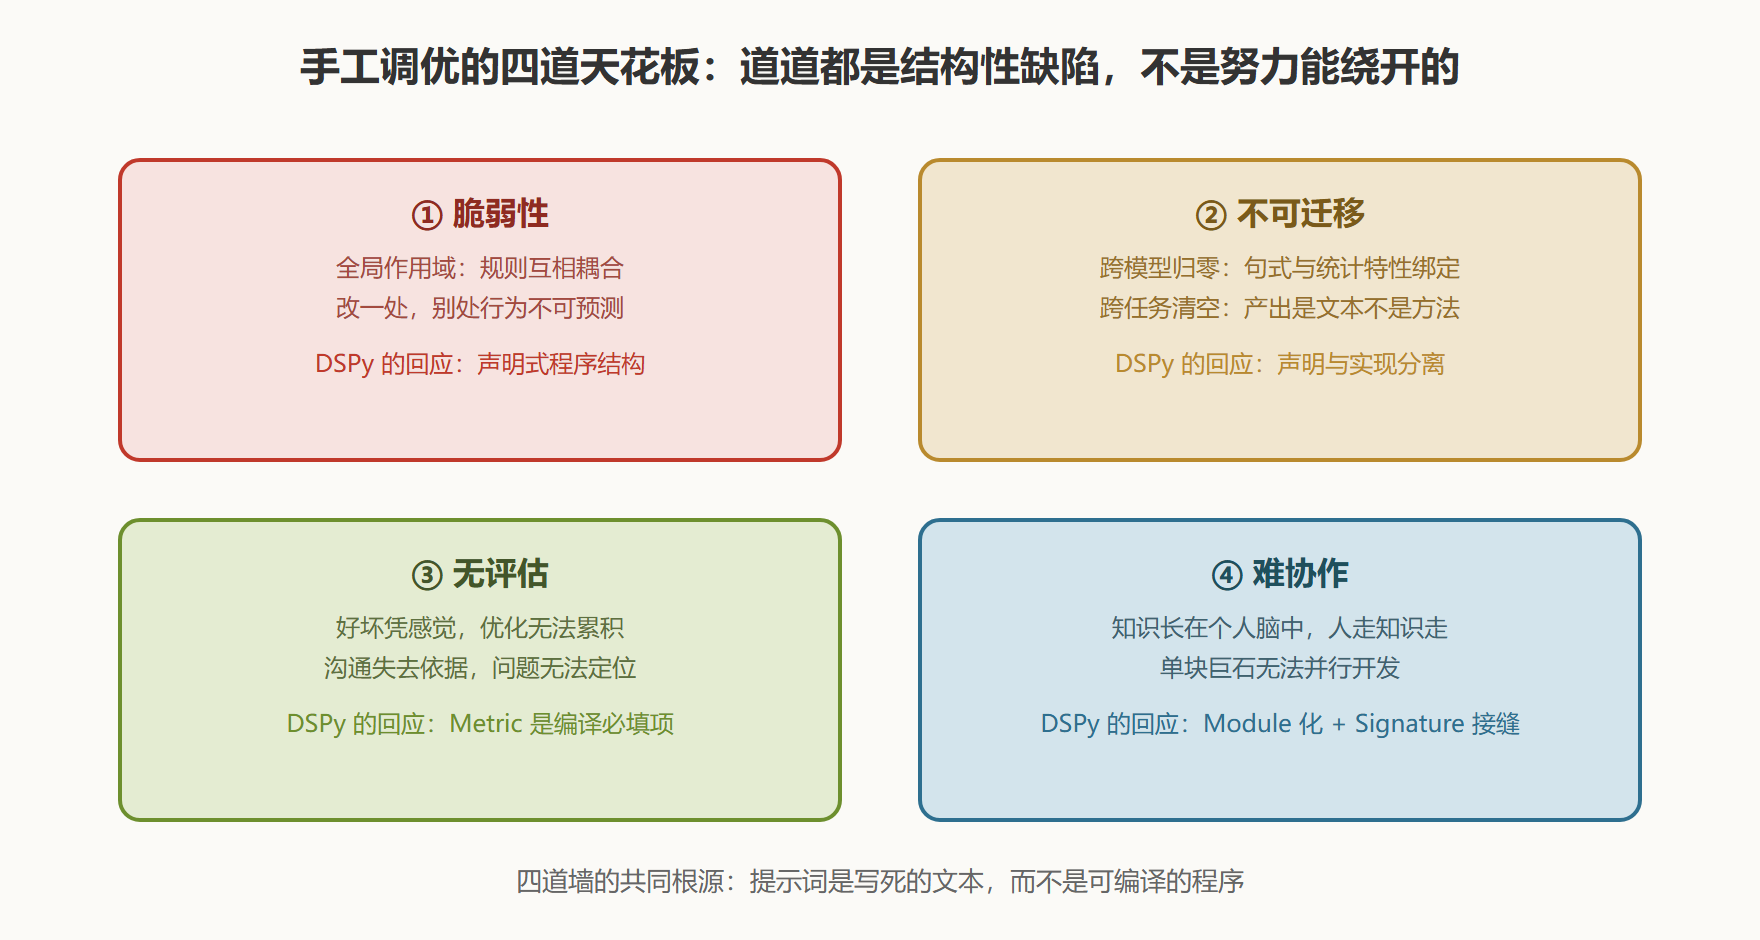
脆弱性指提示词行为对局部修改极端敏感:为修复一个错误而追加的规则,会在你看不见的地方改变其他输入的行为。成因要从语言的本质说起。程序代码有语法和语义两层精确约定,编译器能保证"改这个函数不会改变那个函数的行为"(只要接口不变);自然语言没有这种隔离机制,提示词里每句话都在全局作用域生效,"客服应道歉"这样看似无害的指令,与"不知道就说不知道"组合后可能产生"为了礼貌而编造安慰性答案"的涌现行为——两个正确指令的组合产出错误行为,而且没有任何工具能在上线前发现这一点。
脆弱性的直接代价是回归成本。手工团队应对它的方式是"改完把印象中的场景都测一遍",这在提示词只有十行时勉强可行;当系统提示膨胀到几十行、示例十几条时,组合空间已经超出任何人的记忆容量。我们在 1.1 节看到的那位工程师,最后那句"好像都好了",就是脆弱性付出的典型账单。
二、第二道天花板:不可迁移
不可迁移有两个维度。其一是跨模型:为一个模型打磨的句式、示例、思考话术,换到另一个模型(甚至同系列的新版本)上收益归零甚至为负。那个年代恰逢模型快速迭代,团队经常面对荒诞的局面——底座升级本是好事,提示词却要整体重调,升级反而变成成本。其二是跨任务:为一个客服问答调优的经验,迁移到合同抽取任务时几乎无处安放,因为手工调优沉淀的是"具体字符串"而不是"可复用的方法论"。
这个维度的根源在 1.1 节已经点过:手工调优的产出物是文本常量,不是程序。文本常量与具体模型的统计特性深度绑定,模型一换,文本与行为之间的映射关系全部作废。要跨模型迁移,产出物必须上升到更高的抽象层级——声明"任务是什么"而不是"提示词怎么写",让某个下游环节负责把声明翻译成对每个模型最合适的提示词。这个"某个下游环节",就是后来 DSPy 里的编译器。
三、第三道天花板:无评估
前两道天花板描述的是"改不好",第三道更根本:根本不知道什么叫"好"。手工时代绝大多数团队没有评估集——这不能全怪团队不敬业,而是评估本身在手工范式下不成立:要评估就得固定测试输入与期望输出,而期望输出的整理成本高昂;更麻烦的是,很多任务(开放问答、摘要、创作)连"标准答案"都难以定义,一条摘要比另一条好多少,谁说了算?
没有评估的连锁反应是全线的。优化无法累积:你不知道这版比上一版好还是坏,只能选择不折腾。沟通失去依据:产品经理说"机器人还是笨",工程师说"比上周强多了",双方都拿不出数字。问题无法定位:线上错了三个 case,无法区分是知识缺失、格式问题还是推理错误,因为各个成分的质量从未被分开度量过。在传统软件里,测试先行已是常识;在手工调优时代,LLM 应用整个行业都活在没有测试的世界里——直到 DSPy 把指标(Metric)设为编译的强制输入,这个问题才被制度性解决。
四、第四道天花板:难协作
前三道天花板都是技术性的,第四道是组织性的:提示词知识长在个人脑子里。那个项目里那份 47 条规则的提示词,为什么是这 47 条?哪几条可以删?多数团队答不上来——规则背后的"事故记忆"存在于个别工程师的脑中,人一走,提示词就成了谁也不敢动的遗产。代码至少可以评审(review),但提示词的评审效率极低:评审者面对一版新提示词,唯一靠谱的办法是自己拿几个 case 跑跑看,于是每次评审都是一次小规模手工复测,没人愿意多做,评审就流于形式。
难协作还有一个隐蔽后果:团队无法并行。两个人同时改同一个提示词,合并冲突是小事,真正的冲突在语义层——各自基于自己测试过的 case 做了互相破坏的修改,谁也不知道。传统软件工程用模块化解决并行开发,而提示词是单块巨石(monolith),天然拒绝拆分——除非,像 DSPy 后来做的那样,把程序拆成 Module、把 Module 的接缝显式化为 Signature。
图:手工调优的四道天花板
时代背景:为什么天花板当时撞不开
公平地看待历史,还要回答一个问题:既然四道墙这么明显,当年为什么没人绕开?答案一部分在于时代条件。其一,模型接口粗放:早期只有补全式接口,没有结构化输出、没有函数调用,提示词必须承担格式约定的全部职责,措辞稍有不慎输出就散架——脆弱性被接口形态放大。其二,算力与调用成本敏感:一次实验就是真金白银的 API 账单,系统性搜索提示词空间(动辄成百上千次调用)在当时的经济模型下不可行,手工调优某种意义上是成本约束下的理性选择。其三,评测文化尚未建立:开放域任务的标准评测集稀缺,团队即便想做评估也不知从何下手,"凭感觉"是整个行业的默认状态。
这些条件解释了天花板为何长期存在,但更有启发性的是它们如何被逐个拆除:模型接口进化出结构化输出与函数调用,脆弱性的接口根源被削弱;模型推理成本逐年下降,系统性搜索在经济上变得可行;评测集与评测方法学逐步成熟,评估文化有了地基。DSPy 的出现恰好踩在这三条曲线的交汇点上——这不是巧合,而是范式转移的典型时机结构:不是天才发明了新范式,而是条件的成熟让新范式成为必然选项。读到第 4 章编译器的进化史时,你会再次看到这种"条件驱动"的痕迹。
把四道墙放到一起看,还有一个容易被忽略的维度:它们对团队规模的惩罚是不对称的。一个人的作坊里,四道墙的代价可以被个人脑力部分吸收——一个人记得住自己的全部规则、不需要与自己协作、凭手感就能维持一套评估的错觉。团队一旦超过三五个人,四道墙的代价呈非线性上涨:记忆分叉、协作冲突、评估话语权之争接连出现。这解释了一个当时反复被验证的现象:手工调优的优秀实践几乎全部诞生在小团队,而大团队用同样的方法论几乎必然失败——不是大团队的工程师更弱,是方法论的适用边界就在那里。判断一个方法论是否可扩展,要看它对协作规模的敏感性,四道墙恰好每一道都随规模放大。
天花板之间的连锁关系
四道天花板不是并列关系,而是递进放大的关系。脆弱性使每次修改都有风险,风险叠加无评估,导致团队不敢改动,形成"能跑就别碰"的冻结文化;不可迁移把冻结的代价放大到每次模型升级,提示词资产一次次清零;难协作则让以上一切只能靠极少数人的脑力支撑。反过来,一旦在某一点上取得突破——比如先建起评估集——其他几道墙也会松动:有了数字,脆弱性的代价可以被量化,迁移的收益可以被验证,协作有了共同语言。这个连锁结构解释了为什么 DSPy 把"指标优先"作为框架的使用前提:它是四道墙里承重的那一面。
本节要点回顾
- 一、脆弱性:提示词全局生效、互相耦合,修改的副作用不可静态推演,只能靠覆盖不了的测试暴露。
- 二、不可迁移:文本常量与具体模型深度绑定,跨模型与跨任务两次清零,根因是缺少中间表示。
- 三、无评估:没有评估集则优化不可累积、沟通失去依据、问题无法定位,它是四道墙中承重的一面。
- 四、难协作:事故记忆私有化、评审退化为手工复测、单块巨石拒绝并行。
- 结构性结论:四道墙的共同根源是"提示词是文本不是程序";下一个十年的答案,是给它配一门"高级语言"和"编译器"——这正是第 2 章 DSPy 登场的方式。