6.5 生产部署与常见坑排错
6.5 生产部署与常见坑排错
本节摘要:从 notebook 到线上服务的最后一段路:编译产物的服务化封装、示范缓存的预算账、线上监控的四类信号,以及八条从真实事故里提炼的高频踩坑与排错路径。全册的收官之作——把前面所有体系装进生产的约束里。
从 notebook 到线上服务的距离
notebook 里的程序与线上服务之间隔着三个工程问题:产物如何加载、请求如何并发、失败如何兜底。服务化封装的最小形态如下:
import dspy # 启动时加载编译产物,而不是在线编译 kbqa = KBQA() kbqa.load("kbqa_compiled_v37.json") # 产物文件随版本发布,可回滚 dspy.configure(lm=dspy.LM("openai/gpt-4o-mini", max_tokens=512, temperature=0.0)) def handle_question(question: str, history: str) -> dict: try: pred = kbqa(question=question, history=history) return {"answer": pred.answer, "grounded": pred.grounded} except Exception: return {"answer": "系统繁忙,请稍后再试或转人工。", "grounded": False}
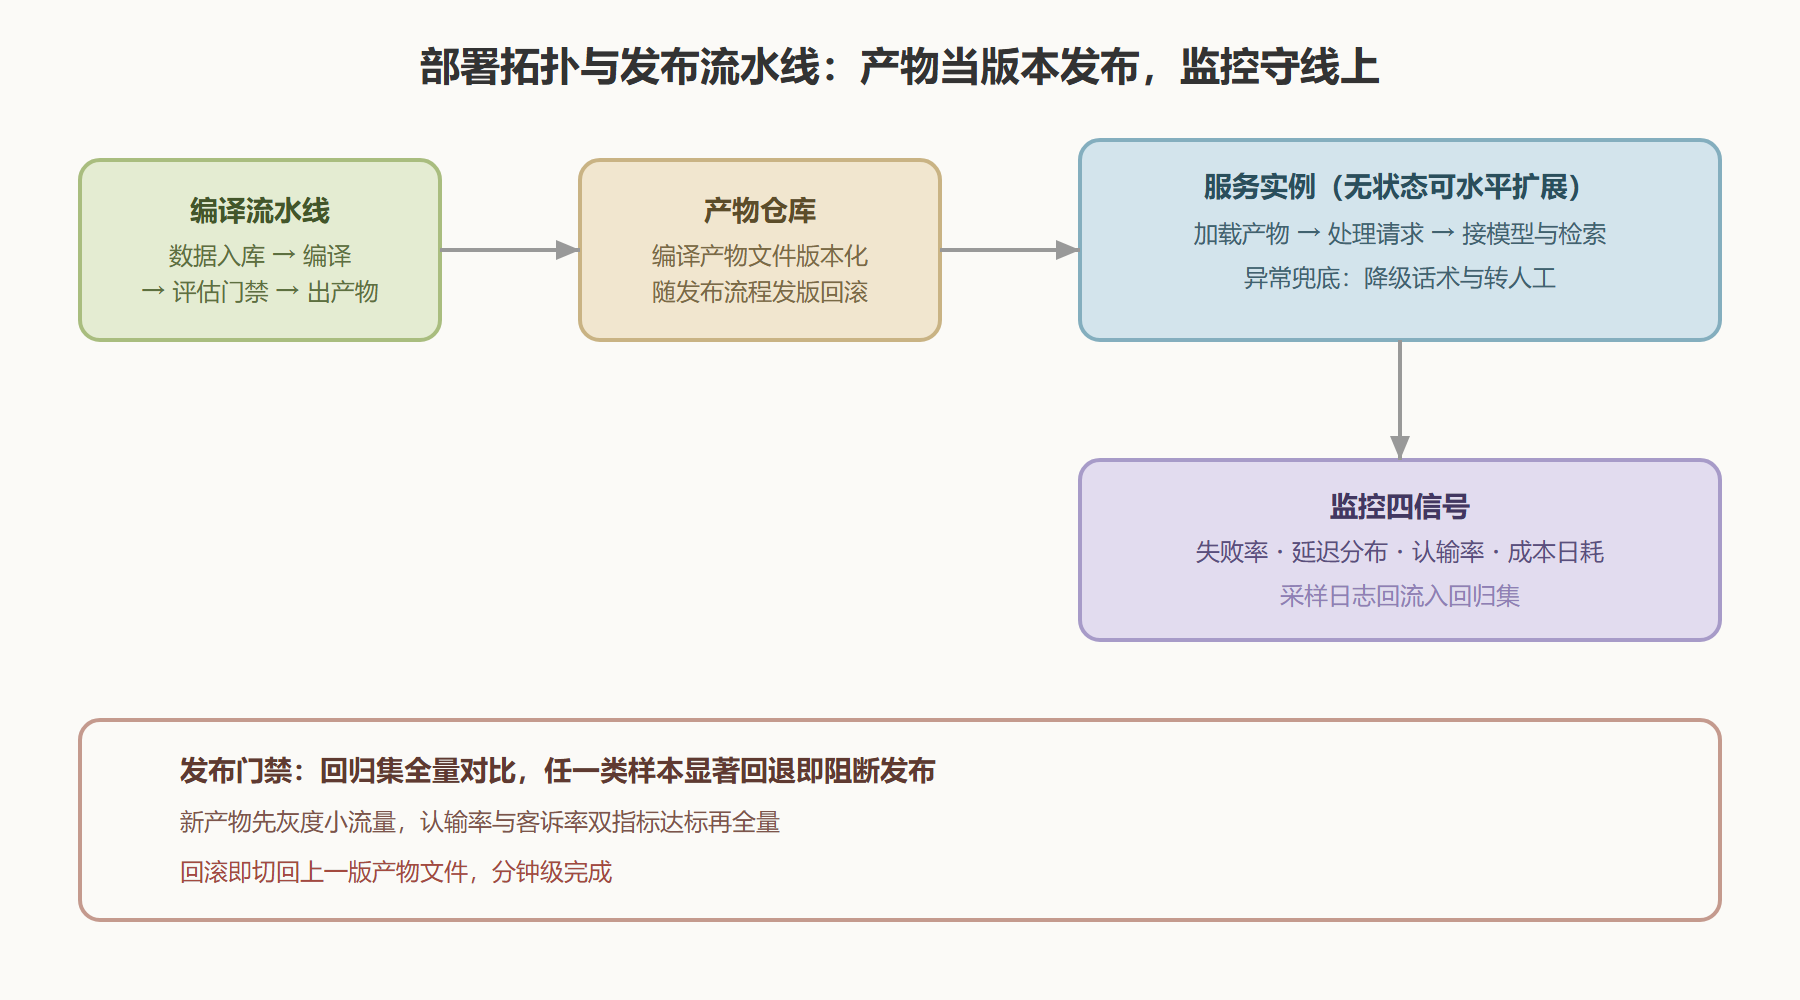
三个决定的理由:加载而非在线编译(编译是分钟级、高开销操作,属于发布流程不属于请求路径);temperature 压到零(生产要稳定,创作类任务除外);请求级异常兜底(模型服务超时、限流、解析失败在生产环境都是常态,兜底话术加转人工路径必须有)。并发层面,DSPy 程序本身是无状态的(状态在产物文件与外部服务里),水平扩展直接复制实例即可——这是编译范式部署侧的红利:提示词不再是部署的阻塞项。
图:生产部署拓扑与发布流水线
示范缓存的预算账
部署后的成本结构要算清。每次请求的调用开销 = 输入 token(提示词含示范)+ 输出 token。示范让输入变长——编译产物动辄携带几千 token 的示范池,这是编译范式的"隐形房租"。三个降本手段按优先级:一,响应缓存(相同或语义相近的问题直接命中缓存,客服场景命中率常达四成以上,几乎零成本);二,示范精简(审计示范池的边际贡献,消融显示尾部示范贡献甚微时果断删——5.5 节的归因方法直接用于降本);三,模型分层(简单请求路由到小模型,认输率与失败率做路由质量的监控指标)。月度账单的估算公式:请求数 × 命中率补集 × 单请求 token 成本,三个旋钮分别作用于公式右端的每一项。
监控的四类信号与八条踩坑
线上监控盯四类信号:失败率(异常与解析失败占比)、延迟分布(长尾延迟比均值重要,重试与断言回溯都吃长尾)、认输率(认输机制触发的比例——认输率突然升高通常意味着检索或知识库出问题,而不是模型变笨)、成本日耗(token 消耗的异动常是质量事故的前兆,比如陷入意外的重试风暴)。
高频踩坑八条,每条给排错路径。一,上线后效果与评估分不符:先查输入分布是否漂移(线上问题的形态与训练集差异),补数据重编译,别先调参数。二,偶发解析失败:查输出被截断的案例(max_tokens 给不足是头号惯犯),再查字段类型与模型输出习惯的冲突。三,检索突然不准:知识库更新后索引未重建,或切块策略被上游改动——检索层独立监控(5.4 节)此时救命。四,成本暴涨:先查重试风暴(断言回溯封顶失效或模型服务限流引发重试),再查缓存命中率是否归零。五,延迟毛刺:示范池过大推高输入 token,或断言回溯叠加,审计产物瘦身。六,改了签名没生效:产物文件是编译时的快照,改源码不重编译等于没改——这是新手最高频的误操作。七,多环境行为不一致: LM 配置差异(温度、版本号漂移),把模型标识与参数纳入产物版本记录。八,裁判指标与人工判断脱节:裁判模型漂移或领域规则更新,按 5.5 节的人工抽检频率复核,必要时换裁判重校准。
这八条的公共密码是"分层取证":每条排错路径的起点都不是"重新编译试试",而是先确认问题在哪一层——数据、检索、结构、产物、配置。分层思维贯穿全册,在排错场景里它就是止损速度。
四类信号建议配套一个简单的日报机制:每天固定时间把四个数字与七天滑动均值做对比,偏离超过阈值的自动标红。日报的价值不在看而在归因速度——大多数成本事故与检索事故从异动到定位,差的只是"发现得早"。阈值怎么定没有统一答案,经验做法是按业务容忍度倒推:客服场景认输率超过三成就要人工介入排检索,成本日耗偏离均值两成就查调用明细。阈值定好后按季度回看校准,避免阈值与业务脱节后形同虚设。
灰度发布的一次完整记录
部署策略里最值得制度化的是灰度发布。压缩记录一次真实流程:新版产物(MIPROv2 重编译,验证分提升约两个百分点)进入发布流程。第一步回归门禁:回归集全量对比,总分达标,但边界样本类出现小幅回退——回退在噪声带边缘,评审决定放行灰度但收紧观察指标。第二步小流量:百分之五的线上流量切到新版本,观察二十四小时,认输率与客诉率双指标与旧版持平,放行至半量。第三步全量:半量再跑一晚,成本信号出现异常——单请求平均成本上涨约一成,归因发现新版指令变长推高了输入 token。处置:示范池按 5.5 节归因消融精简一轮,成本回落,全量放行。整个过程约三天,两次放行依据都是数字而非直觉。
这次记录的通用启示:灰度的观察指标应当包含成本信号,而不只看质量指标——编译产物质量的提升有时以更长的提示词为代价,没有成本监控的灰度会漏掉这类"隐性回退"。发布不是质量与速度的权衡,是质量、成本、风险三者的联合决策。
产物版本管理的最小规范
踩坑清单里反复出现"产物文件管理混乱"的影子,值得单独给一套最小规范。规范只有五条:产物文件进代码仓库(与源码同库同审查);文件名带版本号与编译日期;每次编译在发布说明里登记编译参数(优化器类型、关键参数、训练集版本号);评估记录与产物文件同名归档(审计时可对照);同一时间只允许一个产物版本标记为"线上运行中"。五条的成本几乎为零,收益却覆盖排错、回滚、审计三个高频场景——尤其第三条,训练集版本号与编译参数的登记是复现任何一次历史编译的唯一钥匙,缺了它,"上个月那个好用的版本是怎么编出来的"就会成为无解悬案。
本节要点回顾
- 服务化三决定:产物随版本加载而非在线编译、生产温度压零、请求级兜底;程序无状态可水平扩展。
- 发布门禁:回归集全量对比加灰度双指标,回滚即切产物文件,分钟级完成。
- 隐形房租与三旋钮:示范推高输入成本;响应缓存、示范精简、模型分层按优先级降本,月度账单可公式化估算。
- 监控四信号:失败率、延迟长尾、认输率、成本日耗;认输率异动是检索问题的信号灯。
- 排错总纲:八条高频坑的公共解法是分层取证——先定位层,再动手;"重新编译试试"永远不是第一步。
全册到此收束。从手工调优的窘境走到生产的监控面板,这条演化主线的下一程,由你手上正在编译的那个程序续写。