4.4 VARIANT与半结构化数据
4.4 VARIANT与半结构化数据
本节摘要:VARIANT 是 Snowflake 为半结构化数据准备的"万能列":JSON、Avro、ORC、Parquet、XML 都能整个装进去,行内最大约 16MB(压缩后),查询时用路径语法按需取值。本节讲清它的存储本质(拆成列式而非存文本串)、查询的三种写法、FLATTEN 展开数组的姿势,以及最重要的建模决策——哪些字段该留在 VARIANT 里,哪些该拉平成关系列。本节是新增节,弥合"传统关系建模"与"模式多变的现实数据"之间的断层。
「Schema-on-Read」的具体化
上一节处理的时间维度针对"行",这一节处理"列不固定"的问题。埋点、IoT 报文、第三方 API 返回值有个共同点:字段结构因版本、渠道、场景而异,今天多一个字段、明天少一个字段。传统数仓要求写入前先定模式(Schema-on-Write),字段一变就要改表、改 ETL。VARIANT 把模式检查推迟到读取时(Schema-on-Read)——原始 JSON 原样入库,解析发生在查询的那一刻。
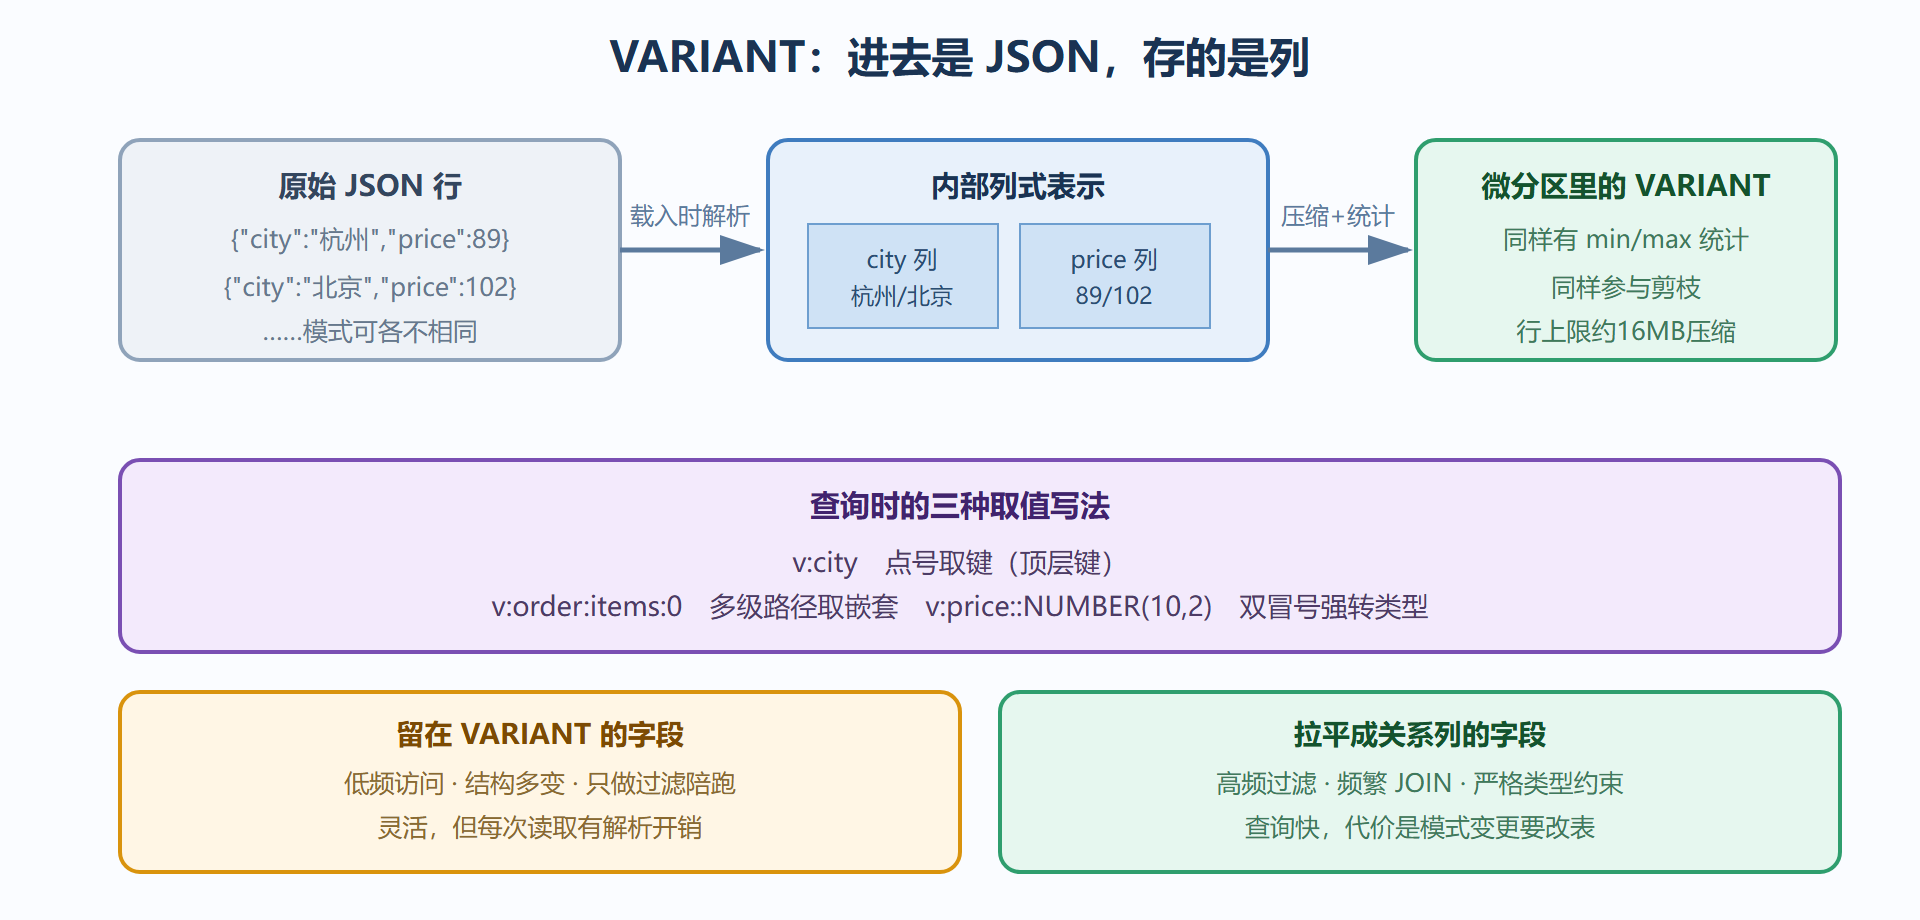
但别把 VARIANT 误当成"存了个大字符串"。加载时系统会把 JSON 等格式解析成内部的列式表示:键值对被拆开、同键数据按列聚集、压缩编码。所以在同一段 JSON 内部,price 键的值其实集中存放、高度压缩——半结构化数据享受到了列式存储的大部分红利。
图:VARIANT 的存储与查询路径
动手:从载入到展开的完整会话
一段 JSON 从进门到出报表的完整链路,跑一遍就懂了:
-- 1. 原始层:整行 JSON 进 VARIANT 列(Snowpipe 载入,见 4.1) CREATE TABLE raw_events (ts TIMESTAMP, v VARIANT); -- 2. 直接查询原始层:路径语法 + 类型转换 SELECT v:city::STRING AS city, -- 顶层键 v:order:amount::NUMBER(10,2) AS amt, -- 嵌套键 v:items[0]:sku::STRING AS first_sku -- 数组第一个元素 FROM raw_events WHERE v:city::STRING = '杭州'; -- 过滤也能用路径 -- 3. 数组展开:订单里有多个商品行,FLATTEN 一行变多行 SELECT e.ts, f.value:sku::STRING AS sku, f.value:qty::NUMBER AS qty FROM raw_events e, LATERAL FLATTEN(input => e.v:items) f; -- items 是数组,每个元素出一行 -- 4. 建模层:把稳定字段拉平成关系列,收敛查询成本 CREATE TABLE clean_orders AS SELECT v:order_id::STRING AS order_id, v:city::STRING AS city, v:order:amount::NUMBER(10,2) AS amount, v AS extra -- 长尾字段仍留 VARIANT FROM raw_events;
第 2 步有一个容易被忽略的细节:路径取出的值默认是 VARIANT 类型,做比较或聚合前要 ::类型 显式转换。漏写转换时 '89' 与 89 的比较行为不符合直觉,这是 VARIANT 查询最常见的低级错误。
建模决策:留在 VARIANT 还是拉平
第 4 步的 clean_orders 已经给出答案的雏形。决策标准按收益排序:
- 访问频率:几乎每条查询都要用的 3 到 5 个字段,拉平。拉平后的字段是原生列,有干净的统计与类型系统,JOIN 与聚合开销最低。
- 过滤/JOIN 角色:作为等值过滤或连接键的字段,拉平。类型转换函数在 JOIN 的两侧反复执行是真实开销。
- 写入频率:结构每天在变的长尾字段,留 VARIANT。为一个月才出现一次的字段改表,运维成本高于查询收益。
- 生命周期:原始层永远留完整 VARIANT——它是"后悔药",任何建模失误都能从原始层重放,与 4.3 的 Time Travel 构成双保险。
| 对比维度 | 整体存 VARIANT | 拉平为关系列 |
|---|---|---|
| 模式变更 | 零成本 | 需改表 |
| 高频过滤查询 | 较慢(转换开销) | 快 |
| 聚合与 JOIN | 慢且易错(类型陷阱) | 快且类型安全 |
| 存储占用 | 键名重复存储(可压缩) | 更紧凑 |
| 适合阶段 | 原始层、探索期 | 建模层、稳定期 |
💡 关键直觉:VARIANT 与关系列不是二选一,而是同一份数据的两个时点。原始层存 VARIANT 保灵活性,建模层拉平保性能;用 ELT 视角看,这是同一张表在管道里的两次转世。
易错点三条
⚠️ 单行体积上限。VARIANT 行内约 16MB(压缩后)封顶,超大的 JSON 要在加载侧拆分,或改用文件直接查询的方式(外部表)。
⚠️ 把 VARIANT 当低调试场。有人在 VARIANT 里塞进几十种嵌套结构、查询时写五层路径转换,排查问题时苦不堪言。路径层级超过两三层,就应考虑在建模层物化。
⚠️ 空值三态。VARIANT 里"键缺失、键存在但为 null、IS_NULL_VALUE 为真"是三种不同状态,过滤条件写错会把三种混在一起。拿不准时先 SELECT v:field, TYPEOF(v:field) 看一眼再写条件。
本节要点回顾
- 存储本质:VARIANT 不是文本串,载入即解析成列式表示,享受压缩与剪枝。
- 查询三件套:点号路径、数组下标、双冒号强转;数组展开用 LATERAL FLATTEN。
- 建模两时点:原始层全 VARIANT 保灵活,建模层高频字段拉平保性能。
- 三条红线:16MB 行上限、深层嵌套要物化、空值三态要分清。
至此,数据的"形态与时间"讲完。下一章让这份数据跨出账户边界——零拷贝共享,以及由 Streams/Tasks 组成的数据工程管线。
问题:VARIANT 列能建索引加速吗?
没有传统索引,但有两层替代能力:一是路径过滤同样参与微分区剪枝——VARIANT 内部解析后的列式表示带有统计,常用路径的等值过滤可以剪掉无关分区;二是确有点查需求时,Search Optimization 可以对 VARIANT 的指定路径开启加速(6.2 的武器之一)。正确的顺序仍是先剪枝、再评估专用加速,而不是上来就问索引。
问题:写入时能校验 JSON 的结构吗?
可以按需选择。宽松做法是原始层不做任何校验,坏结构留给查询时的类型转换去暴露;严格做法在加载或 ELT 步骤里用校验函数检查必填键与类型,不合格的行进错误表。建议折中:原始层宽松、建模层严格——错误被隔离在清洗环节,既有告警又不阻塞数据进门。