4.3 Time Travel与Fail-safe
4.3 Time Travel与Fail-safe
本节摘要:上一节说微分区的删改只是"标记 + 重写",旧版本物理保留——本节兑现它的价值:Time Travel 让你能查询、恢复、克隆任意保留期内的历史状态。三个硬数字先立住:保留期默认 1 天,企业版及以上最长可调到 90 天;保留期结束后的 7 天是 Fail-safe 兜底窗口,由平台处置、不向用户开放。本节还包括零拷贝克隆——元数据层面的"复制",秒级完成且暂不占存储。
数据只有"现在"吗
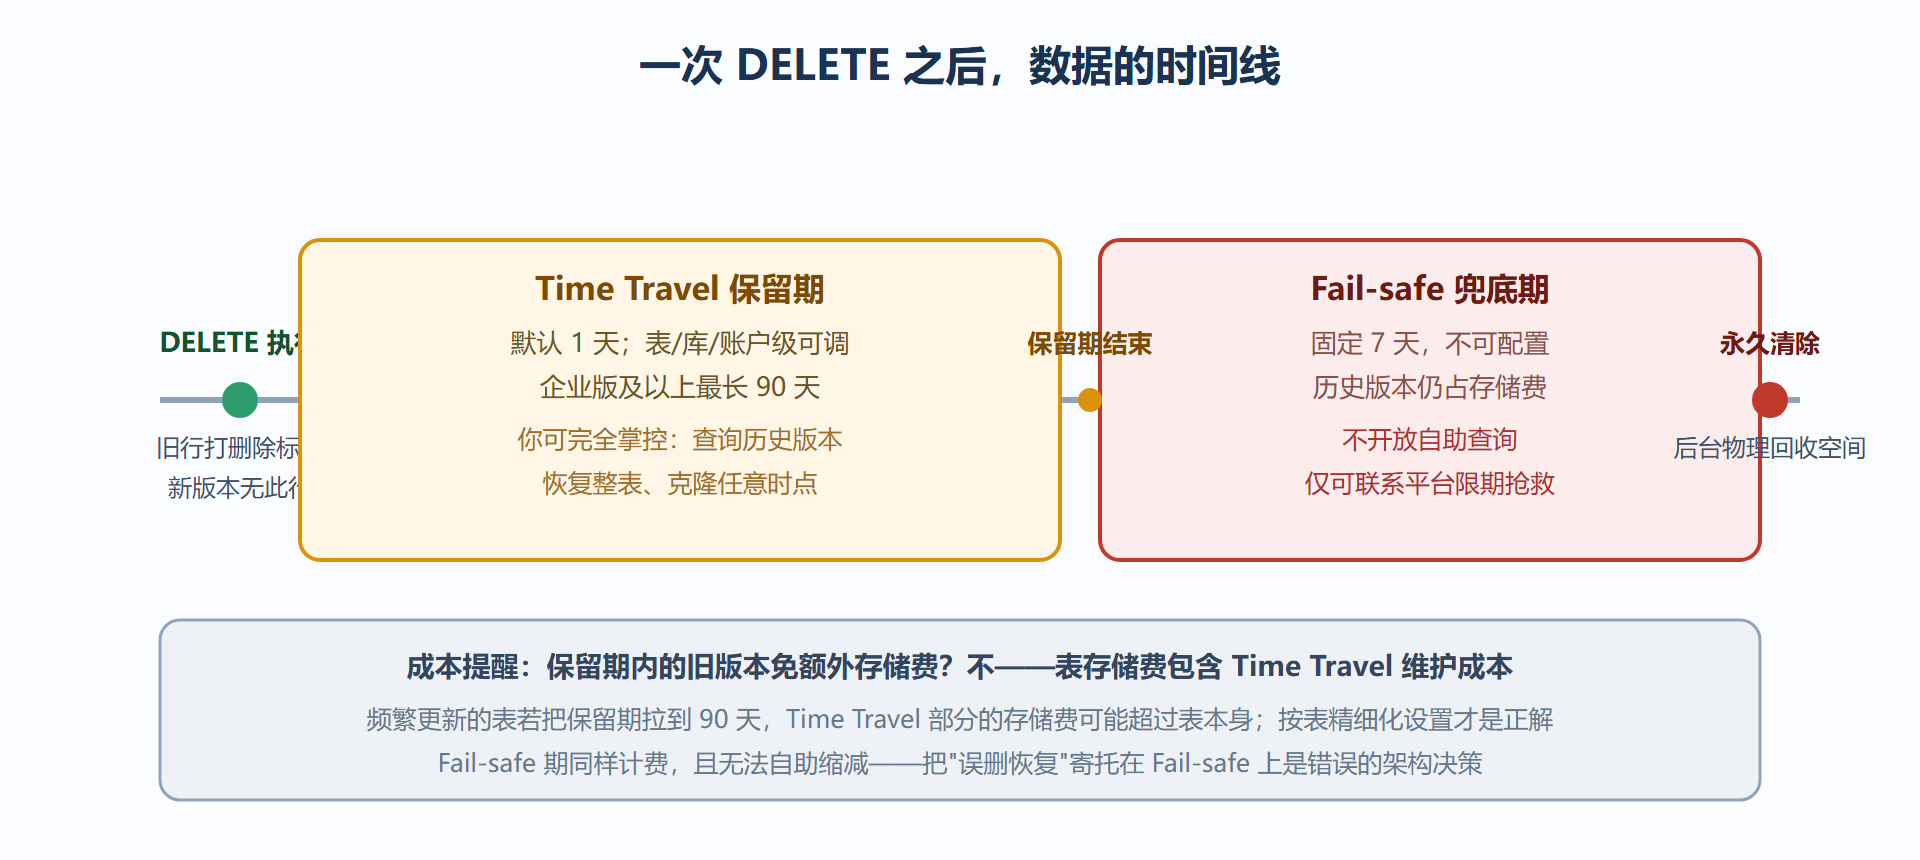
承上启下:4.2 结尾留了个悬念——被标记删除的旧数据去哪了。答案是一条时间线:数据的新旧版本在保留期内同时存在,靠版本元数据区分可见性。这条时间线有两段性质完全不同的区间,先看全景:
图:Time Travel 与 Fail-safe 时间线
三个动词:查、救、复
Time Travel 的全部用法围绕三个动词展开,语法核心是 AT 与 BEFORE 两个关键字。
动词一:查历史。 给普通查询加上时间定位子句:
-- 查一小时前的数据状态 SELECT * FROM orders AT (OFFSET => -60 * 60); -- 查某时间点之前的状态(常用于复盘事故时刻) SELECT * FROM orders BEFORE (TIMESTAMP => '2024-06-01 03:30:00'::TIMESTAMP); -- 对比"现在与一小时前"的差异:小时前存在、现在已不在的行,用 MINUS 最直接 (SELECT * FROM orders AT (OFFSET => -3600)) MINUS (SELECT * FROM orders); -- 结果 = 一小时前存在、现在已不在的行
动词二:救数据。 误删表有 UNDROP,误改表可以克隆修复:
-- 表被 DROP 了?只要在保留期内,一条语句复活 UNDROP TABLE orders; -- 表被错误 UPDATE 污染?把干净时点克隆出来再换名 CREATE TABLE orders_recovered CLONE orders BEFORE (STATEMENT => '0123abcd-0000-9a20-0000-4d8200012345'); ALTER TABLE orders SWAP WITH orders_recovered; -- 原子交换,业务无感
动词三:复制状态。 零拷贝克隆(Zero-copy Cloning)是 Time Travel 的近亲:
-- 秒级克隆整库,用于测试环境快照 CREATE DATABASE dev_snapshot CLONE prod_dw; -- 克隆出的库与源库底层共享微分区文件,此刻不产生额外存储 -- 之后 dev_snapshot 上的任何修改才产生增量文件
克隆要注意一个常见误解:克隆后两边共享历史文件,但从此各自独立演化——在克隆库写入只影响克隆库,源库无感知;反过来源库更新也不会出现在克隆库。它是"分家",不是"同步"。
保留期设置:一刀切是坏实践
DATA_RETENTION_TIME_IN_DAYS 可在账户、数据库、表三级设置,低级别覆盖高级别。经验法则按表的更新频率分档:
| 表的类型 | 建议保留期 | 理由 |
|---|---|---|
| 高频更新的贴源/ODS 表 | 0 到 1 天 | 版本更迭极快,留长了全是存储费 |
| 核心维度表 | 1 到 7 天 | 误改恢复窗口够用 |
| 月末结算等关键事实表 | 7 到 30 天 | 对账与审计需要回溯 |
| 强合规要求的少数表 | 30 到 90 天 | 有明确审计条款再开长窗 |
⚠️ 常见坑:把整个账户级保留期设成 90 天"图省心"。结果是所有高频写入表的 Time Travel 存储费成倍膨胀,而真正需要长窗口的只有几张表。正确做法是账户默认 1 天,按表逐个上调。
Fail-safe 则没有任何参数可调——它就是 7 天,是平台为自己保留的"最后的锅盖",用于极端灾难场景的数据恢复服务,用户无法查询其中的数据。把 Fail-safe 写进你的恢复预案,等于把恢复寄托在一个不可控的流程上;恢复预案的主角永远是 Time Travel 与下游备份。
本节要点回顾
- 版本机制:删改不覆盖数据,旧版本在保留期内物理存在——4.2 不可变性的直接收益。
- 三个数字:默认保留 1 天、可调最长 90 天、Fail-safe 固定 7 天。
- 三个动词:AT/BEFORE 查历史、UNDROP/克隆救数据、克隆复制状态;SWAP 支持原子换表。
- 成本边界:保留期越长存储费越高;按表分档设置,别账户级一刀切。
关系数据的时间维度讲完了。但现实中大量数据生来就没有固定列结构——下一节看 VARIANT 如何把 JSON 变成一等公民。
与传统"闪回"能力的对照
老牌数据库的闪回功能通常有时间窗口限制、依赖撤销表空间、且对 DDL 无能为力。Snowflake 的版本机制建立在微分区不可变之上,三个实用差异:一是粒度到整库——克隆与恢复可以作用于数据库、模式、表任意层级;二是 DROP 也覆盖——UNDROP 直接复活被删表,这在多数数据库是不可想象的;三是配置即成本——保留期每一天的延长都对应真实存储,因此它是按表的业务决策而非全局技术参数。
一个保留期与Stream的联动案例
某团队把核心表保留期从 1 天调到 30 天用于审计,随后 5.2 的 Stream 报"过期失效"。原因:Stream 的偏移量依赖源表的历史版本,表保留期反而被某个作业改回了 1 天,偏移量窗口失守。这个案例的启示:保留期不只是"回滚保险",它是 CDC 链路的地基;调整任何表的保留期前,先查有没有 Stream 挂在上面。
把 Time Travel 用进日常流程
回滚只是 Time Travel 最戏剧化的用法,日常化之后它的价值更大。三个被验证有效的常规化场景:其一,发布前的对账留痕——每次上线前对关键表克隆一个时点快照,出问题不必回滚整个发布,直接与快照做 MINUS 对比定位变更行;其二,数据质量巡检——对同一张表取昨天的 AT 视图与今天对比,波动超阈值的表进入待检清单;其三,实验环境自服务——数据科学家用克隆语句自建实验库,不占用生产存储(克隆在写入前几乎免费)。
流程化的反面是滥用:克隆出的实验库忘记清理,几个月后存储账单上多出几十个"僵尸克隆"。给克隆命名加统一前缀、在周报里统计克隆数量、给非生产克隆设定口头寿命——治理克隆与治理共享、治理权限一样,都是"机制便宜、纪律昂贵"的典型。