5.4 生态工具链与集成版图
5.4 生态工具链与集成版图
本节摘要:Snowflake 自己不做 ETL、不做 BI、不做调度——它的策略是把每一个环节开放给生态,自己守住存储、计算与治理三件事。本节给出一张"接入位图":连接器与驱动决定了谁能连、SQL API 决定了程序怎么连、Partner Connect 决定了主流工具多快接上、dbt 与现代数据栈如何围绕这套架构组织。读完你应当能为自己的技术栈标出每一个工具的接入位置。
平台自己站在哪
先定位平台自身:前四章讲的存储、仓库、共享、管线是 Snowflake 亲手做的部分;除此之外的采集、建模管理、可视化、编排,全部交给生态工具,通过标准接口挂接。这个分工决定了学习重点:接口协议比某个具体工具的用法更长寿。
接口层从底层往上数有四类:
- 连接器与驱动:Python、JDBC、ODBC、Go、.NET、Node.js,各语言生态的标准姿势;
- SQL REST API:不依赖驱动的 HTTP 提交与取数方式,适合受限网络或轻量集成;
- 对象级集成:暂存区直连对象存储(4.1)、外部表、外部访问集成(5.3),让数据与代码进出不经过额外网关;
- 生态目录:平台控制台内置的 Partner Connect,主流工具一键开通试用绑定。
接入位图:你的工具挂在哪里
把常见工具按其在数据流中的位置排开,接入关系一目了然:
图:生态工具链接入位图
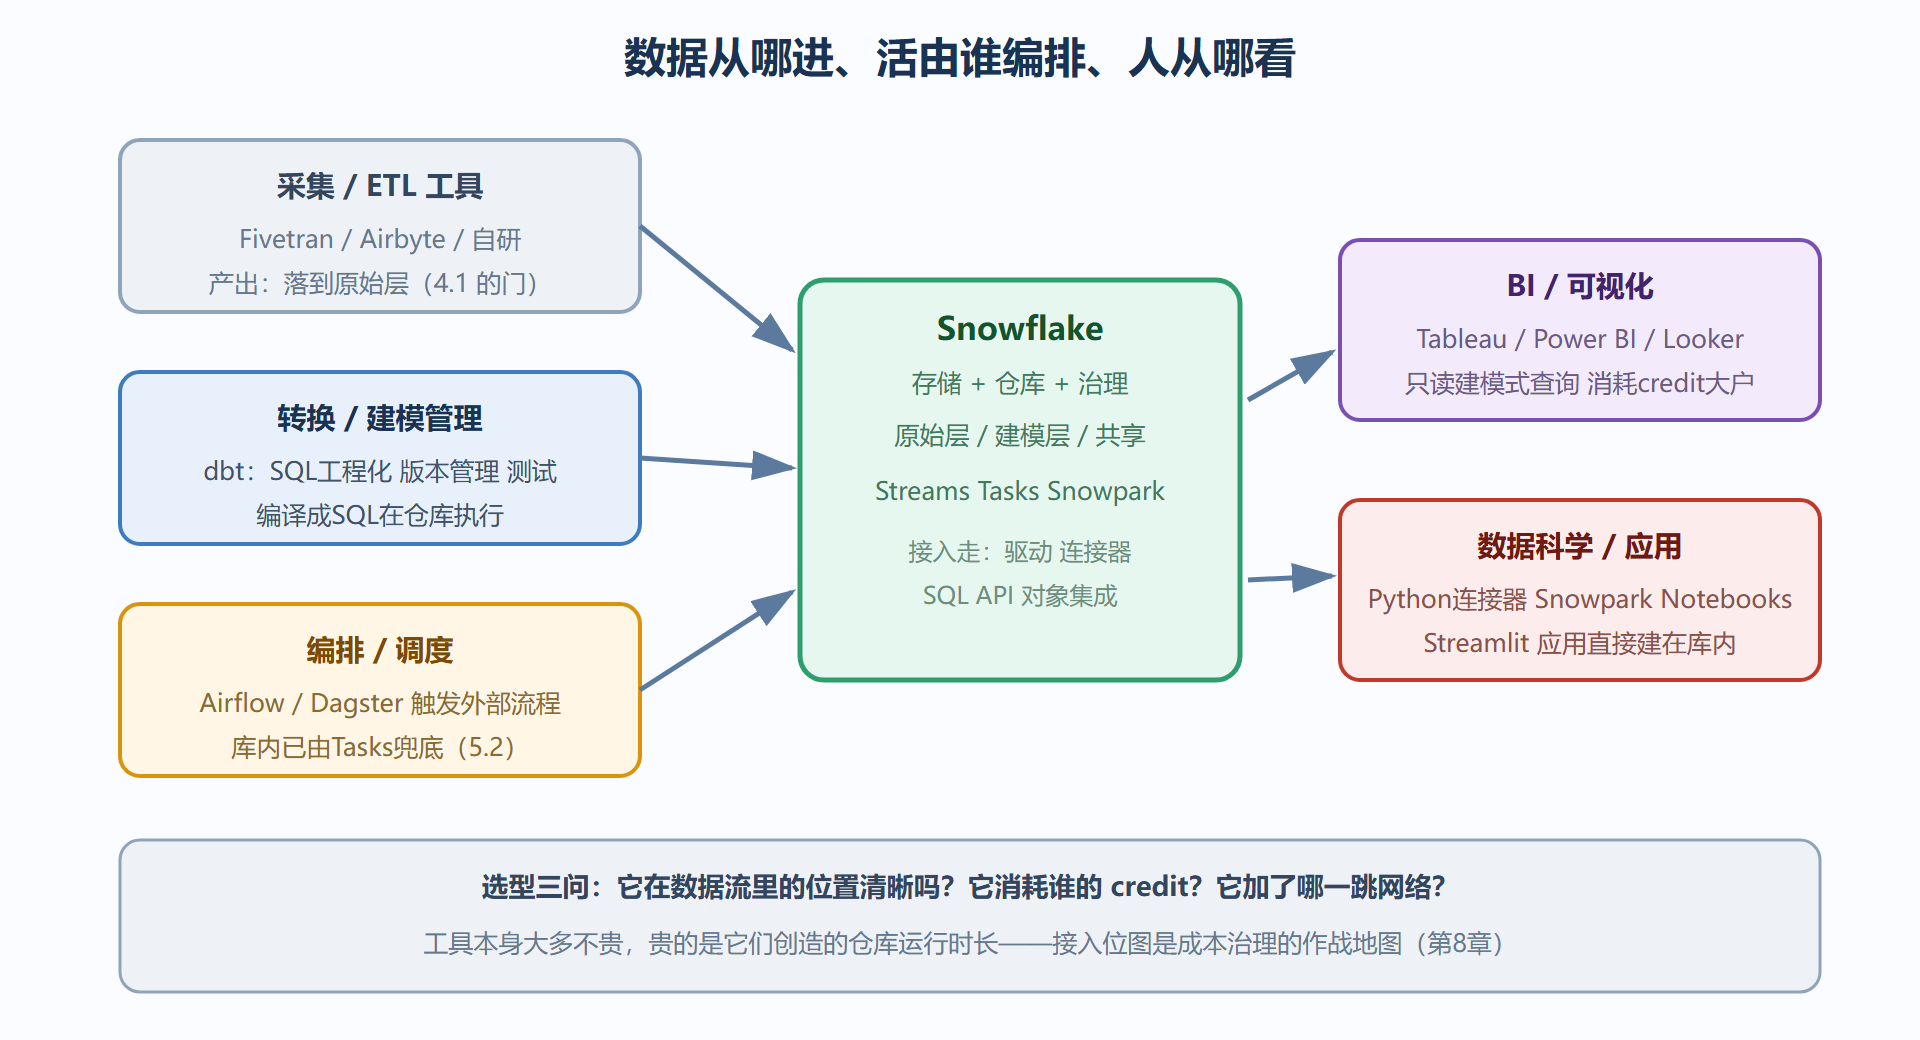
两类高频接入的深入观察
dbt 与"SQL 工程化"。 dbt 的价值是把建模层 SQL 变成可测试、可版本化、有依赖图的工程项目:模型文件编译成 SQL 后直接提交给 Snowflake 执行,物化策略(视图/表/增量)映射到 CREATE 与 MERGE 语句。它与 5.2 的 Tasks 并不冲突——dbt 管"模型的定义与依赖",Tasks/Snowpipe 管"运行时机",实践里常见 dbt 生成模型、由外部编排触发 dbt 作业的分工。选型判断:团队 SQL 能力强、模型间依赖复杂,dbt 收益显著;几个分析师写写临时查询,杀鸡用牛刀。
BI 工具与"credit 大户"。 BI 是多数账户 credit 消耗的第一名,原因不是报表多,而是仪表盘的自动刷新与筛选器抖动:每个看板组件一条查询、每人每小时轮询一次,叠加起来就是仓库整日不眠。治理手段都在前面章节出现过:报表单独一个仓库(3.2 负载分仓)、查询结果缓存命中(第6章)、聚合表预先算好(5.2 的 agg 层)。BI 接入是生态问题,账单却是架构问题。
程序侧接入的最小示例
# Python 连接器的最小读取示例:应用侧最常见的只读查询 import snowflake.connector conn = snowflake.connector.connect( account="myorg-myacct", user="svc_app", password="***", # 生产建议密钥对认证或 OAuth warehouse="app_wh", database="app_db", schema="public", ) cur = conn.cursor() cur.execute("SELECT order_id, amount FROM clean_orders WHERE city = %s", ("杭州",)) rows = cur.fetchall() cur.close(); conn.close()
程序接入的三条纪律:专用小仓库(app_wh 挂自动挂起,应用查询抖不进分析报表仓库);服务账号最小权限(只给需要的库表 SELECT,别拿人类账号跑程序);连接池复用(频繁建连的握手与认证开销可观)。
本节要点回顾
- 平台分工:Snowflake 守存储、计算、治理;采集、建模管理、BI、编排交给生态。
- 四类接口:连接器驱动、SQL REST API、对象级集成、生态目录;协议比工具长寿。
- 两大高频观察:dbt 管 SQL 工程化与运行时机解耦;BI 是 credit 大户,治理靠分仓与缓存。
- 程序三纪律:专用小仓库、服务账号最小权限、连接池复用。
到本章为止,"数据能进、能算、能流、能共享、能接工具"的正面清单已经齐了。下一章换负面视角:一条查询慢下来的时候,系统内部到底发生了什么。
接入反模式:把平台当文件服务器
生态接入最常见的反模式,是让平台沦为"大号文件服务器":应用侧把平台当缓存逐行点查、把导出文件当天级同步通道、用BI工具的直连当数据服务接口。三种行为的共性是让平台最不擅长的模式(高频小请求)承担最重的流量。纠偏方法是把接入归位:点查回缓存服务,同步走共享或管道,数据服务靠建模层加接口层。工具接入前先回答"它把哪种查询模式带进来",比比价更有价值。
工具升级与迁移的注意点
生态工具迭代快,两个经验值得留档。其一,驱动与连接器的版本要纳入变更管理:老驱动在平台新特性(新类型、新认证方式)上翻车的案例不少,升级平台特性前先核对驱动支持矩阵。其二,工具绑定要留退路:建模层 SQL 保持标准优先,工具专有语法集中收敛在少数配置层——生态的价值是可替换性,别用专有特性把退路焊死。
一次典型的"现代数据栈"落位
用一套常见的开源优先组合演示位图的用法:采集层用 Fivetran 托管连接器,把业务库增量同步到原始层(落位:4.1 的门,产出小文件多时注意合并规范);转换层用 dbt 管理建模 SQL,测试与文档随代码走(落位:编译成 SQL 消耗仓库 credit,模型越多批处理越长);编排层用 Airflow 触发 dbt 作业与数据质量检查(落位:库外触发,库内已有 Tasks 兜底轻量调度);消费层 Tableau 直连建模层(落位:credit 大户,配独立报表仓库与聚合表)。
这套落位图的价值在于暴露依赖与计费的传递链:采集文件的尺寸影响加载费用,dbt 模型的物化策略影响存储与重算时长,BI 的刷新频率影响报表仓库的运行时长。每个工具选型会议都应该带着这条链来开——工具的单价几乎都是小头,工具激发的平台用量才是大头。
自建与采购的分界问题
生态越繁荣,"哪些环节自己写"越需要原则。一条经过反复验证的分界线:与业务语义强耦合的环节自建(口径定义、敏感分级、成本归因),与业务语义无关的环节采购或用开源(文件传输、驱动、可视化渲染)。自建的部分沉淀为组织的数据资产,采购的部分享受生态进化红利;反过来——自己维护一个文件同步框架、同时把敏感分级交给外部工具的黑名单式配置——则两头都不占。