2.4 createMemo与useMemo:派生值的两种缓存哲学
2.4 createMemo 与 useMemo:派生值的两种缓存哲学
本节摘要:
useMemo在 React 里是性能提示——框架可能在下次渲染时丢弃缓存重算;createMemo在 Solid 里是响应式依赖图的真实节点——依赖不变就绝不重算,且自身可以被下游订阅。本节用一条购物车派生链并排演示,给出"什么时候根本不需要 Memo"的判断法。
结账页的需求很典型:购物车里每个条目有小计,整单有小计,小计过了门槛就免运费,最后算出应付金额。金额依赖于条目,条目依赖于数量,一条四层的派生链。这类"值依赖值"的计算,React 用 useMemo 包,Solid 用 createMemo 包——名字几乎一样,缓存哲学完全不同,值得用整节拆开。
先看 React 版本的派生链
function Checkout({ items, coupon }) { const subtotal = useMemo(() => items.reduce((s, it) => s + it.price * it.qty, 0), [items]); const discount = useMemo(() => coupon ? subtotal * coupon.rate : 0, [coupon, subtotal]); const shipping = useMemo(() => subtotal >= 99 ? 0 : 8, [subtotal]); const total = useMemo(() => subtotal - discount + shipping, [subtotal, discount, shipping]); }
这段代码能跑,但有两个藏在语义里的软肋。软肋一是缓存的"提示"属性:React 官方文档明说未来可能丢弃 useMemo 的缓存,它存在的意义是"帮渲染变快",不是"保证不重算"——一旦缓存被丢弃,依赖比对也要重做。软肋二是依赖数组又回来了:[coupon, subtotal] 这种手写清单,就是 2.2 节复盘过的那套心智负担,派生链每加一层,誊写清单就多一行,誊错一行,金额就错。
Solid 版本:链上每个节点都是订阅者
function Checkout(props) { const subtotal = createMemo(() => props.items.reduce((s, it) => s + it.price * it.qty, 0)); const discount = createMemo(() => props.coupon ? subtotal() * props.coupon.rate : 0); const shipping = createMemo(() => subtotal() >= 99 ? 0 : 8); const total = createMemo(() => subtotal() - discount() + shipping()); }
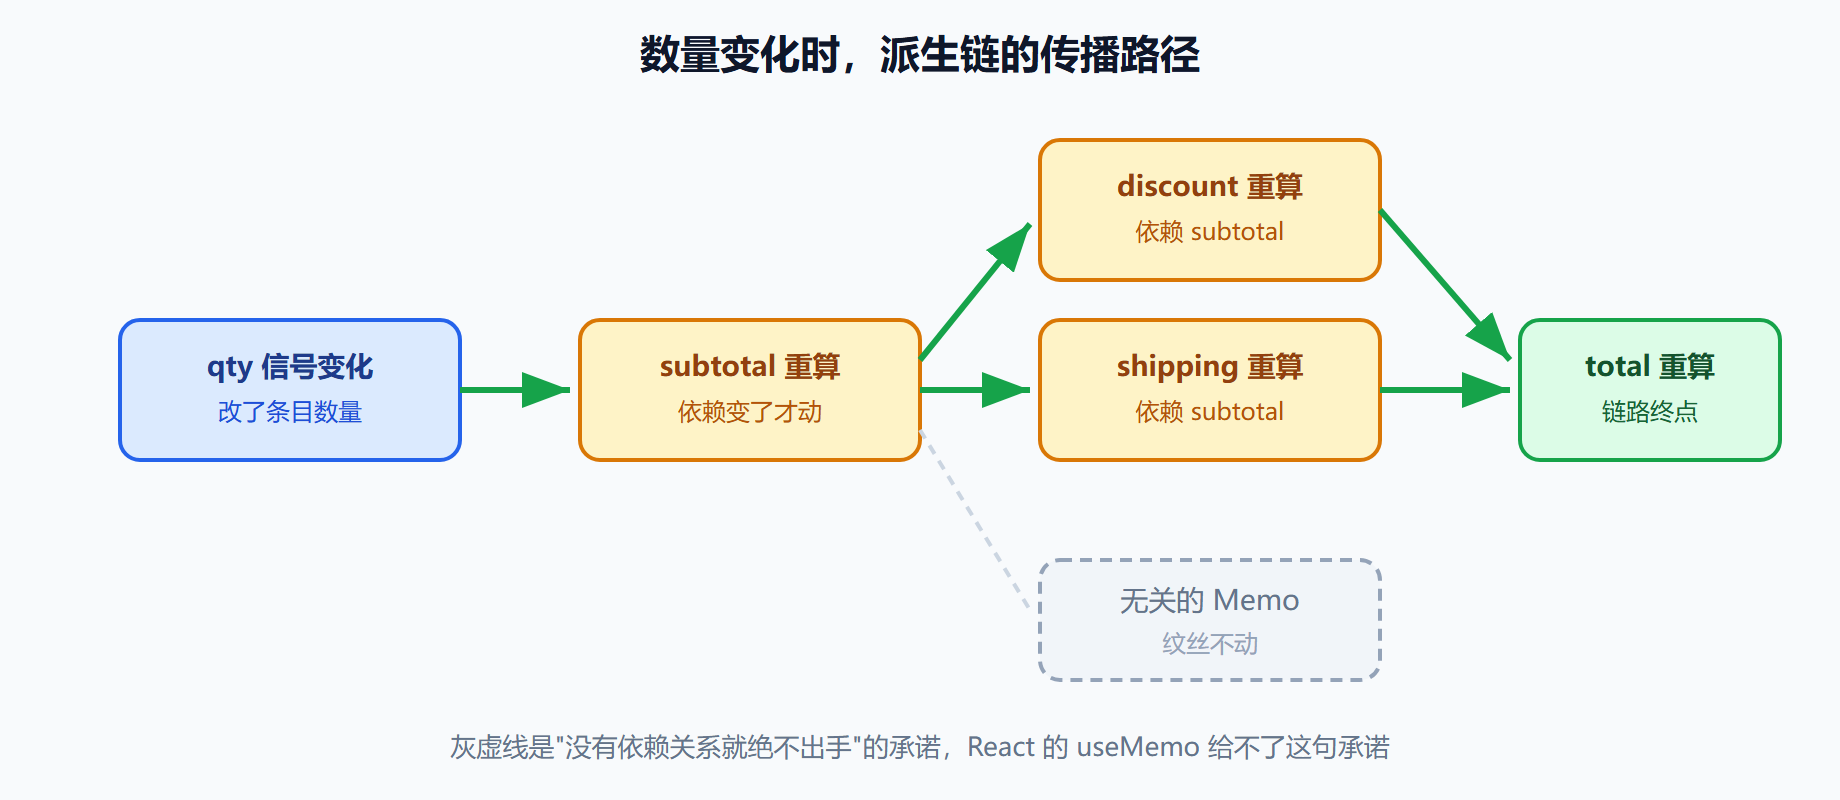
调用形状的差别小得可以忽略——没有依赖数组,仅此而已。机制差别却是本质的:discount 在首次执行时读到 subtotal(),从此成为这条派生链上的节点;subtotal 变化时,只有以它为依赖的 discount 与 shipping 被标记重算,total 再跟着 discount、shipping 走。数量从三改成五,整条链毫秒级收敛,全程没有"组件重渲染"这个概念掺和——派生值的更新与组件无关,这是与 React 最大的分野。
图:memo 派生链——信号变化沿链传播
对照表:提示与保证的分野
| 维度 | useMemo(React) | createMemo(Solid) |
|---|---|---|
| 依赖声明 | 手写数组 | 读取现场自动登记 |
| 缓存语义 | 性能提示,可能失效重算 | 依赖图节点,依赖不变必不重算 |
| 失效方式 | 引用比对失败或缓存被丢弃 | 上游信号实际变化 |
| 下游能否订阅它 | 不能,只是本次渲染的局部值 | 能,Memo 本身是可订阅的信号 |
| 是否影响重渲染范围 | 不影响,组件照样整体重跑 | 不存在重渲染,更新只在链上传播 |
表里"下游能否订阅"一行经常被低估。React 里 useMemo 的结果只在本次渲染有意义,传给子组件还得走 props 重渲染的老路;Solid 里 Memo 挂在依赖图上,任何组件、任何 Effect 都能直接消费它,天然就是"共享计算值"。这也让 Vue 用户倍感亲切——computed 与 createMemo 语义几乎重合,连"缓存基于响应式依赖自动失效"的保证都一致。
什么时候根本不需要 Memo
Solid 里还有一个反直觉的事实:很多在 React 里必须 useMemo 的场景,到了 Solid 直接写普通函数就行。判断标准是"这个值被消费几次":只在 JSX 里用一次的表达式,写成内联调用即可——组件只跑一次,不存在"每次渲染都重算"的问题,缓存的收益本来就来自重复渲染,重复渲染没了,缓存的意义也随之消失。真正需要 createMemo 的信号有两个:同一个派生值被多处消费;计算本身重(大数组归并、复杂过滤排序)。
⚠️ 从 React 迁移最常见的冗余,就是把每个
useMemo机械翻译成createMemo。逐个问一句"它被消费几次、算一次多重",多数答案会让你删掉这行包装。
派生值的三种放法
购物车场景其实有三种组织派生值的方式,选错了不算错,但依赖图的形状差很多。放法一:全部内联——每个消费处重复写 props.items.reduce(...),计算重复、依赖边重复,图变宽。放法二:统一 Memo——本节的写法,一条派生链多个消费点共享,图最窄,重计算的默认选择。放法三:写进 store——setStore("total", computeTotal()),缺点是派生值变成了手维护的第二份状态,上游变了要记得同步,属于把响应式用回命令式,规范上应禁止(除非派生过程需要人工节流)。
三种放法的判断口诀:算一次用一次,内联;算一次多处用,Memo;想手动控制时机的,先怀疑自己是不是真的需要。Vue 用户可以把它压缩成一句:computed 的用法直觉在 createMemo 上全部成立,只是书写从模板指令换成了函数调用。
问题:Memo 链过长会不会有性能问题?
链长本身几乎免费——传播成本正比于边数,而边数就是真实的依赖关系数,没有隐藏放大系数。需要警惕的是链的形状而非长度:某条链的根部如果是一个高频变化的信号(比如鼠标位置),下游再便宜也会被冲刷得很勤。修法在根部做节流或合并(2.2 的 batch、或把高频源换成低频派生),而不是在链上层层加 Memo。
本节要点回顾
- 提示与保证:useMemo 可能被丢弃重算,createMemo 是依赖图上的真实缓存节点。
- Memo 可被订阅:它是共享计算值,不依附于任何单次渲染。
- 无重复渲染则少用缓存:内联表达式是默认,重计算或多处消费才上 createMemo。
- 派生链自证正确:依赖来自读取现场,不存在誊写错误。
至此状态层四大原语全部对照完毕。下一章转向组件本身——JSX 在两个框架里会被编译成完全不同的东西。