2.3 三库存储引擎对照
2.3 存储引擎对照:SQLite 的行存树、InnoDB 聚簇与 PostgreSQL 堆
本节摘要:同一个 employees 表,三个引擎给出三种落盘路线:SQLite 把表本身做成主键 B-Tree;InnoDB 按主键聚簇数据、二级索引叶子存主键值;PostgreSQL 把行堆进无序堆页、所有索引都指向物理位置。本节对照三条路线在点查、范围扫描、写入放大上的差异,并回答"为什么 PostgreSQL 没有聚簇索引依然很快"。
三种落盘方式
建表语句在三个引擎里可以一字不差:
CREATE TABLE employees ( id INTEGER PRIMARY KEY, name TEXT NOT NULL, dept_id INTEGER NOT NULL, salary REAL ); CREATE INDEX idx_emp_dept ON employees(dept_id);
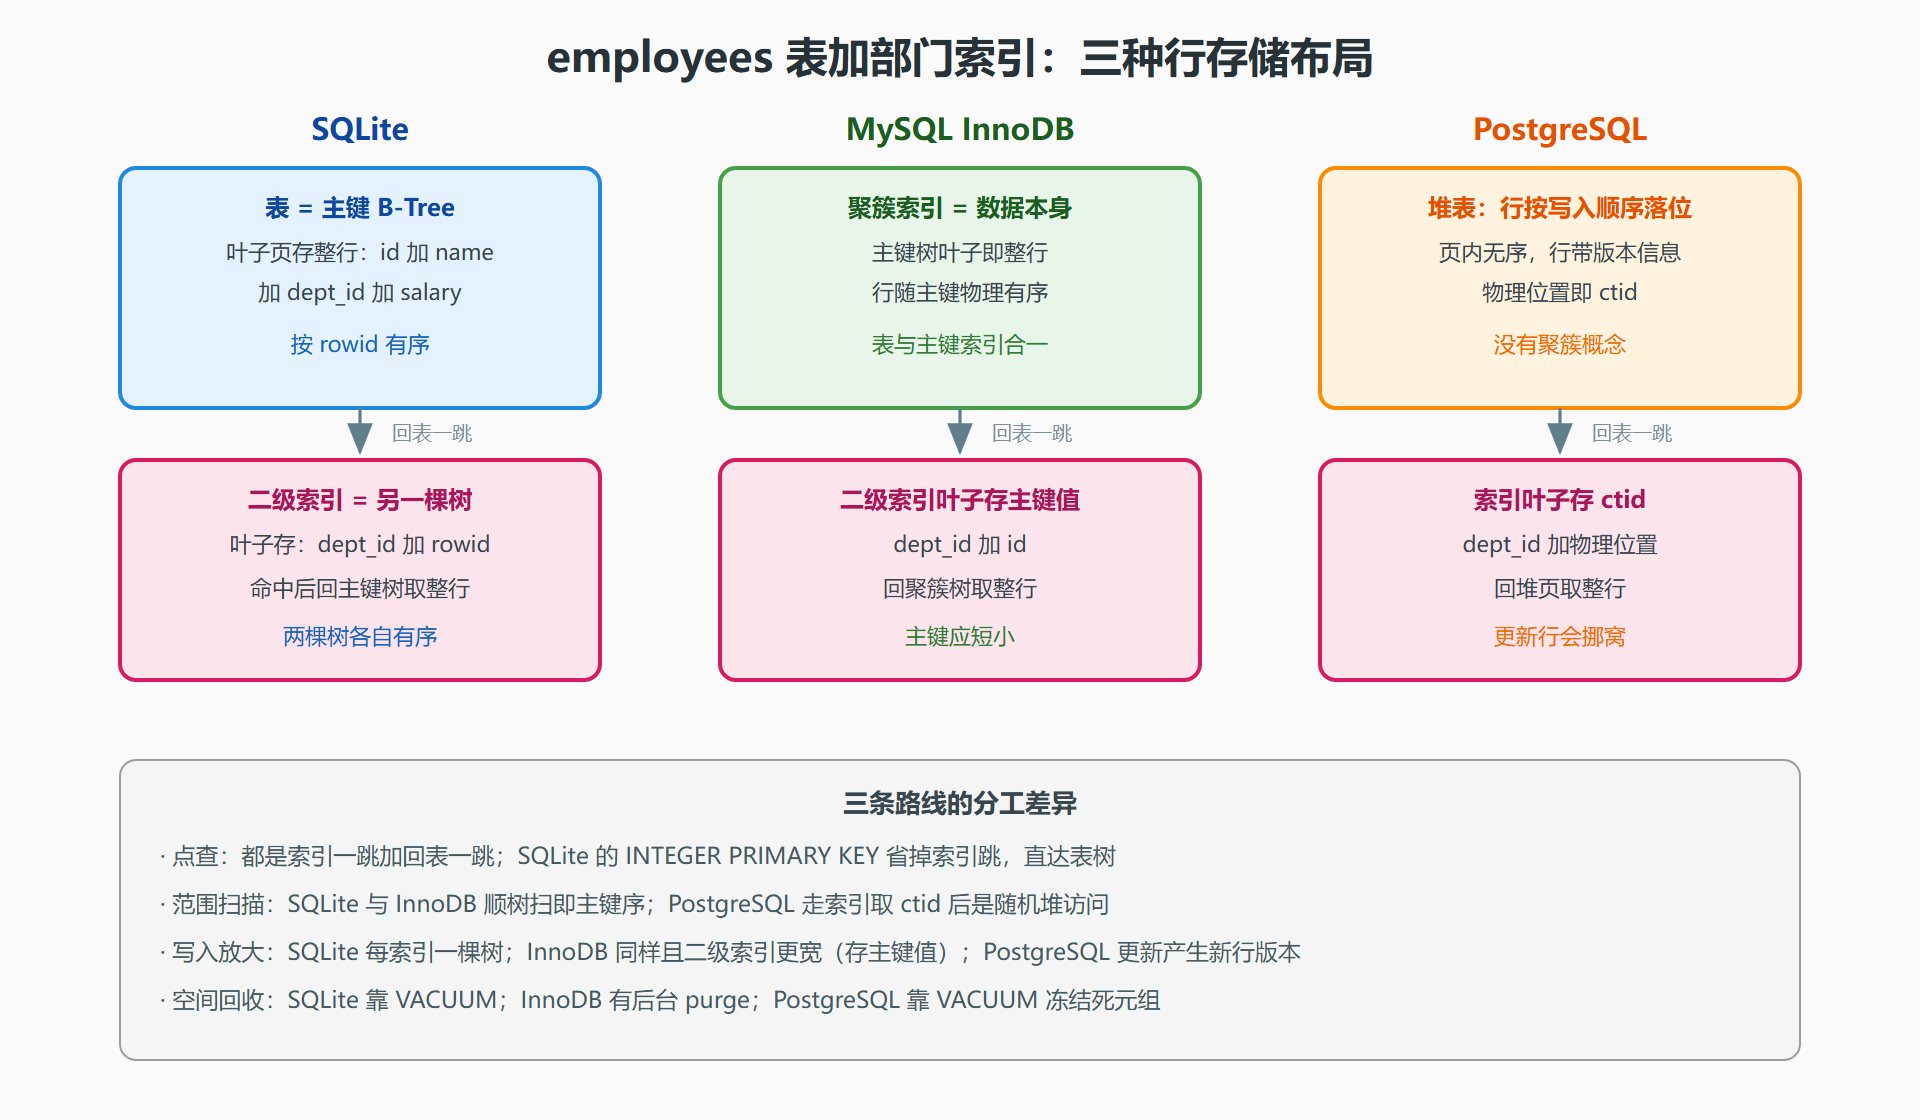
但这句话背后发生的事情完全不同。SQLite:employees 表本身是一棵按 id(即 rowid)组织的 B-Tree,叶子页存整行;idx_emp_dept 是另一棵独立 B-Tree,叶子单元格存"dept_id 值加 rowid"。InnoDB:employees 表按 id 聚簇——整行数据就挂在主键树上;idx_emp_dept 的叶子页存"dept_id 值加主键值 id"。PostgreSQL:employees 是一堆无序堆页,行按写入顺序落位;idx_emp_dept 的叶子项存"dept_id 值加 ctid(物理页号加行内偏移)"。
图:同一张表的三种行存储布局
同一条查询的三份计划
查"技术部所有员工",三个引擎的优化器输出直接反映了布局差异:
SELECT name, salary FROM employees WHERE dept_id = 3; -- SQLite(EXPLAIN QUERY PLAN) QUERY PLAN `--SEARCH employees USING INDEX idx_emp_dept (dept_id=?) -- 字节码随后按 rowid 回表树取 name 与 salary -- MySQL +----+-------+---------+------+---------------+--------------+-------+ | id | type | key | ref | rows | Extra | +----+-------+---------+------+---------------+--------------+-------+ | 1 | ref | idx_emp_dept | const | 28 | NULL | -- InnoDB 在 dept_id 索引叶子里拿到 id,回聚簇索引取行 -- PostgreSQL Index Scan using idx_emp_dept on employees Index Cond: (dept_id = 3) -- 从索引拿 ctid,再回堆页取行
三份计划惊人地相似——都走 dept_id 索引再回表——因为"过滤列在索引里、输出列不在"这一点在哪个引擎都一样。差异藏在回表的成本结构里:SQLite 与 InnoDB 的回表是另一棵树的有序查找,而 PostgreSQL 的回表是按物理地址访问可能分散在任何地方的堆页。当命中的行数很大时,PostgreSQL 的随机堆访问会越来越贵,优化器会在某个比例后干脆放弃索引改走顺序扫描——这个"改主意"的临界点在另外两家也存在,只是形态不同。
写入侧的账
插入一批新员工时:SQLite 更新表树加一棵索引树;InnoDB 更新聚簇树加一棵二级树,还要写重做日志;PostgreSQL 在堆里追加新行版本、更新索引项,死版本留给 VACUUM。粗略地说,每多一个索引就多一棵要维护的树,这在三库成立,只是"树"的内部结构不同。给嵌入式场景的推论很直接:SQLite 表的索引数量要按写入 QPS 反推,写入密集的日志型表通常一个索引都嫌多,读多写少的查询型表才配得上四五个索引。
PostgreSQL 有一条独门优化值得知道:如果更新的列不涉及任何索引且新版本放得进原页(HOT 更新),它可以不动索引。SQLite 没有对应机制——任何行的更新都要维护全部相关索引树,这是"嵌入式引擎用最简单机制换确定性"的又一例。
常见问题速答
**PostgreSQL 的 CLUSTER 命令是聚簇索引吗?**不是。CLUSTER 按某个索引把堆表物理重排一次,之后新插入的行依旧按写入顺序落位,物理有序性随即逐渐退化——它是一次性整理,不是持续的组织原则。SQLite 的 WITHOUT ROWID 与 InnoDB 聚簇是"表结构本身即树",永不退化;三者的差异在"性质"而不在"效果"。从 PG 迁到 SQLite 时不要试图用定期 CLUSTER 模拟聚簇,直接选对表形态。
**迁移时主键怎么选?**三步判断。第一步问主键是否是自增整数:是,用默认 rowid 表,主键声明为 INTEGER PRIMARY KEY 即可拿到 rowid 别名红利。第二步问主键是否是业务字符串(编号、UUID):高频按主键点查的表用 WITHOUT ROWID,省一次回表;否则保留 rowid 表加唯一索引。第三步问有没有大字段:无论哪种形态,大字段都建议出库或控制在页内阈值之下。UUID 注意点:随机 UUID 在任何按主键有序的形态(SQLite 的 WITHOUT ROWID、InnoDB 聚簇)里都会造成插入点随机分散、页分裂频繁,有序化处理(时间前缀)是三库通用的减震手段。
本节要点回顾
- 三种路线:SQLite 表即主键树、InnoDB 主键聚簇、PostgreSQL 堆加全二级索引;差异的本质是"行与主键的物理关系"。
- 回表成本形态不同:树查找(SQLite、InnoDB)对物理寻址(PostgreSQL),大数据量范围扫描时 PostgreSQL 优化器会倾向顺序扫描。
- INTEGER PRIMARY KEY 是 SQLite 的特殊红利:主键即 rowid,点查直达表树。
- 写入放大的通用法则:每索引一棵树;SQLite 没有 HOT 更新式的豁免,索引数量要克制。
**为什么 InnoDB 主键要短小?**因为每个二级索引叶子都重复存一份主键值——主键越长,所有二级索引跟着膨胀,这是聚簇路线的隐性税。UUID(36 字节文本形态)做 InnoDB 主键的表,二级索引体积可能翻倍。SQLite 的 rowid 路线没有这笔税(二级索引存的是紧凑 rowid),但 TEXT 主键表在 WITHOUT ROWID 形态下同样要面对它。结论跨库通用:主键用小的整数自增值,业务编号交给唯一索引。