2.1 为什么自回归生成绕不开 KV Cache
2.1 为什么自回归生成绕不开 KV Cache
本节摘要:「KV Cache」是理解大模型推理开销的钥匙词。本节从注意力机制的计算依赖出发,说明 decode 每一步为什么必须读取全部历史 token 的键与值;再用代码与算例展示 KV Cache 随序列长度线性增长的事实。结论是:这笔显存开销无法省略,只能优化管理——这为第 2.2 节的"浪费账本"与第 3 章的块表设计立好了前提。
「KV Cache」这个词组在 vLLM 的日志里出现频率最高:它启动时预留、运行中告警、优化的每个环节都围着它转。可是它到底缓存了什么?为什么删不掉?本节就回答这两个问题——它们是显存困境的起点,也是后续所有章节的技术地基。上一章支柱页交代了"显存缺口"的现象,本节往下挖一层,看这个缺口里的必要开销部分从何而来。
注意力的依赖链:每个字都要"回看"所有字
Transformer 解码器生成第 t 个 token 时,注意力机制要做的事情是:拿当前 token 的查询向量(Query),与序列中全部 t 个位置的键(Key)做相似度计算,再按相似度加权求和对应的值(Value)。也就是说,第 t 步的输出依赖前面所有位置的 K 与 V。
关键在于:这些 K、V 是每个位置经过每一层网络算出来的,而且一旦算出就不会变——位置 5 的键值不因为后面生成了新 token 而改变。于是有一个自然的优化想法:把每层、每个位置的 K、V 算完就存起来,下一步直接读,不要重算。这份存起来的张量就是 KV Cache。
不缓存行不行?行,代价是每生成一个 token 都要把之前所有位置的 K、V 全部重新计算一遍。总计算量随序列长度平方增长——生成一千个 token,就要重复算几十万次位置的键值投影。在 decode 这种本就每步只能前进一个位置的模式下,这种重算完全不可接受。所以工程上的共识是:用显存换计算,把这笔状态固化下来。
关键直觉:KV Cache 是"用空间换时间"的交易凭证。交易本身没有退出选项——不想要平方级的重复计算,就必须接受线性的显存开销。工程能优化的从来不是"要不要付",而是"付出去的空间有没有被浪费"。
显存里的形状:它到底有多大
KV Cache 按层存放,每层两份张量(K 与 V),形状都是 序列长度 × KV 头数 × head_dim。全模型合计:
KV Cache 字节数 = 2(K 和 V 两份) × 层数 × KV 头数 × head_dim × 精度字节数(FP16 为 2) × 序列长度 × 批内请求数
用 PyTorch 的形状语言描述单个请求、单层、一步 decode 后的缓存:
import torch L, H_kv, d_head = 32, 8, 128 # 层数、KV 头数(GQA 后)、每头维度 past_len = 1024 # 已生成的序列长度 # 单层 KV Cache:键与值各一份 k_cache = torch.zeros(1, H_kv, past_len, d_head, dtype=torch.float16) # 1 是批维 v_cache = torch.zeros_like(k_cache) per_layer_bytes = k_cache.numel() * 2 # FP16 每元素 2 字节 total_gb = per_layer_bytes * L * 2 / 1024**3 # 全模型 32 层、K/V 两份 print(total_gb) # ≈ 0.125 GB —— 单请求、1024 token 上下文
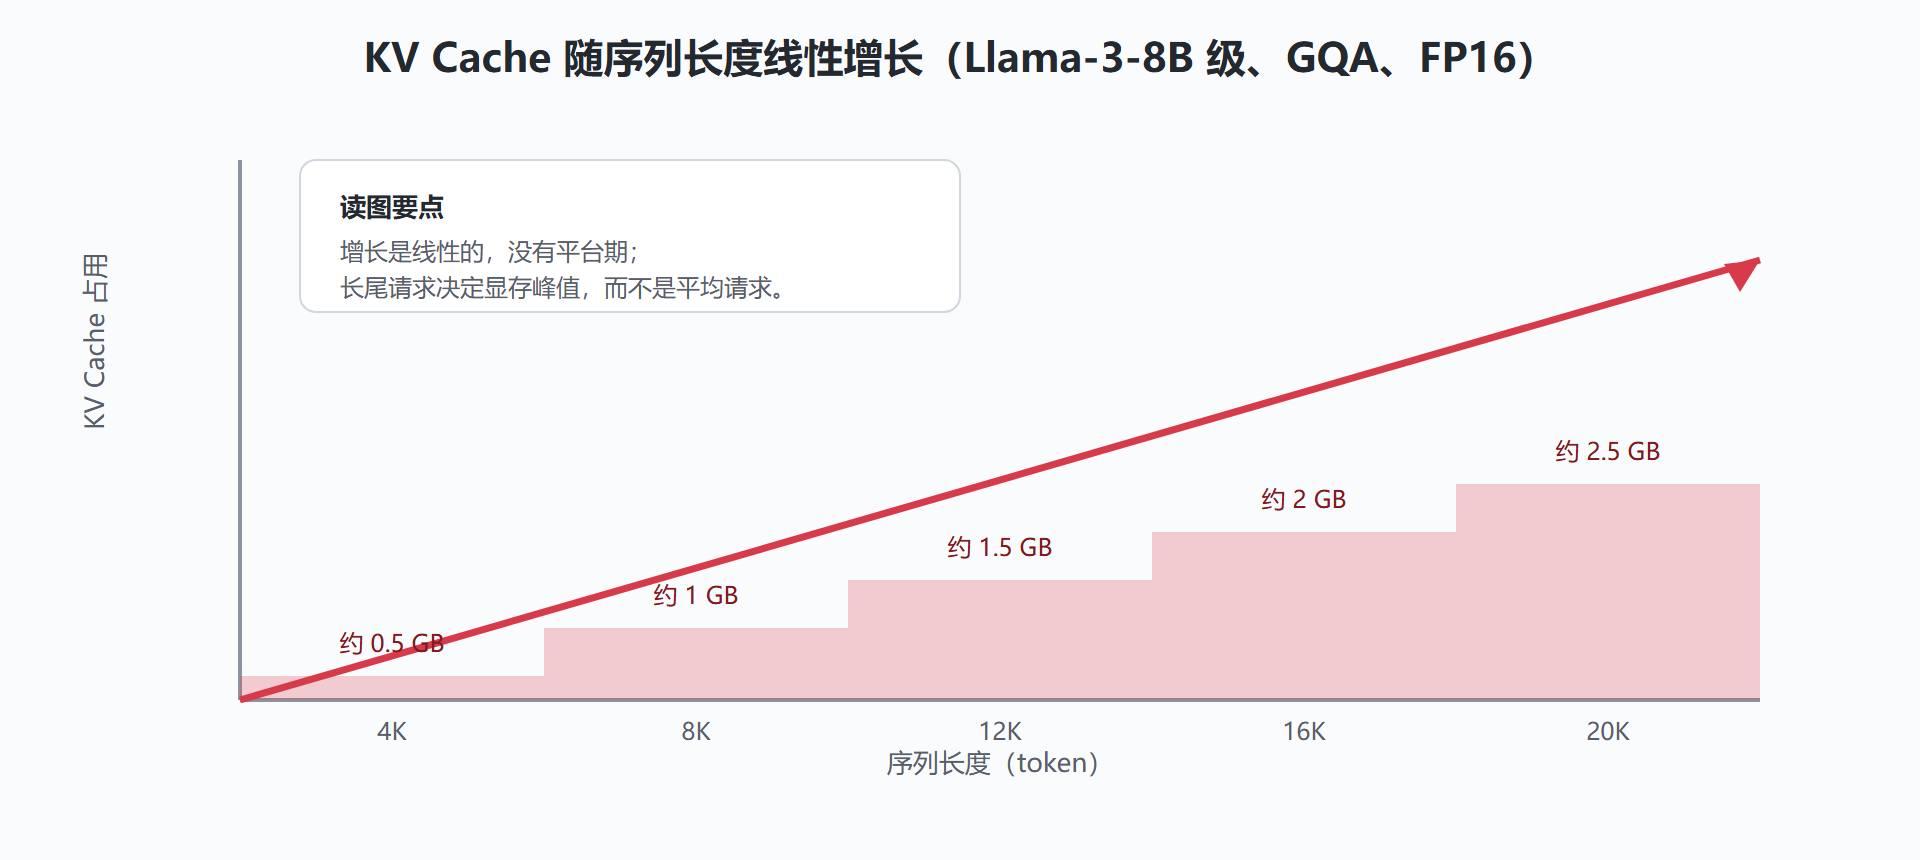
把数字放大到有体感的规模:同样这个模型,一条 32K 上下文的请求要占 4 GB KV Cache;若部署 70B 级大模型(层数与头数更多),单条长上下文请求的 KV Cache 可达十几 GB——比很多小模型整个权重还大。序列长度每翻一倍,KV Cache 翻一倍,这就是长上下文服务贵的算术根源。
图:KV Cache 随生成步数线性膨胀
模型架构已经在帮倒忙或帮忙:MHA 与 GQA
公式里的"KV 头数"一项值得单独说。最早的注意力设计(MHA,多头注意力)里,KV 头数等于查询头数——8B 模型是 32 个头,每个头都要留一份键值。后来的模型普遍改用 GQA(分组查询注意力):若干个查询头共用一组键值头,KV 头数从 32 降到 8 甚至更少,KV Cache 直接缩到四倍之一;MQA 更激进,全部查询头共用一组,缩得更多。
这个架构层面的选择说明:业界早就认识到 KV Cache 是核心成本,在模型设计阶段就开始为它瘦身。但架构优化解决的是"单价",解决不了"管理"——只要缓存还在按最坏情况预留、按连续整块分配,浪费依旧。管理问题留给第 3 章,我们先把 2.1 的结论钉死:
一个常见误区:把 KV Cache 当成"可以定期清理的缓存"
后端工程师听到"缓存"两个字,容易想到 Redis 那套心智:设个过期时间、容量满了就淘汰。KV Cache 完全不同——它不是性能优化项,而是正确性依赖:decode 每一步的注意力都需要全部历史的键值在场,丢任何一块,后续生成的分布就不再是这个模型的输出。所以推理系统里不存在"清理 KV Cache 换性能"的选项,只有"请求结束后整体归还"这一种回收时机。
这也解释了为什么显存管理如此重要:KV Cache 是必须常驻的工作集,而不是可以随意挤占的软资源。块池的每一块在请求存续期间都是"刚性债务",唯一能做的是让每单位债务占用更少的空间(量化缓存)、被更多请求共享(前缀共享),以及不留死账(按需分配)。
与训练侧的对照:为什么推理对显存更敏感
做过训练的同学会发现一个有趣的对照:训练时显存大头是激活值与优化器状态,批次大小可以随显存伸缩;推理时权重是常量、激活很小,显存的弹性部分几乎全部是 KV Cache,而它正比于并发与序列长度——恰好是服务的两个核心指标。这个对照解释了为什么推理服务的容量规划比训练任务更精细:训练慢一点只是等,推理显存不够是直接拒绝用户请求。
本节要点回顾
- KV Cache 缓存的是每层每个位置的键与值,因为 decode 每步的注意力都要回看全部历史,而历史位置的键值不会再变。
- 不缓存的代价是平方级重复计算,所以"显存换计算"是必选交易,能优化的只是这笔空间的使用效率。
- 显存公式六要素:两份张量、层数、KV 头数、head_dim、精度字节数、序列长度与批大小;序列长度是其中最不受控的一项。
- GQA/MQA 从架构上给 KV Cache 瘦身,头数降多少,缓存就缩多少。
- 长尾请求决定显存峰值:容量规划要按最长序列算,不能按平均数算。
必要性讲清了,下一节我们算另一本账:在"必要开销"之外,传统分配方式又额外浪费了多少显存。